目次
CodexとClaude Codeのどちらを使うかは、モデルの評判だけでは決まりません。普段の開発環境、渡せる情報、テストを動かせる場所、利用枠、レビューの進め方によって、扱いやすい組み合わせは変わります。両方を契約しても、毎回同じ仕事を二重に依頼する必要はありません。
この記事ではWeb開発者・サイト運営者を対象に、二つのサービスを中心とした選び方と、モデルの使い分け、併用、連携の実践案を整理します。情報確認日は2026年10月16日です。公式仕様と本サイトの運用上の提案を区別し、同条件での製品横断ベンチマークは実施していません。したがって、速度・正答率・品質の総合順位を示す記事ではありません。
スポンサーリンク
最初にエージェントとモデルを分けて考える
モデルは文章やコードを推論・生成する基盤です。エージェントは、モデルに指示を渡し、コードの検索、ファイル編集、コマンド実行、結果確認を繰り返す仕組みです。その周りに、IDE、ターミナル、Web画面、権限、履歴、料金体系があります。同じモデル名が見えても、渡される文脈や道具が違えば結果は変わります。
Codexはアプリ、CLI、IDE拡張などの入口を持ち、CLI・SDK・app-serverといった統合の選択肢があります。Claude Codeもターミナル専用ではなく、IDE、デスクトップアプリ、Webで利用できると案内されています。「GUIならCodex」「ターミナルならClaude Code」と二分すると、現在の選択肢を狭く見てしまいます。出典:OpenAI公式:Codexのハーネスと統合方法、Anthropic公式:Claude Code概要。
比較するときは、製品名、実際のモデル、推論設定、クライアントの版、実行場所、許可したツールを一組で記録します。「Claudeができた」「Codexが失敗した」だけでは、モデル差なのか、環境にテスト用の依存関係がなかったのかを切り分けられません。
主要な選択肢は作業の入口から比べる
| 選択肢 | 公式資料で確認できる入口・機能 | 選ぶときに見る点 |
|---|---|---|
| Codex | アプリ・CLI・IDE拡張とSDKなどの統合手段 | 普段の作業から実行・差分確認へ進めるか |
| Claude Code | ターミナル・IDE・デスクトップ・Web | 既存の開発手順と設定を扱いやすいか |
| Cursor Agent | エディターでのコード検索・編集・ターミナル操作など | 編集しながら細かく方向修正したいか |
| Gemini CLI | ターミナルでのコード理解とタスク自動化 | CLI中心の環境で導入・認証を管理できるか |
| GitHub Copilot | GitHub.comでの調査・変更の委任・PRレビューなど | IssueとPRを仕事の単位にしているか |
この表は機能の独占を示すものではありません。CursorにもCLIやクラウドの仕組みがあり、CodexやClaude Codeにも複数の入口があります。最初に「どこで作業を始め、どこで変更を確認したいか」を決めるための整理です。各機能の提供範囲は契約と組織設定で確認します。出典:Cursor公式:Agent概要、Google公式:Gemini CLIドキュメント、GitHub公式:GitHub.comでのCopilot。
スポンサーリンク
用途別の選び方は既存の作業で試す
| 用途 | まず試す構成 | 合否を判断する材料 |
|---|---|---|
| 小さな不具合修正 | 使い慣れたエディターかCLIで一つのエージェントを使う | 再現テスト・変更範囲・既存仕様への影響 |
| 複数ファイルの改修 | 実行環境と依存関係を揃えたCodexまたはClaude Code | 設計との整合・移行手順・回帰テスト |
| UI調整 | 差分と実画面を確認できる環境を用意する | 指定幅の表示・操作・キーボードでの利用 |
| 原因不明の障害調査 | まず読取中心で仮説と確認手順を出す | ログに裏付けられた説明・再現性 |
| 重要な変更のレビュー | 実装担当とは別のセッションや製品で読む | 再現可能な指摘・見逃した要件・修正後の検証 |
本サイトの提案は、最初から二製品を常時動かすより、繰り返し発生する三種類ほどの実務で比べることです。例えばWordPressの小さな修正、JavaScriptの不具合調査、既存コードのテスト追加を選びます。得意不得意は言語名だけで固定せず、既存のコード構成やテストの有無を含めて見ます。
デザインの良し悪しも、ブランドの印象で決めません。参考画面、禁止事項、余白、レスポンシブ条件を同じように渡し、実ブラウザーで判定します。端末やツールが違う条件で生成したスクリーンショットを比べても、モデルの能力だけを比較したことにはなりません。
Codexではモデルと推論量を別々に調整する
確認時点のOpenAI公式資料は、複雑なコーディングやエージェント作業でGPT-6.1 Sol、明確で反復的な処理でGPT-6 Lunaを挙げています。GPT-6 Astraは、より難しい一連の作業に向けた位置付けです。これは提供元の案内であり、本サイトが全製品に対する性能順位を実測した結果ではありません。
| 候補 | 本サイトで試す役割 | 切り替えの判断 |
|---|---|---|
| GPT-6 Luna | 範囲が明確な変換・抽出・小さな実装 | 複雑な前提を追えないなら上位候補で再検討 |
| GPT-6.1 Sol | 日常の実装や複数工程の作業の基準候補 | 難しい判断が残る部分を別モデルで確認 |
| GPT-6 Astra | 設計上の難所や複数制約を含む問題の検討 | 十分な結果が出るなら全作業へ広げない |
利用できるモデルは、サインイン方法、契約、クライアント、組織設定、展開状況で異なります。CLIでは/modelでモデルと推論の設定を変更できます。推論量を増やすと時間や消費量も増えるため、まず標準の設定から始め、仕様の衝突や難しい解析があるときに見直します。モデルを切り替えても、ファイルやツールの権限が増えるわけではありません。出典:OpenAI公式:モデルと選択方法。
スポンサーリンク
Claude Codeも一つのモデルだけではない
Claude Codeの公式設定には、日常の実装に向けたsonnet、複雑な推論に向けたopus、単純な処理に向けたhaikuというエイリアスがあります。さらに、難しく長い作業向けのfableや、計画時にOpus、実行時にSonnetへ切り替えるopusplanも案内されています。
確認時点のAnthropic API向け設定表では、opus・sonnet・haikuはそれぞれ5.5系を参照し、fableは通常Fable 5.1を参照します。ただし、提供基盤やゲートウェイ、クライアントの版によって参照先は異なります。エイリアスは固定のモデルIDではないので、比較結果を残す際は実際の版を記録してください。出典:Anthropic公式:Claude Codeのモデル設定。
運用案としては、日常の変更をSonnetなどの基準候補で始め、難しい設計や検証へOpusやFableを試します。単純な抽出を速い候補へ分ける考え方もあります。ただし、Codexの推論設定とClaude Codeの設定名を一対一に換算したり、両社のモデル階層が同じ品質を意味すると考えたりはしません。
両サービスを使う価値は別の見方を得ること
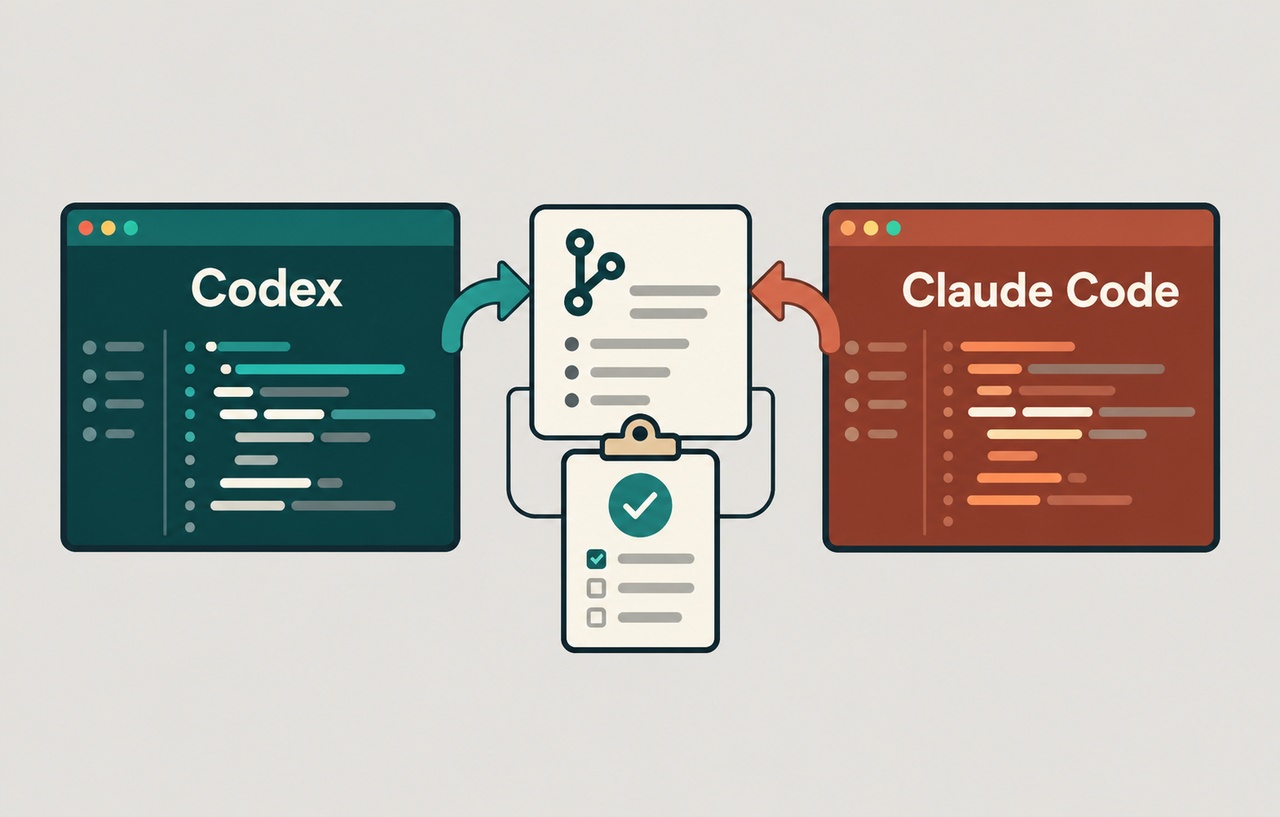
併用で狙いたいのは、同じ仕様への異なる解釈、別のテスト観点、見落とした制約の発見です。例えば、Codexで実装した差分をClaude Codeが読んで確認し、その逆も試す構成にします。「Codexが実装、Claudeが文章」と担当を固定する根拠はないので、実際に有効だった組み合わせを残します。
別のモデルでも同じ誤りをすることはあります。同じ不完全な仕様を渡せば、両方が同じ前提で答える可能性もあります。レビュー担当には実装者の説明をそのまま正解として渡さず、元の要件、差分、テスト結果を先に見せます。結論の一致より、独立して確認できる根拠を重視します。
併用が有効かどうかは、見つかった不具合、レビューの所要時間、不要な指摘の割合で見ます。一行の文言変更まで二段階のAIレビューへ回すと、引き継ぎの方が重くなる場合があります。認証、課金、データ移行、外部公開など、失敗の影響が大きい変更を優先する方法が現実的です。
連携はGitと引き継ぎメモから始められる
両サービスを使うために、最初からAI同士を直接呼び合う必要はありません。最も管理しやすい出発点は、実装者がコミットまたは差分を用意し、別の担当が同じ状態をレビューする方法です。会話履歴が自動共有されると期待せず、必要な情報を明示して渡します。
- 実装担当:目的、対象範囲、変更禁止箇所、受け入れ条件に沿って変更する。
- 引き継ぎ:基準コミット、対象コミット、実行した検証、失敗・未実行の項目を残す。
- レビュー担当:指定した差分を読み、再現条件と影響を伴う指摘を返す。
- 修正担当:指摘を検証し、採用した修正と採用しなかった理由を記録する。
- 最終確認:統合後の状態でテストし、公開やマージは決めた責任者が判断する。
同じ作業ディレクトリを二つのエージェントが同時に編集すると、未確定の変更や依存関係を互いに上書きするおそれがあります。別ブランチだけでは同時の作業場所を分離できないため、並行するなら別のworktreeやチェックアウトも用意します。各担当でテストが通っても、統合した状態の確認は必要です。
引き継ぎテンプレートを共通化する
次は本サイトが提案する記入用テンプレートです。リポジトリの規約や担当ツールに合わせて使い、秘密情報や本番データを含めないようにします。実行していない検証は「未実行」と書きます。
目的:
変更してよい範囲:
変更しない範囲:
基準コミット:
対象コミットまたは差分:
受け入れ条件:
実行したテストと結果:
未実行の検証と理由:
既知の懸念:
レビューで優先して見る点:
外部への書き込み・公開の許可範囲:
レビュー指示も具体化します。「よく見て」より、「新しいログイン状態と権限判定の境界を確認し、成立する不具合だけを、該当箇所・再現条件・影響とともに示して」と依頼する方が評価しやすくなります。指摘の数を競わせず、重要な不具合を根拠付きで見つけられたかを確認します。
スポンサーリンク
CLI・SDK・MCPでの自動連携は次の段階
Codexには、非対話処理のcodex exec、プログラムから扱うSDK、会話や承認を組み込むapp-serverがあります。Claude Codeもclaude -pによる非対話実行やAgent SDKを提供しています。自動連携では、呼び出す側がタスクの状態、失敗時の扱い、結果の形式、再試行回数を管理します。出典:OpenAI公式:Codexのハーネスと統合方法、Anthropic公式:Claude Codeのプログラム実行。
MCPは外部の道具やデータにつなぐ方法の一つです。同じサーバーへ両方から接続する構成を検討できますが、通信方式、認証、ツール定義、各クライアントの対応を別々に確認します。同じ接続先であることは、同じ会話履歴や作業記憶を共有することを意味しません。出典:Anthropic公式:MCPによるツール接続。
自動化するなら、例えば実装結果を受け取った後にレビュー工程へ進む状態遷移を外側で管理し、レビュー未完了のまま公開へ進めない設計にします。モデルが別のモデルを無制限に呼び直す構成では、費用や処理時間が膨らみます。試行回数、予算、打ち切り条件、変更の所有者を先に決めます。これは本サイトの設計案で、検証済みの完成した連携ツールを提供するものではありません。
料金は月額だけでなく完了までの総費用で比べる
Codexの公式料金資料はChatGPTのプラン内利用とAPIキー利用を区別しています。Claude Codeも、サブスクリプションでの利用枠とAPIのトークン課金を区別して確認する必要があります。APIの単価に推測したトークン数を掛け、それをプラン内で実行できるタスク数として示す比較は避けます。出典:OpenAI公式:料金と利用枠、Anthropic公式:Claude Codeのコスト管理。
見たいのは、契約費に加えて、追加利用、エージェントの再試行、レビューする人の時間まで含めた負担です。速いモデルが三回やり直す場合と、重いモデルが一回で通る場合では、単価だけの順位と実際の負担が逆になることもあります。逆に、上位モデルをすべての単純処理に使う必要もありません。
二つ契約する価値は、二つ目によって減った手戻りやレビュー時間が、追加費用と引き継ぎ時間に見合うかで判断します。利用上限に備える意味はありますが、両方に同じ障害が起きない保証や、片方の利用枠をもう片方へ移せる仕組みではありません。金額・利用枠は変更されるため、契約直前に公式ページと自分の管理画面で確認してください。
スポンサーリンク
機密情報と実行権限も選定条件に入れる
二社を使う場合、ソースコードや仕様を渡す相手が増えます。組織で許可された契約、データの扱い、保存、外部ツール接続の範囲を確認します。ログインできることと、顧客データを投入してよいことは別です。使いやすさを比較する段階では、公開可能なサンプルや機密性を落とした検証用データから始めます。
また、読取、編集、テスト、外部送信、デプロイを一括して同じ権限にしません。特にレビュー担当は、必要がなければ読取を中心にします。モデルの性能を上げても、過大な権限や誤った接続先が安全になるわけではありません。承認が必要な変更は、使う製品に応じた設定と運用で管理します。
自分のチームで比較するための小さな評価方法
最初に、過去に解決した小さな課題を複数用意し、開始時点のコード、仕様、検証手順を揃えます。同じタスクを同じ状態から始め、モデルの版と設定も残します。一回だけの成功を一般化せず、条件を変えたときにも同じ傾向があるか確かめます。
| 評価項目 | 記録する内容 |
|---|---|
| 正しさ | 受け入れ条件と固定したテストを満たしたか |
| 変更の節度 | 不要な依存追加や無関係な修正がないか |
| 説明の検証可能性 | 実行した確認と未実行の確認を分けたか |
| 時間 | AIの待ち時間と人の確認時間を分ける |
| 費用・利用枠 | 実際の消費と再試行を含める |
| 併用の効果 | 二つ目が見つけた有効な問題と増えた負担 |
AIに採点を任せる場合も、AI自身が作ったテストを通しただけで満点にはしません。既存テスト、隠しておいた受け入れ条件、人の確認などを組み合わせます。本記事に数値の比較結果がないのは、この条件を揃えた評価を実施していないためです。
スポンサーリンク
まず一本の工程を安定させてから併用する
既存のChatGPT・Codex環境で調査から変更確認まで進められるなら、そこを基準にします。Claude Codeで使い慣れた手順があるなら、同じように基準にできます。その上で、重要な差分の別観点レビューや、苦戦している種類の仕事へもう一方を加える方が、常に二重実行するより効果を測りやすくなります。
モデルは作業の難しさに合わせ、サービスは実行環境と管理のしやすさで選びます。連携の単位は会話の丸ごと転送より、目的・差分・検証結果を揃えた成果物にします。どちらを選んでも、最後に残すべきものは「AIができたと言ったこと」ではなく、受け入れ条件を満たした変更と、その根拠です。