目次
Googleは2026年10月13日、Gemini 4 ArgonをGemini APIで一般提供しました。目立つのは「最大1Mトークン」ですが、本番導入で重要なのは単純な出力上限の拡大ではありません。入力、思考、出力が一つの枠を共有すること、64Kトークンを超える応答は複数回の生成を継続して組み立てること、長時間処理の状態・費用・再開をアプリ側で扱うことが従来の短いAPI呼び出しと異なります。
本稿は2026年10月23日にGoogleの発表、Gemini APIドキュメント、料金表、モデルカードを確認した実装解説です。新たな発表を速報する記事ではなく、Gemini 4 ArgonのLong DecodeをWebサービスへ組み込む場合に、どの処理へ使い、どこで使わないかを判断する材料を整理します。
スポンサーリンク
1Mトークンは入力と出力を別々に使える意味ではない
GoogleのGemini 4 Argon一般提供発表によると、同モデルは開発者向けにGemini APIとAI Studioから世界的に提供されています。モデルIDはgemini-4-argonで、無料枠では利用できません。テキスト、画像、動画、音声、PDFを入力でき、出力はテキストです。
Gemini APIのトークン資料が示す最大枠は1,048,576トークンです。ただしGemini 4では、入力、モデルの思考、最終出力がこの一つのコンテキストを共有します。たとえば入力に大きなリポジトリや大量の資料を使うほど、Long Decodeへ残る余地は減ります。入力とmax_output_tokensの合計が上限を超える場合、APIは出力上限を残りの枠へ調整します。
通常の同期・ストリーミング処理では、出力の既定上限は65,536トークンです。1Mまで使うには、単にモデル名を変更するのではなく、バックグラウンド実行を有効にし、max_output_tokensを65,536より大きく設定します。既存SDKやエージェントフレームワークが8,192などの小さい上限を設定していれば、モデルが十分に考える前に停止する可能性があります。
Long Decodeは64K単位の継続処理
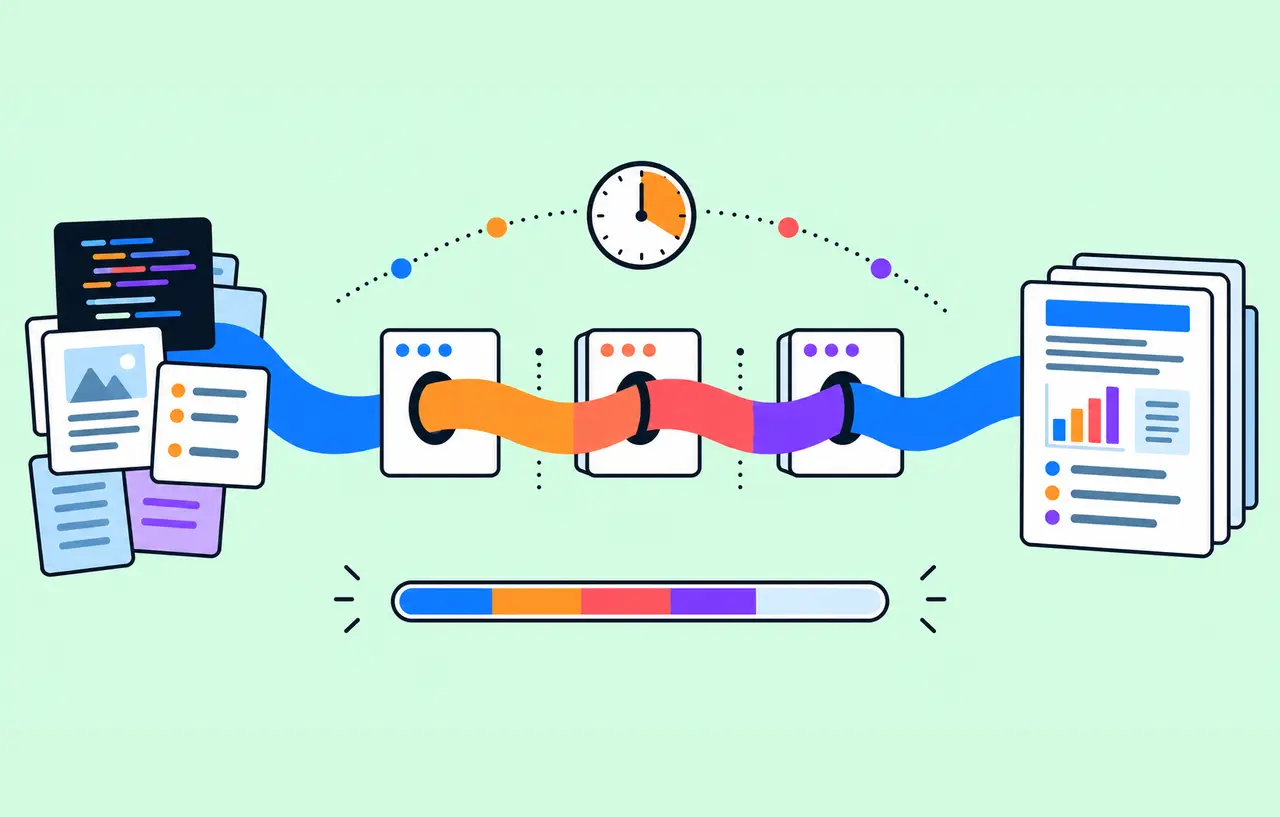
GoogleのLong Decodeガイドでは、1回のモデル呼び出しが生成するのは最大64Kトークンで、それを超える場合は前回の続きから次の「hop」を生成すると説明されています。Interactions APIのバックグラウンド実行では、サーバー側がこの継続処理を行い、一つのinteraction IDに複数のmodel_outputステップを追加します。利用側は完了後、それらを順番に結合して全文を得ます。
ここで「一つの応答」と「一つのHTTP接続」を同一視しないことが重要です。長い処理は数分以上かかることがあり、バックグラウンドinteractionは最大24時間動作します。作成時に返るinteraction IDを永続化し、ブラウザーの接続が切れても別のリクエストから状態を照会できるようにします。バックグラウンド実行ではサーバー保存が必要であり、保存を避けたい場合はGenerateContent APIのクライアント側継続を検討します。
import { GoogleGenAI } from "@google/genai";

const client = new GoogleGenAI({});

let job = await client.interactions.create({
  model: "gemini-4-argon",
  input: migrationPlan,
  background: true,
  generation_config: {
    max_output_tokens: 262144,
    thinking_level: "high",
  },
});

await saveJobId(job.id);

while (job.status === "queued" || job.status === "in_progress") {
  await new Promise((resolve) => setTimeout(resolve, 5000));
  job = await client.interactions.get(job.id);
}

if (job.status !== "completed") {
  throw new Error(`long decode ended with ${job.status}`);
}

const result = job.steps
  .filter((step) => step.type === "model_output")
  .flatMap((step) => step.content ?? [])
  .filter((part) => part.type === "text")
  .map((part) => part.text)
  .join("");
上の例は公式JavaScript例を基礎にした構成例で、当サイトが実環境で実行した測定結果ではありません。本番では無期限のポーリングを避け、処理期限、キャンセル、指数バックオフ、interaction IDごとの冪等な保存を追加します。completed以外にも、ツール実行を求めるrequires_action、上限へ到達したincomplete、failed、cancelledを別々に扱います。
スポンサーリンク
向くのは一つの難問を長く解く処理
| 用途 | Long Decodeの判断 | 理由 |
|---|---|---|
| 大規模な移行計画や難しいコード解析 | 候補 | 一つの課題で長い思考と出力を必要とする場合がある |
| 形式的証明・研究・複雑な設計レビュー | 候補 | 64Kを超える検討と自己確認が役立つ可能性がある |
| 通常のチャット・分類・短い要約 | 不要 | 32K未満で終わる処理に長時間実行の負担を増やす |
| 多数の短いツール呼び出しを繰り返すエージェント | 原則不要 | 各ターンは短く、大きな出力が共有枠を早く消費する |
| 応答時間が厳しい画面処理 | 不向き | 最初の結果までの待ち時間と再接続設計が必要 |
| 入力だけで上限に近い処理 | 不向き | 思考と出力に残る枠が少ない |
Google自身も、多くのコーディングやエージェント処理は64K以内で終わると説明しています。最初から262,144や1,048,576へ広げるのではなく、既定の65,536で完了率を測り、難しい入力だけを長いキューへ送る方が運用しやすくなります。thinking_levelはlow、medium、highから選べ、通常のコード・エージェント処理には既定のmedium、特に難しい処理にはhighが候補です。
Long DecodeはRAGの代替でもありません。最新版の仕様、顧客固有データ、公開直後の情報を必要とするなら、まず必要な資料を検索して絞り込み、その後の統合や長い分析にLong Decodeを使います。モデルカードはGemini 4の知識カットオフを2026年3月とし、幻覚、遅さ、タイムアウトの可能性も既知の制約として挙げています。
トークン集計と請求はコンテキスト長と一致しない
各hopでは、元のプロンプトとそれまでの生成内容が再び入力されます。そのためusage.total_input_tokensは、現在のコンテキストサイズではなく、すべてのhopで送られた入力の合計です。公式例では、1,000トークンのプロンプトから思考と出力を20万トークン生成すると、4回のhopで入力合計は約397,216トークンになります。一方、現在のコンテキストは約201,000トークンです。
後続hopで繰り返される入力は、暗黙キャッシュが成立すれば95%割引されます。ただし、失敗やキャンセルまでに実行された処理も請求対象です。ストリーム中に複数回届くusageは累積値なので、イベントごとに足し合わせず、最後に受け取った値を保存します。コンテキスト圧縮の判断には入力累計ではなく、元の入力、出力、思考の現在量を使います。
Gemini Developer APIの料金表では、2026年11月30日までのStandard料金は100万入力トークン当たり2ドル、思考を含む100万出力トークン当たり10ドルです。12月1日からはそれぞれ4ドルと20ドルになります。暗黙キャッシュ入力は同期間0.10ドル、その後0.20ドルです。Long Decodeは無料枠で利用できないため、評価時からトークン上限と1ジョブ当たりの予算を設定します。
スポンサーリンク
既存Geminiアプリを移行するときの差分
- モデルIDを
gemini-4-argonへ変更し、無料枠では使えない前提で請求設定を確認する max_output_tokensを固定している場合は、思考で上限を使い切る入力がないか調べるlow、medium、highを同じ評価データで比較し、合格する最小段階を選ぶ- 明示的キャッシュは非対応のため、
cachedContentsやcaches.createへの依存を外す - 暗黙キャッシュを活かす場合は、4,096トークン以上の共通部分を入力の先頭へ安定して配置する
temperature、top_p、top_kは無視されるため、旧設定が品質を制御していると思い込まない- 長い処理はタイムアウトを少なくとも15分へ見直すか、バックグラウンドジョブへ分離する
出力をストリーミングする場合も、interaction IDと最後のevent_idを保存し、切断後はlast_event_idから再接続します。公式資料は15〜20分の読み取りタイムアウトを案内し、最初の64K以降は約5,000トークン単位で届き、間が空く場合があると説明しています。無通信を即座に失敗と判定すると、正常なLong Decodeを重複実行する恐れがあります。
本番導入は長さではなく完了率で評価する
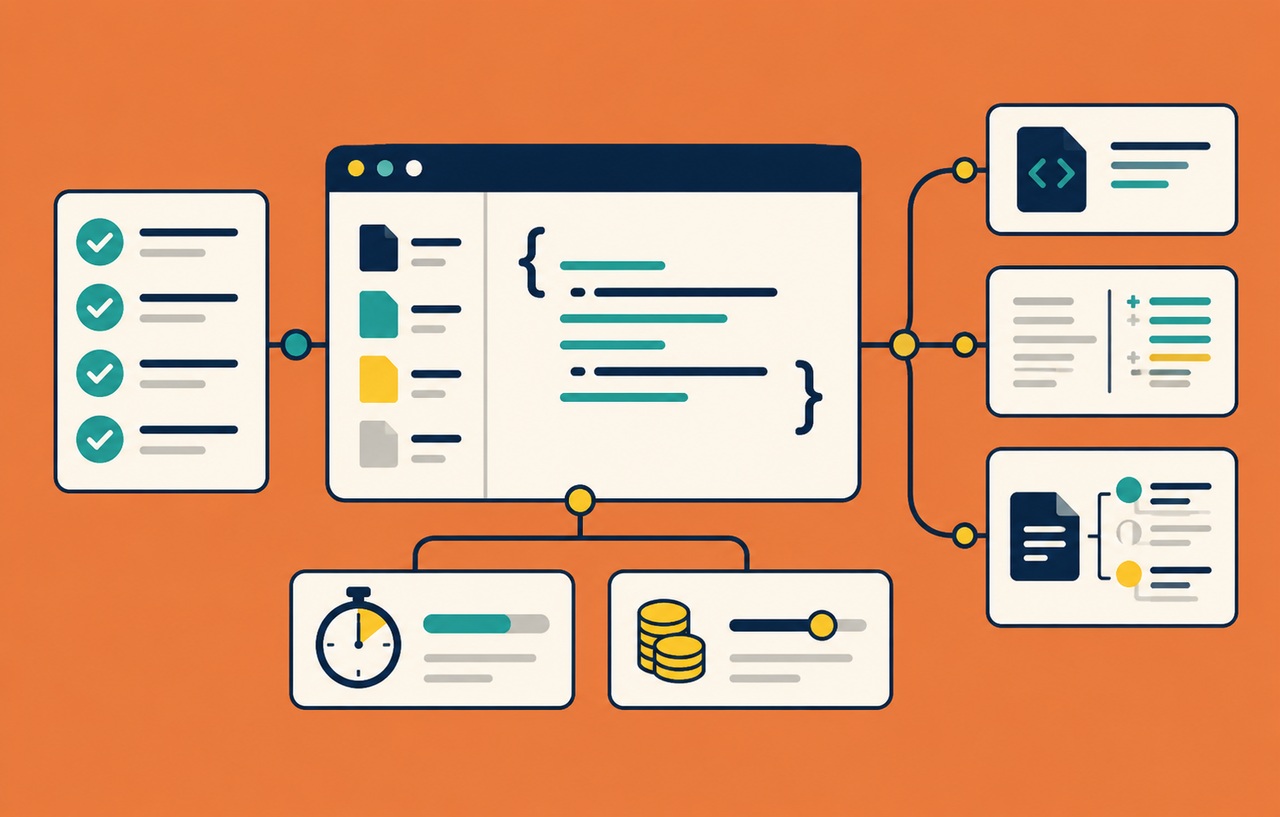
Long Decodeの価値は「何文字出せたか」ではなく、従来は分割や人手の引き継ぎが必要だった難しいタスクを、許容できる費用と時間で完了できたかです。本サイトの提案として、短い通常処理と長い処理を別キューにし、同じ評価データで正確性、要件充足、incomplete率、処理時間、思考・出力トークン、失敗後の再開成功率を比較します。
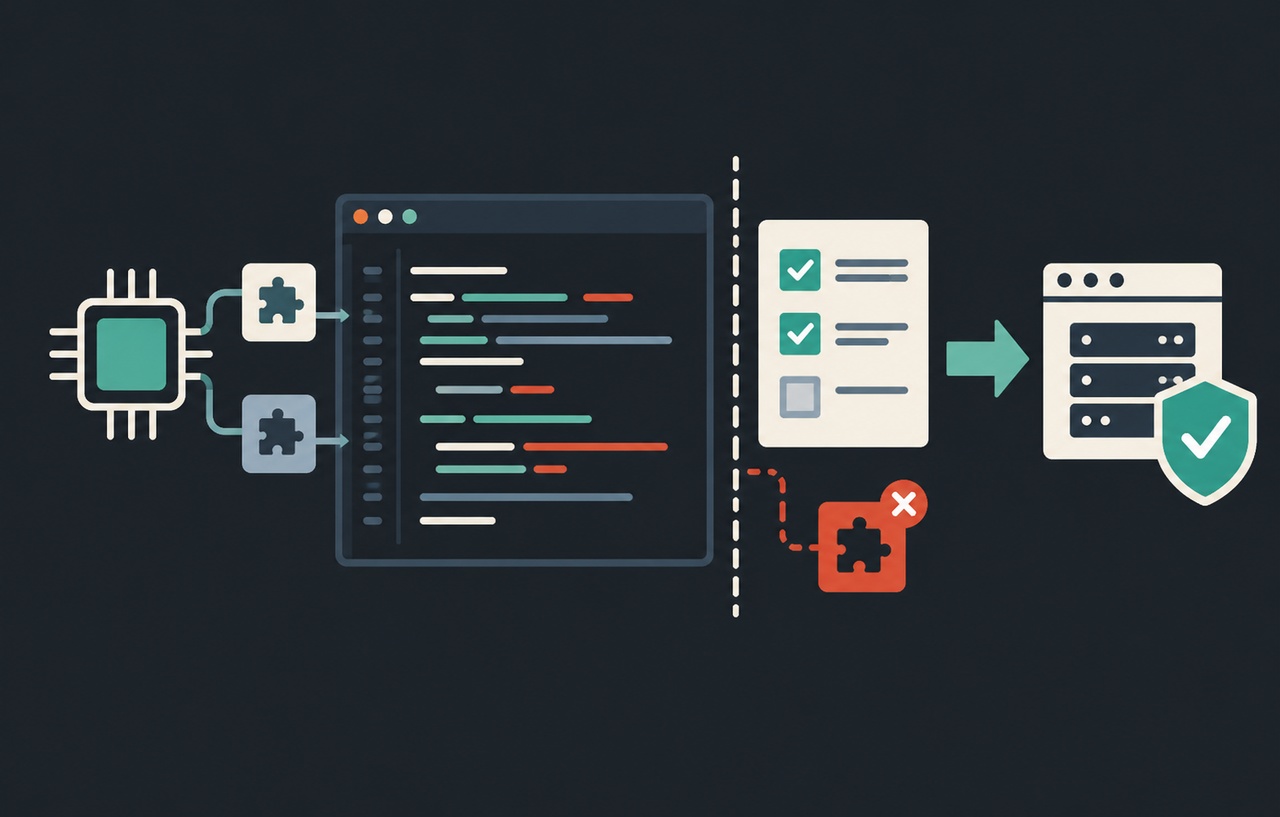
最初の導入対象は、入力と期待結果をレビューできる社内向けの設計調査や移行計画が適しています。利用者向け画面から直接1Mの処理を開始させる前に、同時実行数、1利用者当たりの予算、キャンセルUI、結果の保存期間、再実行の条件を決めます。長い生成物ほど正しいとは限らないため、コードテスト、静的解析、引用元照合、人による承認を成果物の種類に応じて組み合わせます。
Gemini 4 ArgonのLong Decodeは、通常のAPI応答を一律に長くする機能ではありません。一つの難問を継続して解くためのジョブ実行基盤です。既定の64Kで足りない実例を特定し、interaction ID、状態遷移、使用量、期限、キャンセル、検証を先に設計できるチームにとって、1Mトークンは初めて実務的な選択肢になります。
関連記事
- AIの改善を勘で判断しないために|評価データと回帰テストの始め方(思考段階や上限を比較する評価データの作り方を確認できます)
- RAGの回答がずれるのはなぜ?文書分割と検索品質から改善する(長いコンテキストへ入れる前の検索品質と出典確認を整理しています)
- AIのツール呼び出しをコードにまとめるには|Programmatic Tool Callingの実装判断(多数の短いツール処理と長い単一応答の役割を分ける参考になります)
参考資料
- Google「Gemini 4 Argon: Built to solve your hardest problems」
- Google AI for Developers「What's new in Gemini 4 Argon」
- Google AI for Developers「Long decode」
- Google AI for Developers「Understand and count tokens」
- Google AI for Developers「Gemini Developer API pricing」
- Google DeepMind「Gemini 4 Argon Model Card」