目次
AIへ複数の売上APIを調べさせると、各APIの結果を読むたびにモデルの応答を待ち、大量の明細が会話へ積み上がります。結果が必要なのは上位数件だけでも、途中のデータまでモデルへ渡す構成では、入力トークンと往復時間が増えます。処理をプログラムとしてまとめられるなら、データを絞ってからAIへ返す方法を検討できます。
AnthropicのProgrammatic Tool Callingは、この処理をコード実行コンテナ内で組み立てる機能です。本記事は2026年10月22日に確認した公式資料を基にした実装解説で、当日の新製品発表ではありません。外部APIやモデルの実測は行っていません。公式の実行仕様と、サイト運営用の集計機能を想定した本サイトの設計案を分けて説明します。
スポンサーリンク
何をモデルに読ませ何をコードで処理するか
通常のツール呼び出しでは、モデルが関数と引数を選び、アプリが実行し、その結果をモデルへ戻します。必要ならモデルが次の関数を選びます。問い合わせごとに異なる解釈が必要な処理には分かりやすい構成ですが、同じ形式のデータを複数回取得して足し合わせるだけなら、モデルの判断を毎回挟む利点は小さくなります。
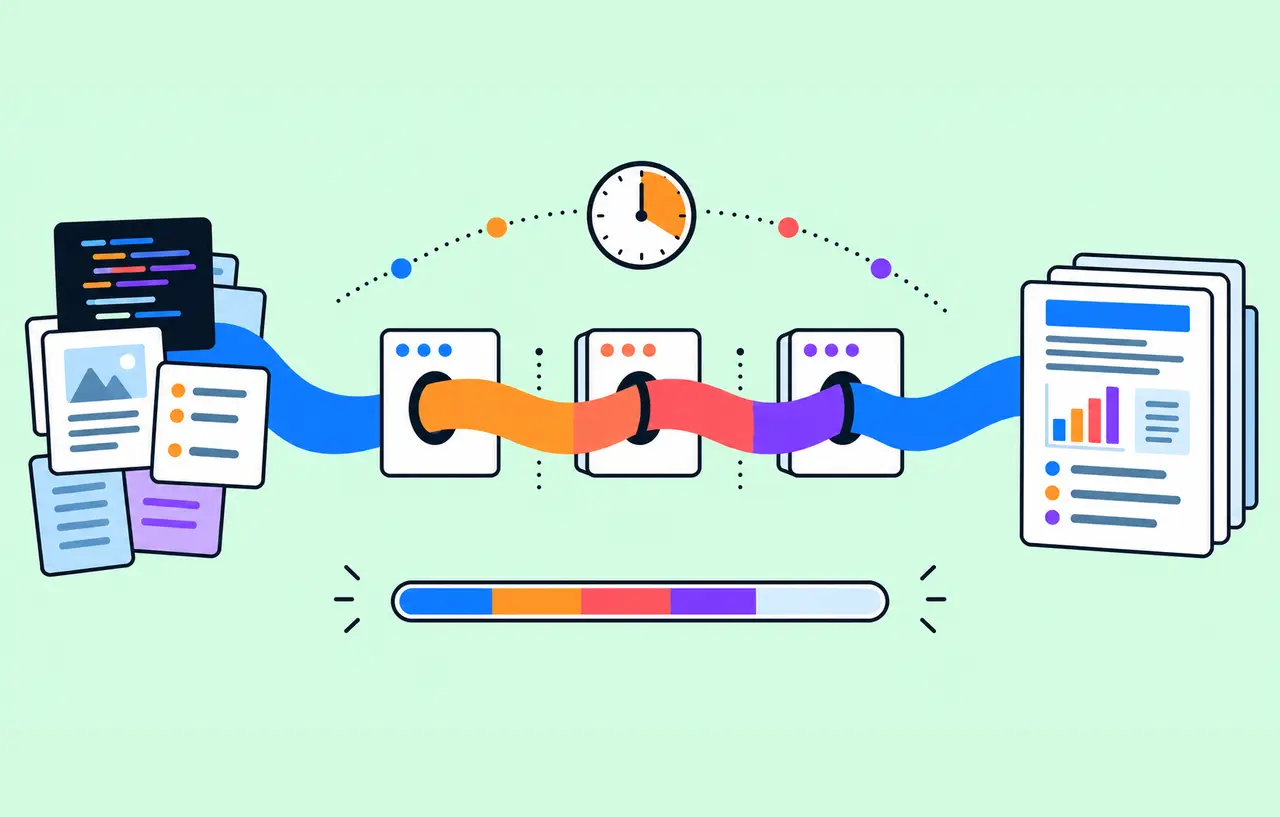
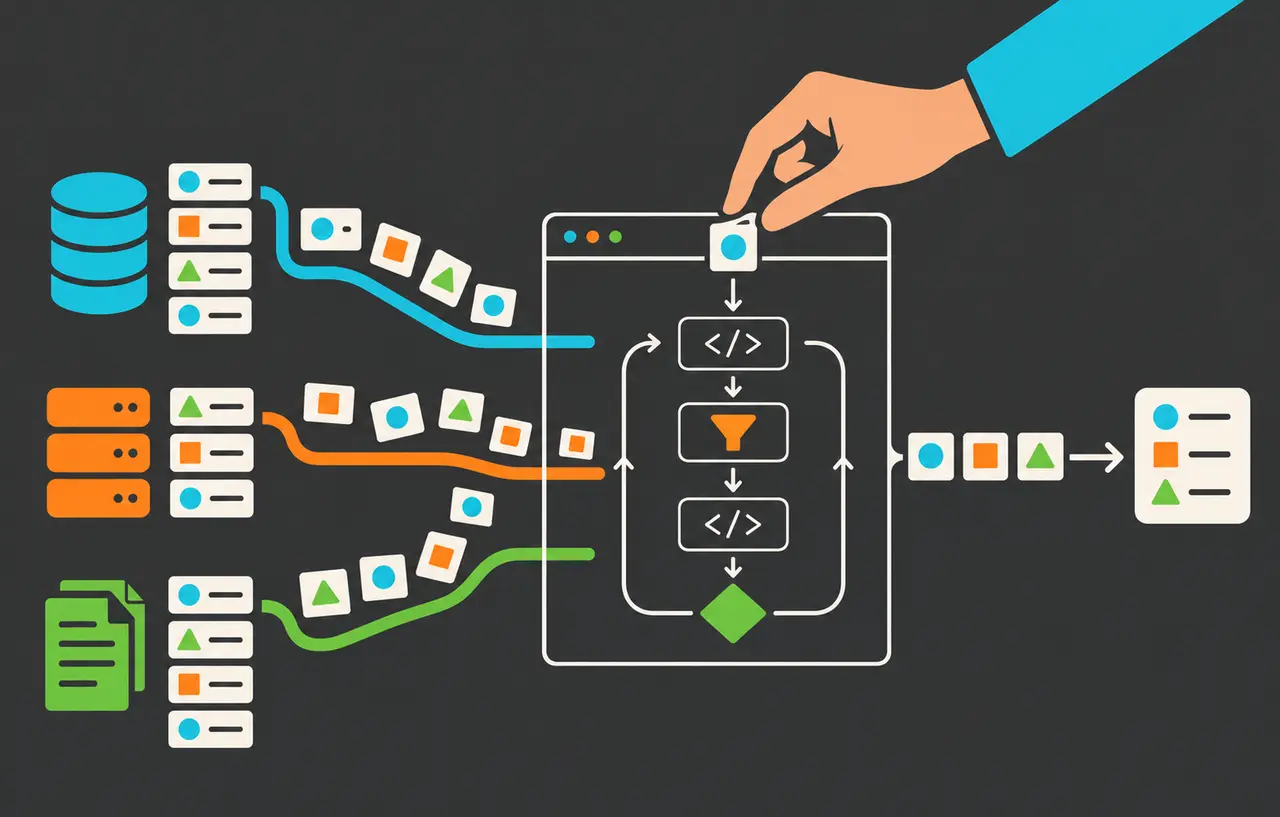
Programmatic Tool Callingでは、モデルがツールを呼ぶPythonコードを作り、コード実行環境でループや条件分岐、集計を行います。公式資料によると、中間のツール結果はモデルのコンテキストへ直接追加されず、コードの最終出力をモデルが受け取ります。大きな結果を必要な行に絞れる場合に、入力を減らす余地があります。
ただし、ツールが外部システムへアクセスする経路まで自動で消えるわけではありません。クライアント実装のツールなら、実行要求を受け取り、アプリ側で認証・検証・実行し、結果を返す処理が必要です。モデルへの往復を減らすことと、ネットワーク通信やツール実行を減らすことは別です。
Anthropic公式資料|Programmatic tool calling:実行と再開の仕様
適しているのは同じ形の大量データを絞る処理
サイト運営の仮想例として、複数サイトの前日売上を取得し、エラー件数と合わせて一覧化する機能を考えます。各サイトのデータ形式が揃っていれば、取得、欠損チェック、合計、条件での抽出をコードへまとめられます。モデルには全明細を渡さず、集計値、異常のあるサイト、欠損のある項目だけを説明させる構成です。
反対に、一件ずつ返ってくる曖昧な文章を読み、次にどこを調べるかをその都度推論する処理では、コードへまとめてもモデルへの相談が残ります。利用者の承認を毎回挟む更新処理も、一本の長いスクリプトに押し込まない方が扱いやすいでしょう。実行コンテナの準備とコード生成にも負担があるため、短い結果を一、二回読むだけなら通常のツール呼び出しから始められます。
スポンサーリンク
固定の集計なら普通のアプリコードも候補になる
集計手順とAPIが最初から決まっているなら、AIに毎回コードを書かせる必要があるかを検討します。決まったSQLやバッチで集計し、結果の説明だけをモデルに依頼する方が、テストと費用の予測が簡単な場合があります。Programmatic Tool Callingが役立つのは、自然言語の依頼によって取得対象や組み合わせが変わり、その場で小さな処理を組み立てたい場合です。
例えば「今週の売上が落ちたサイトだけ、前週とアクセス数を比較して」という依頼では、最初の結果を使って次の取得対象を限定できます。ただし、分析のための読み取り関数と、価格変更や公開停止などの更新関数を同じ目的のツールとして渡す必要はありません。分析画面の責務に合わせた小さな読み取りAPIを用意すると、生成コードも理解しやすくなります。
導入前にモデルとツールの対応を確認する
公式資料では、コード実行ツールのcode_execution_20260120以降が必要です。モデルの対応はModels APIのcapabilities.code_execution.supportedで確認する手順が示されています。モデル名から対応を推測せず、利用するAPIとモデルで確認してください。チャット製品の契約だけで、同じAPI機能を使えるとは限りません。
呼び出したいツールにはallowed_callersを設定します。コード実行から呼べることを宣言する項目であり、サーバー側の認可を代替しません。公式資料では、MCP connectorが提供するツールと、computer use・browser useの該当ツールセットはプログラムから呼び出せないとされています。既存のMCP接続を、そのまま全部この方式へ流せるという前提で移行しないでください。
スポンサーリンク
実装の中心は途中停止からの再開処理
最初の応答でstop_reasonがtool_useになると、クライアントは必要なツール呼び出しを処理します。Programmatic Tool Callingの呼び出しかどうかは、tool_useブロックのcallerも見て区別します。コード実行が外部結果を待っている間は、対応するtool_resultを返して処理を再開します。
再開では応答のcontainer IDを引き継ぎ、必要なツール定義を保ちます。待機中のプログラム呼び出しへ結果を返すuserメッセージはtool_resultブロックだけにする制約があり、結果のcontentは文字列またはtextブロックで返します。画像や文書のブロックをそのまま返せる通常のツール処理と混同しないよう、APIループの層で形式を検証します。
サーバー側では、tool_use_idと実行結果を対応付けます。タイムアウトした呼び出しを別の要求へ誤って割り当てると、その後の集計が正しい形でも意味が崩れます。完了、失敗、結果待ちの状態を記録し、同時に複数の要求が返った場合も、すべての対応関係を維持してください。
JSONを返すツールから小さく試す
次は、本サイトが提案する読み取りAPIの返却形式です。特定のSDKへ投入する完全な実装ではありません。日付、サイトID、通貨、金額の単位を明示すると、コードが結果を取り違えにくくなります。
{
  "site_id": "shop-a",
  "date": "2026-10-21",
  "currency": "JPY",
  "revenue_minor": 125000,
  "orders": 18,
  "complete": true
}
金額は通貨の最小単位を整数で返すなど、集計前提をAPIの仕様へ書きます。JPYでは小数を持たなくても、別通貨の桁数が同じとは限りません。欠損をゼロと返すと、取得失敗を売上減と誤解するため、completeや明確なエラーで区別します。結果はコードとして評価せず、JSONとして解析し型と範囲を確認します。
生成コードには、どの期間を比較し、欠損を除外したかも最終出力へ含めるよう依頼します。数値だけを返すと、モデルが集計条件を説明できなくなります。件数、対象ID、期間、除外件数を残すと、管理画面から元のレコードへ戻って確認できます。
並列化には上限と部分失敗の設計が必要
コードから多数のAPIを同時に呼べる場合でも、外部APIの上限まで変わるわけではありません。公式資料は、コードからの各ツール呼び出しも個別にレート制限の対象になると説明しています。サイトが増えたときに一斉実行すると、取得失敗と再試行が集中する可能性があります。
本サイトでは、並列数、呼び出し総数、各要求のタイムアウト、再試行回数をアプリ側で制限する構成を提案します。一サイトの失敗で全体を破棄するか、取得できた範囲を部分結果として返すかも決めます。部分結果の場合は、未取得の対象を本文と画面へ表示し、完全な合計と区別してください。
中断後の再実行は、最後まで処理されたかをログで照合してから行います。読み取りだけなら再取得しやすくても、外部課金や重い検索が発生することがあります。将来更新系を追加する場合は、同一操作の識別と重複防止を別途実装し、分析用スクリプトへ安易に混ぜないようにします。
費用は減った入力だけで判断しない
公式資料は、この方式の利用料金をコード実行の料金体系へ案内しています。削減される入力に加え、コード実行と生成出力、外部API、再試行、アプリ側の処理時間も含めて比較します。コードにまとめたのだから必ず安いとは判断できません。
評価では同じ依頼とデータを使い、通常のツールループ、固定コードによる集計、Programmatic Tool Callingの三構成を比較すると判断しやすくなります。正しい合計や欠損判定の割合、モデルが受け取る入力、全体の完了時間、外部APIの要求回数、失敗時の復旧時間を記録します。モデルやデータ量は揃えてください。
特に、モデル呼び出しが減ってもAPI要求回数が増えていないかを確認します。明細を一件ずつ読む生成コードになった場合、アプリ側で用意した一括取得より遅くなる可能性があります。ツール名だけでなく、一括取得できる条件やページ送りの方法を説明すると、無駄な呼び出しを減らす余地があります。
スポンサーリンク
最初の導入範囲を決める
最初は、読み取り専用の一用途、少数のAPI、明示的な出力形式から始めます。正常系に加えて、空データ、ページング、重複ID、通貨違い、API停止を評価ケースへ入れてください。正常な例で一度動くことと、日常運用で信頼できることは別です。
既存の構造化出力とツール呼び出しの記事は、AIが生成するデータと外部実行の責任分界を扱っています。本記事はその先で、中間結果をコードへ集める実装を選ぶ判断を扱います。単純な分類なら実行ループを増やさず、複数の取得と集計が負担になった段階で、この方式と固定プログラムを比較するのが現実的です。
対応の確認では、コード実行ツール自体を受け付けるかと、そこから別ツールを呼べるかを分けます。公式Code execution資料は、前者をcapabilities.server_tools.code_execution.supported、後者をcapabilities.code_execution.supportedで確認すると説明しています。二つを取り違えると、計算はできてもツールのプログラム呼び出しはできないモデルを選ぶ可能性があります。
参考資料
Anthropic|Programmatic tool calling
Anthropic|Code execution tool:モデル対応と利用料金
スポンサーリンク