目次
障害を検知したAIエージェントが原因を推定し、その場で緩和コードを作り、本番へ適用する。Googleは2026年10月22日、こうした「自己進化型AI」を運用する参考アーキテクチャProject Chrysalisを公開しました。従来の運用支援AIがログの要約や手順の提案にとどまるのに対し、この構成は状況に応じたツールの合成、結果の評価、運用原則の記憶、エージェント構成の変更まで扱います。
ただし、Googleが示した数値は実顧客の本番障害ではなく、ブラックフライデーのキャッシュスタンピードを模したデモ環境での結果です。本稿は2026年10月23日にGoogle Developers Blogと各製品の公式資料を確認したAI×セキュリティの導入解説です。新製品の一般提供を告知する記事ではありません。自己修復という言葉だけを採用理由にせず、AIが変更を提案できる範囲と、本番で実行できる範囲を分離する方法を整理します。
スポンサーリンク
Project Chrysalisで変わるのは助言から実行への距離
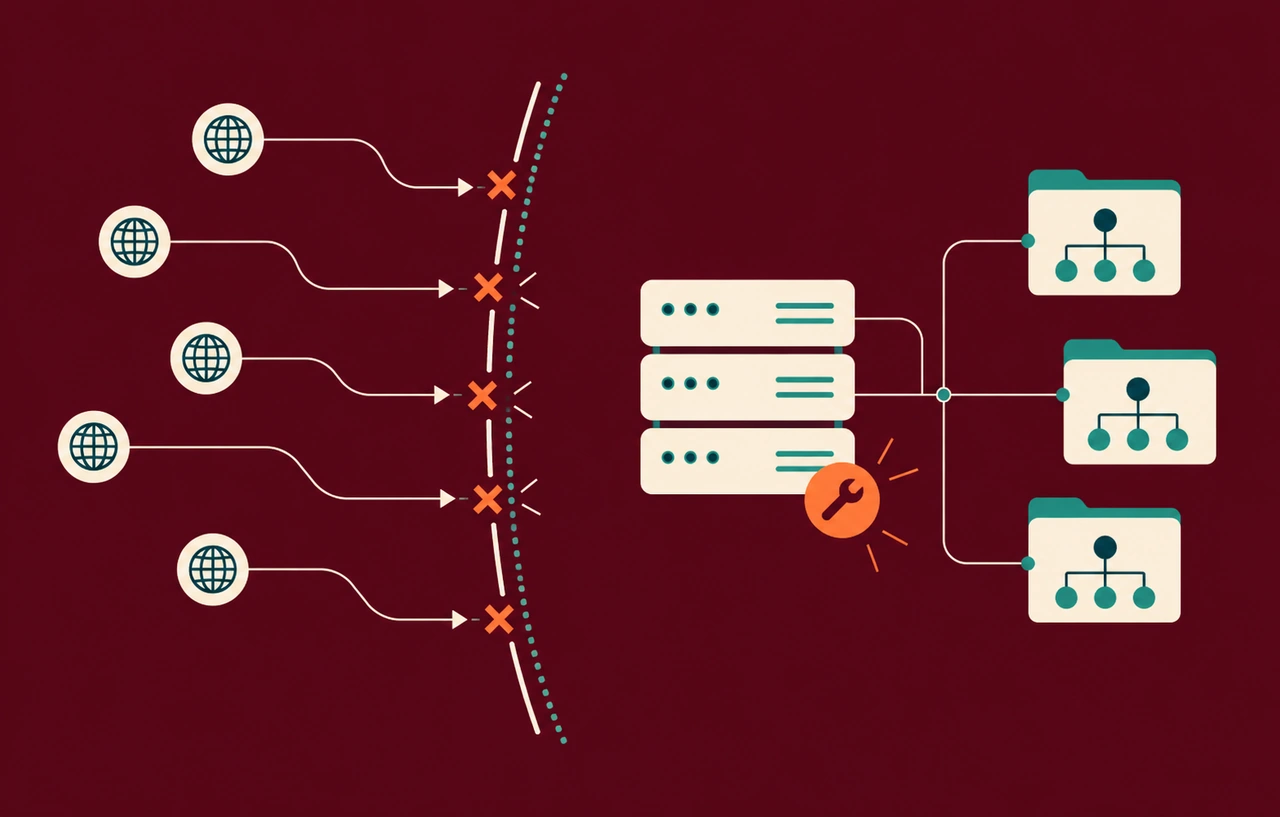
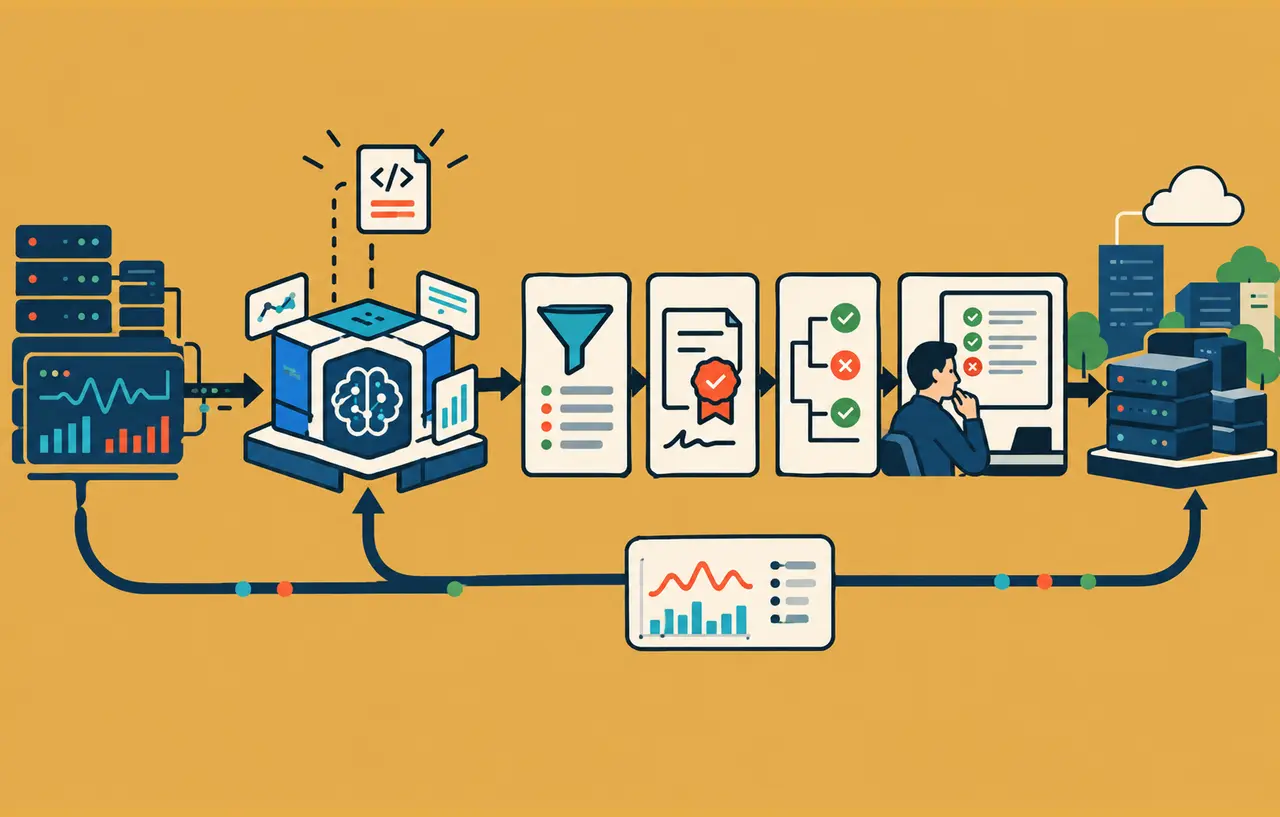
Google Developers BlogのProject Chrysalis解説では、キャッシュの失効によってCloud SQLの接続プールが飽和し、HTTP 500が連鎖する状況を扱っています。エージェントは既存ツールに適切な手段がないと判断すると、API Gatewayへ組み込むトークンバケット型のレート制限コードを合成します。さらに、その介入が有効だったかをテレメトリーから評価し、同種障害でデータベースを再起動しないという原則を記憶し、将来の対応に使う専門エージェントを追加します。
Googleのデモでは、初回緩和までの時間が手動対応の15〜45分から1.8秒へ短縮され、二回目の負荷ではHTTP 500が0%になったと報告されています。一方、40件の要求をHTTP 429で制限し、10件を処理した構成です。「障害が消えた」のではなく、データベースを守るために負荷を落とした結果である点が重要です。売上、在庫、決済のような業務では、429を返す判断自体が事業上の意思決定になります。
本サイトの分析では、導入判断の中心はモデル性能ではありません。AIが作った変更を、誰が、どの証拠で、どこまで実行可能にするかです。Project Chrysalisは、その境界を入力検査、暗号学的な来歴、Policy as Codeと人の承認、監査ログという四つの統制へ分けています。
第一境界は入力と生成コードを別々に検査する
運用エージェントへ渡るアラートやログは、信頼できる命令ではありません。HTTPヘッダー、例外メッセージ、利用者入力、外部サービスの応答には、プロンプトインジェクションや秘密情報が混ざる可能性があります。参考構成ではModel Armorがエージェントへ入る前のテレメトリーを検査し、プロンプトインジェクションと機密データ漏えいを抑えます。
Google CloudのModel Armor公式資料によると、プロンプトと応答だけでなくエージェントのやり取りを対象にし、悪性URL、マルウェア、機密情報も検出できます。REST APIでGoogle以外のモデルにも利用できるとされています。ただし、検査器を通した入力が必ず安全になるわけではありません。誤検知と見逃しを前提に、検査結果だけで本番変更を許可しない設計が必要です。
入力の検査とは別に、生成されたコードも実行前に調べます。デモではASTを解析し、禁止されたシステムモジュールや動的実行の入口がないかを確認しています。ここで見るべきなのは文字列としての危険語だけではありません。許可したAPIだけを呼ぶか、外向き通信やファイル操作を持たないか、実行時間とメモリーを制限できるか、失敗時にロールバックできるかを、実行環境の制約として設けます。
スポンサーリンク
第二境界は署名された変更だけを実行可能にする
Project Chrysalisでは、検査を通過したパッチのdigestをCloud KMSの非対称鍵で署名し、実行境界で署名と鍵の来歴を確認します。これにより、AIが生成したという理由だけでは本番へ入らず、検査済みの同一成果物だけが次へ進みます。検査後にコードが差し替えられるTOCTOUの問題を避けるには、承認対象と実行対象を同じdigestで固定する必要があります。
Binary Authorizationの公式概要は、ポリシーへ適合したコンテナイメージだけをGKE、Cloud Runなどへデプロイできる仕組みを説明しています。Googleのデモは、この考え方を実行時に合成したミドルウェアへ応用しています。ただし通常のBinary Authorizationが直接すべてのインメモリコードを検証するわけではありません。自社実装では、何がGoogle Cloudの既製機能で、何が参考実装の独自ミドルウェアかを分けて設計してください。
署名鍵をエージェント自身へ渡すと、検査と署名の分離が崩れます。生成処理、静的検査、テスト、署名、実行を別の主体にし、署名サービスは許可されたCIや審査ジョブからだけ利用できるようにします。鍵の権限、署名要求の監査、鍵のローテーション、失効時の挙動までが導入範囲です。
第三境界は変更の種類ごとに自動化の上限を決める
コードが安全に実行できても、業務上正しいとは限りません。レート制限を厳しくしすぎれば、障害は止まっても正規利用者を締め出します。参考構成ではOPA Policy Controllerが最低処理レートを検査し、エージェントが自らDoSを起こさないようにします。Policy Controllerの公式資料では、監査、Admission Control、適用前検査にプログラム可能なポリシーを利用できると説明されています。
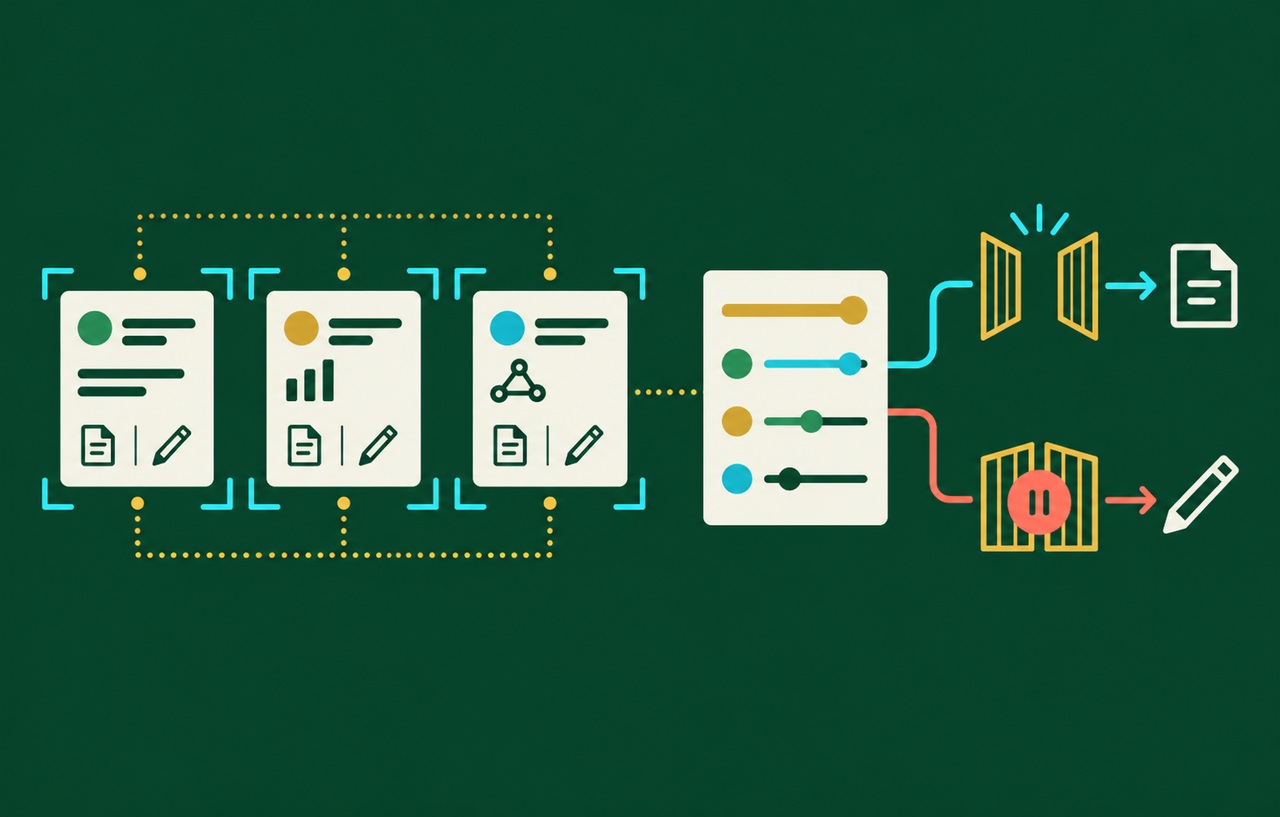
本サイトでは、変更を少なくとも三段階へ分けることを提案します。観測と提案だけの操作、期限付きで自動適用できる可逆操作、人の承認が必要な永続操作です。例えば、読み取り専用の診断は自動、上限付きの一時的なレート制限は自動適用後に通知、データベース再起動、権限変更、ネットワーク開放、エージェント構成の恒久変更は承認必須とします。
| 変更 | 既定の扱い | 最低限の確認 |
|---|---|---|
| ログ解析と原因候補の提示 | 自動 | 読み取り範囲と機密情報のマスキング |
| 期限付きレート制限 | 条件付き自動 | 最小処理量・有効期限・自動解除 |
| 新しいコードの実行 | 隔離環境で自動 | AST・テスト・署名・資源制限 |
| 本番への永続反映 | 人の承認 | 差分・digest・影響範囲・ロールバック |
| エージェント権限や構成の変更 | 複数人承認 | 職務分離・期限・再審査 |
Googleの構成も、高リスクなエージェント階層の変更にはSREの明示的な承認を求めています。「人をループに入れる」だけでは不十分で、承認画面に何を表示するかが重要です。自然言語の要約に加えて、変更差分、署名対象のdigest、検証結果、予想されるSLOへの影響、期限、元へ戻す操作を提示します。緊急時に承認者が内容を読めないなら、承認は形式化します。
スポンサーリンク
第四境界は判断の連鎖を後から再現できること
参考構成では、入力のサニタイズ、AST検査、KMS署名、ポリシー判定、人の承認をCloud Loggingへ記録します。必要なのは「AIが対応した」という一行ではありません。どのアラートを受け、どのモデルと指示で何を生成し、どの検査結果を通り、誰が何を承認し、実行後にSLOがどう変わったかを一つの相関IDで追える状態です。
監査ログは、エージェントが書き換えられない保存先へ送り、時刻、主体、ツール呼び出し、成果物digest、ポリシー版、承認者、実行結果を残します。秘密情報をログへ記録しないことと、調査に必要な証拠を残すことを両立させます。ログの欠落時は自動化を止めるのか、読み取り専用へ縮退するのかも事前に決めます。
1.8秒という数字を本番の期待値にしない
Googleの結果は、5回のウォームアップ後に50件を同時送信し、接続数2のデータベースを使う特定のシミュレーションです。400通りの反実仮想ポリシーを約0.5ミリ秒で評価した値もBigQuery上のベクトル化された再生処理であり、任意の本番トラフィックを同じ時間で検証できる意味ではありません。提供元のデモ結果と、自社環境のSLOは分けてください。
導入前には、過去の障害トレースを匿名化して再生し、正常時、アラートの誤報、入力へ命令文を混ぜた場合、署名失敗、ポリシー拒否、承認者不在、ロールバック失敗を試します。評価では復旧時間だけでなく、正規リクエストの損失、誤った変更、承認待ち時間、生成・検査・再生にかかる費用も測ります。既存記事「AIの改善を勘で判断しないために|評価データと回帰テストの始め方」で扱った固定評価と回帰テストを、運用エージェントでは最終状態とロールバックまで拡張します。
導入は観測から段階的に広げる
最初から自己修復を有効にする必要はありません。第一段階では本番テレメトリーを読み、対応案だけを提示します。第二段階では隔離環境で変更を生成・検証し、人が既存手順と比較します。第三段階で、期限付き、可逆、影響上限が明確な操作だけを自動化します。永続変更や権限の拡大は、十分な失敗データと監査実績が得られるまで承認制を維持します。
機密データを処理する場合は、入力検査だけでなく実行中データの保護も別の課題です。「Confidential G4が一般提供へ|AIの機密データを処理中も守る設計」では、アテステーションを基に鍵を渡す構成を整理しています。また、利用者単位で処理を止める設計は「OpenAIのSafety IDは何を変える?利用者単位の遮断と通知を実装する」が参考になります。いずれもProject Chrysalisの機能そのものではなく、実行境界を具体化するための別の設計材料です。
採用判断で確認すること
- エージェントが読むデータと変更できる対象を資産単位で列挙したか
- 入力検査と生成コード検査を別の境界として実装したか
- 検査対象と実行対象を同じdigestで固定し署名したか
- 自動・条件付き自動・承認必須を操作ごとに分類したか
- 有効期限、影響上限、ロールバック、停止スイッチを用意したか
- 判断から実行後の結果まで相関IDで追跡できるか
- デモ数値ではなく自社の障害トレースで合格基準を満たしたか
自己修復AIの価値は、変更を速く作ることだけではありません。AIが間違える、入力が汚染される、承認者が急いでいるという前提でも、越えてはいけない境界を機械的に守れることです。Project Chrysalisは有力な参考構成ですが、現時点では研究要素を含むデモです。まず観測と隔離検証から始め、証拠を積み上げながら実行権限を狭く開くのが現実的です。
スポンサーリンク
参考資料
- Google Developers Blog|Architecting Governed Self-Evolving AI Agents on the Gemini platform
- Google Cloud|Model Armor
- Google Cloud Documentation|Binary Authorization overview
- Google Cloud Documentation|Policy Controller overview