目次
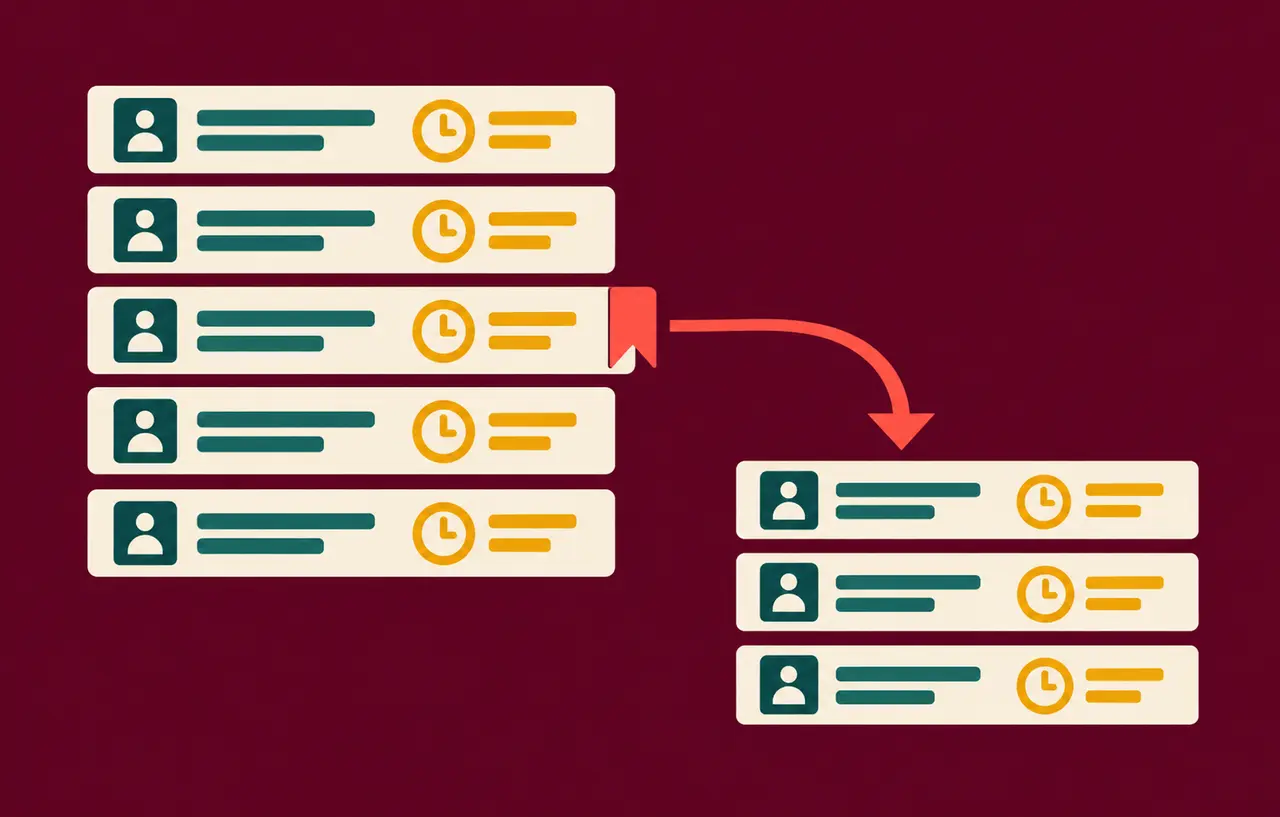
一覧の後半ほど表示が遅い、データが追加されると前のページにあった行がまた出てくる。こうした問題は、何件目から取るかを指定するOFFSET方式の性質と関係している場合があります。順番に読み進めるAPIなら、最後に読んだ行の位置を次のリクエストへ渡すカーソル方式が選択肢になります。
本稿はPostgreSQLのキーセット方式を用いた実装解説です。2026年10月24日に公式ドキュメントを確認しました。画面の「次へ」に適した設計と、任意のページ番号へ飛ぶ設計を比較し、公開日時が同じ記事を持つ一覧を作ります。
スポンサーリンク
OFFSETを置き換える前に利用目的を確認する
PostgreSQL公式のLIMITとOFFSETの説明は、一意な順序を作るORDER BYの重要性と、大きなOFFSETでは飛ばす行もサーバー内部で計算されることを説明しています。単にOFFSETを消せば速くなるのではなく、条件と並び順に合う索引を使い、途中位置から絞り込めることが利点です。
一方、検索結果の20ページ目を直接開く、総ページ数を表示する、小規模な固定一覧を扱う、といった用途ではOFFSETの方が分かりやすい場合があります。総件数取得のコストや更新頻度も含めて選びます。WordPressの画面上でページ番号を出したい場合は、既存のWP_Queryとpaginate_linksによるページャー実装が別の選択肢です。同記事のコードをそのままSQLカーソルへ変換する話ではありません。
並び順を公開日時とIDの組にする
CREATE TABLE articles (
  id bigint PRIMARY KEY,
  tenant_id bigint NOT NULL,
  published_at timestamptz NOT NULL,
  title text NOT NULL
);
CREATE INDEX articles_feed_idx
  ON articles (tenant_id, published_at DESC, id DESC);

-- 1ページ20件と、続きの有無を調べる1件
SELECT id, published_at, title
FROM articles
WHERE tenant_id = $1
ORDER BY published_at DESC, id DESC
LIMIT 21;
サンプルでは各記事にNOT NULLの公開日時があり、IDは一意です。公開日時だけでは同じ時刻の行を区別できないので、IDを第二の並び順にします。日時の新しい順、同時刻ならIDの大きい順です。最初の20件を表示し、21件目があれば続きがあると判断します。
tenant_idは一覧の対象範囲を表す例です。APIでは認証済みの利用者から対象テナントを確定し、クライアントが渡す値をそのまま信用しない構成にします。カーソルは閲覧権限を与える資格情報ではなく、すでに許された一覧の中で位置を示す値です。
スポンサーリンク
最後に表示した行を次ページ条件へ入れる
SELECT id, published_at, title
FROM articles
WHERE tenant_id = $1
  AND (published_at, id) < ($2::timestamptz, $3::bigint)
ORDER BY published_at DESC, id DESC
LIMIT 21;
$2と$3には、20件目として利用者へ返した行のpublished_atとidを渡します。先読みした21件目の値をカーソルにすると、その行を次ページで飛ばしてしまいます。比較演算子は、降順で「続き」を取るため小なりです。日時とIDを別々のAND条件で小なりにすると、正しい辞書順の比較にはなりません。
PostgreSQLの行比較は左から評価され、日時が異なればそこで決まり、同じならIDを比べます。NULLが混ざると比較結果が不明になることがあるため、この例では二つのキーをNOT NULLにしています。詳細はPostgreSQLの行コンストラクター比較で確認できます。
カーソルには型と精度を保って入れる
{
  "v": 1,
  "published_at": "2026-10-24T03:15:00.123456+00:00",
  "id": "9007199254740993"
}
これはカーソルの中身を説明する例です。API上ではJSONをBase64urlなどで符号化しても構いませんが、符号化は暗号化ではありません。機密情報を含めず、サーバー側でバージョン、長さ、キー、日時形式、IDの形式を検証します。必要なら署名付きトークンにし、有効期限を設けます。
bigintのIDをJavaScriptのNumberへ変換すると、値によっては正確に表せません。文字列のまま受け渡し、SQLパラメーターへ型を指定して渡します。日時もデータベースが持つマイクロ秒精度を、JavaScriptのDateなどでミリ秒へ丸めてからカーソルへ戻さないようにします。境界が変わると重複や欠落の原因になります。
検索語、カテゴリー、並び順を変えたら、前のカーソルは捨てて最初から取得します。APIはカーソルへ検索条件の識別子を含めるか、条件が一致しないカーソルを拒否する契約にしておくと、画面側の不具合を発見しやすくなります。
スポンサーリンク
更新中の一覧を完全固定する仕組みではない
カーソルより新しい行が後から追加されても、次ページの開始位置は件数ずれの影響を受けにくくなります。ただし、閲覧途中で既存行の公開日時が変われば、その行が境界をまたぐ可能性があります。削除された行は出なくなり、過去日時で追加した行は途中に入ります。カーソル方式だけで「最初に見た時点の完全な一覧」を保証することはできません。
監査用エクスポートなどで固定結果が必要なら、スナップショット、ジョブ開始時点の結果集合の保存、変更されない連番による対象固定など、別の整合性設計を検討します。上限日時を追加するだけでは、既存行の更新や過去日時での追加をすべて防げないため、要件を先に定義してください。
インデックスと実行計画で確認する
例のインデックスは先頭にtenant_id、その後に降順の二つのキーを置いています。フィルターが増えたり、異なる並び順を許したりすると、同じ索引で効率よく処理できるとは限りません。PostgreSQLの複数列インデックスの説明を基に、実データへ近い分布でEXPLAIN (ANALYZE, BUFFERS)を比較します。ANALYZEは実際に問い合わせを実行するため、負荷を許容できる検証環境で行います。
測る対象は平均時間だけでなく、深い位置で読んだ行数、バッファー読み取り、ソートの有無です。本稿では実データベースでの速度比較を行っていないため、何倍速いという数値は示しません。実行計画が期待どおりでも、結合先や返す本文の大きさが全体の応答時間を支配する場合があります。
境界データを用意してテストする
- 公開日時が同じ行を1ページ以上並べ、全ページを連結したIDが重複も欠落もないか確認する。
- 21件取得して20件表示し、20件目を境界にその次の行から次ページが始まるか確認する。
- 最後のページが0件、20件ちょうど、20件未満の各場合でnext_cursorの有無を確認する。
- 巨大なIDとマイクロ秒を含む日時が、符号化と復号で変わらないか確認する。
- 途中の追加・削除・公開日時変更を試し、仕様として許す変化をUIとAPI契約へ記載する。
カーソル方式は「次のまとまりを読む」操作に向いた設計です。並び順を一意にし、最後に返した行から続け、キーの精度を保つ。この三つを揃えたうえで、任意ページへの移動と結果の固定性をどこまで求めるかを決めましょう。