目次
GitHubは2026年10月28日、複数モデルを実行時に選び、必要に応じて組み合わせる「GitHub Copilot Fusion」を一般提供しました。利用者が毎回モデル名を選ぶ代わりに、Standard・High・Maxの作業強度を指定すると、Fusionがモデルと実行パターンを決めます。Visual Studio Code、GitHub Copilot app、Copilot 、JetBrains IDEsが対象です。
同日には、ローカルモデルとモデルの自動振り分けも実験的プレビューとして始まりました。ただし、Fusionを選べば常に安く、高速になり、端末内だけで処理できるわけではありません。本稿では一般提供されたモデルルーティングの仕組み、AIクレジットの考え方、組織ポリシー、ローカル推論の適用条件を整理し、チームで導入前に確かめる手順を示します。
スポンサーリンク
Copilot Fusionはモデル名ではなく実行方式を選ぶ
GitHubの一般提供発表によると、FusionはProject HydraFusionの複数モデル協調と、従来の自動モデル選択を統合した仕組みです。モデルピッカーに表示されますが、単一のモデルではありません。リクエストごとに難しさ、コード生成、デバッグ、ツール利用などの能力信号を評価し、モデルと推論強度、処理の組み方を選びます。
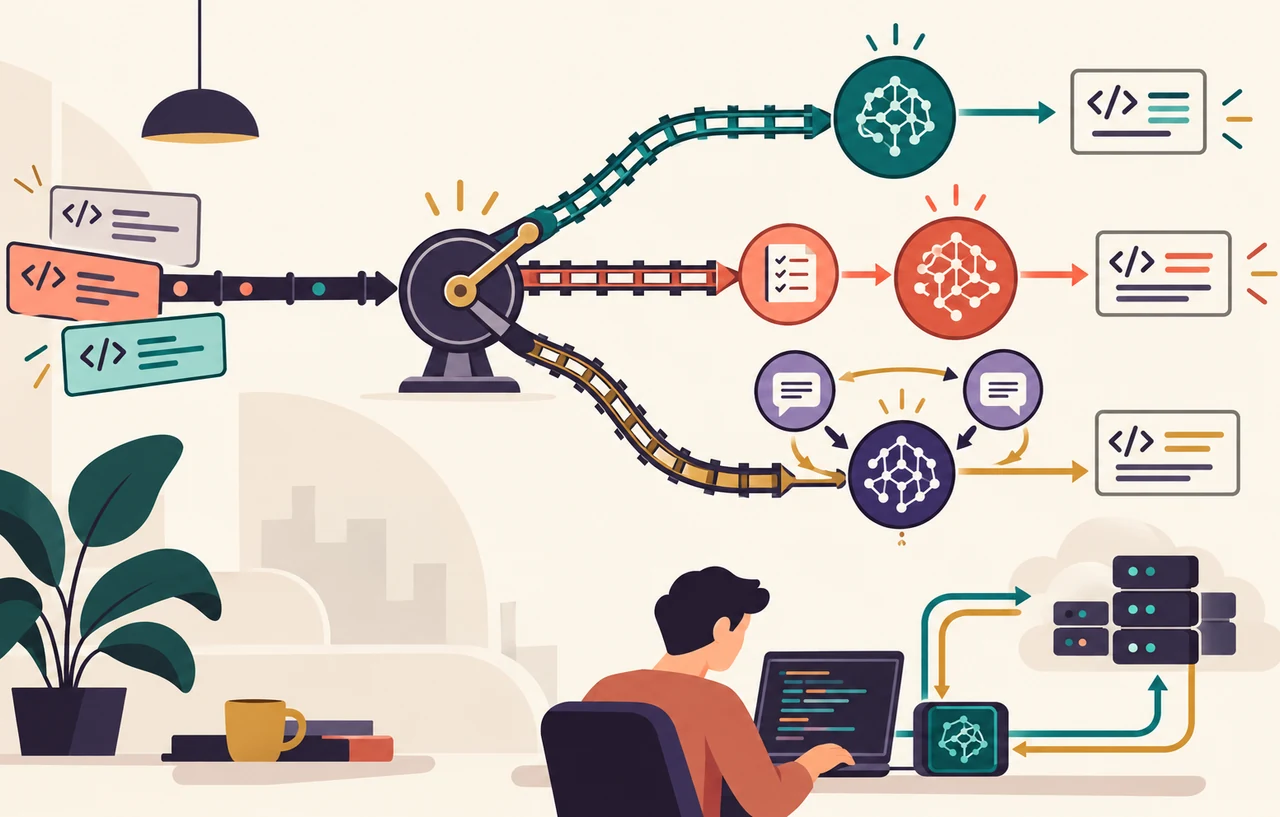
公式資料が示す実行パターンは三つです。Singleは一つのモデルが直接処理します。Cascadeは効率のよいモデルが最初の回答を作り、判定役が受理するか、より強いモデルへやり直しを求めます。Critiqueは主担当の案を複数のモデルが独立に確認し、意見を集約したうえで主担当が修正します。簡単な依頼へ常に複数回のモデル呼び出しを追加する設計ではありません。
| 実行パターン | 向く作業 | 導入時に見る指標 |
|---|---|---|
| Single | 説明、局所的な修正、定型的な変換 | 応答時間、初回完了率、AIクレジット |
| Cascade | 軽いモデルで開始し、難しい場合だけ強化したい作業 | 昇格率、やり直し後の改善、総所要時間 |
| Critique | 広い変更、設計判断、見落としを減らしたい作業 | レビューで検出した問題、修正後のテスト合格率、総費用 |
どのパターンが選ばれるかは同じ会話内でも変わります。最初の質問がSingleでも、複雑な追加依頼はCritiqueになる可能性があります。処理中は各段階と使用モデルを確認でき、完了後は強度名にカーソルを合わせて使われたモデルの一覧を見られます。一方、破棄された中間案は最終回答として表示されません。
Standard・High・Maxは品質だけで選ばない
GitHub DocsのCopilot Fusion解説では、Standardは日常作業で費用・品質・待ち時間の均衡を取る設定、Highは複数ファイルの修正や複雑なバグのような十分に範囲を定めた作業、Maxは深い推論と丁寧な分析が必要な作業とされています。VS Codeのインラインチャットには利用者が選べないFusion Fastもあります。
強度を上げるほど必ず正解になるとは限りません。HighとMaxでは複数モデルを使う可能性があるため、Standardより待ち時間とAIクレジットが増える場合があります。GitHubはFusion自体に別料金を設けず、実際に使った各モデルの標準レートで課金すると説明しています。有料プラン向けの30%割引は2026年11月30日までの期間限定です。割引後だけで本番の予算を決めず、通常レートへ戻った場合も見積もります。
導入試験では、三つの強度を同じ十数件の課題で比較します。小さな修正、複数ファイル変更、失敗するテストの原因特定、既存設計に沿った機能追加を混ぜ、完成率、重大な誤り、所要時間、利用モデル、AIクレジット、人が直した時間を記録します。公開ベンチマークの順位は参考になりますが、自社のや受け入れ条件を代替しません。
コンテキスト上限もFusion固有の一つの値ではありません。各段階は選ばれたモデルの上限で動き、画面には候補中の小さい上限を基にした保守的な値が表示されます。GitHubは、会話の主担当をできるだけ維持してを生かし、補助するレビュー役へは必要な文脈だけを渡すと説明しています。長い会話では、モデル名だけでなく入力の切れ方や参照漏れも評価項目にします。
スポンサーリンク
破棄された案のファイル変更は自動で戻らない
Fusionの制約で見落としやすいのが、モデルの案とワークスペースの状態は別だという点です。公式Docsは、Fusionが途中案を破棄しても、その案がすでに行ったファイル編集は自動的に取り消されないと明記しています。最終回答が整っていても、不要な編集、生成ファイル、依存追加が残る可能性があります。
そのため、導入時はクリーンなで実行し、終了後にgit status、差分、依存、生成物、テスト結果を確認します。Fusionはサブエージェントを自動起動する仕組みでもありません。既存のカスタムエージェントやと組み合わせる場合は、モデルルーティングと作業分担を別の層として記録します。既存記事のマルチエージェントを本番へ移す条件で扱った役割分担と、今回のモデル協調を同じものとして数えないことが重要です。
組織ポリシーがFusionのモデル候補を決める
Fusionが自由にすべてのモデルを使うわけではありません。契約プランで利用できないモデル、管理者が無効にしたモデル、データレジデンシーやFedRAMP要件に合わないモデル、評価モデルを制限するポリシーの対象は候補から除外されます。利用可能な候補が一つもなければ、Fusion自体がモデルピッカーへ表示されません。
Enterprise管理者は、通常利用では許可したモデルをFusionの候補からだけ外すこともできます。また、Fusionの強度を既定値にできます。導入担当者は「Fusionを有効にしたか」だけでなく、候補モデル、データ所在地の制約、評価モデルの扱い、既定の強度を記録します。モデル候補と実行パターンは将来変わり得るため、固定モデルを前提にした監査証跡や品質保証には向きません。
モデル移行を組織単位で管理する方法は、関連記事のCopilotのモデル廃止にどう備えるかで解説しています。Fusionの評価でも、許可モデルを変更した日と前後の完了率・費用を関連付けると、ルーターの変化と課題自体の変化を分けやすくなります。
スポンサーリンク
ローカルモデル自動選択は別の実験的プレビュー
ローカルモデル選択の発表は、Fusion本体の一般提供とは提供段階が異なります。ローカルとクラウドの自動振り分けはオプトインの実験的プレビューで、Standardだけが対象です。Copilot appではExperimental設定のLocal model auto routing、CLIでは実験モードを有効にします。VS Codeではchat.copilot.localModel.enabledを使います。
WindowsではWindows ML経由でMAI Code 1.1 Flashを管理ダウンロードできます。CLIではWindows、macOS、上のOpenAI互換サーバーへMAI Code 1.1 FlashまたはQwen3.8 Flash Nextを構成する方法も示されています。ただし、BYOKへモデルを追加しただけではFusionの自動選択候補になりません。Copilot appの自動ルーティングは現時点で管理されたWindows MLモデルに限られます。
Copilot appのモデル追加手順では、MAI Code 1.1 Flashに96GBの利用可能な合計RAMと60GBのストレージ、NVIDIA GPU、対応するllama.cppを要件として示しています。別の対応モデルであるFlint NVFP4も直接選択できますが、Fusionの自動選択対象として案内されているのはMAI Code 1.1 Flashです。画面に表示されるローカルモデルと、自動選択できるモデルを区別します。
「ローカル」という名称だけで、Fusionの全体をオフライン処理と判断してはいけません。GitHubは、Fusionのルーティング判断はクラウドで行われ、ローカルモデルの安全対策はGitHub提供のクラウドモデルと異なる場合があると説明しています。端末内モデルを直接選択して使う場合と、Fusionで自動振り分けする場合では通信経路が違います。機密データの取り扱いを決めるときは、推論場所だけでなく、ルーティング、認証、ログ、ツール接続まで確認します。
また、同じローカルモデルをCopilot CLI、Copilot app、VS Codeで同時に動かすと、各画面が別々にモデルをメモリへ読み込み、RAM不足になる可能性があると公式Docsは注意しています。検証端末では一つの画面から始め、メモリ使用量、初回ロード時間、連続処理時の温度と速度、クラウドへの切り替わりを記録します。
導入は小さな比較セットから始める
- 利用するクライアントを更新し、組織ポリシーと表示される候補モデルを保存する。
- 同じ課題を固定モデル、Fusion Standard、High、Maxで実行する。
- 利用モデル、実行パターン、時間、AIクレジット、テスト結果、人の修正を記録する。
- 終了後は最終回答だけでなく、ワークスペースの全差分と依存変更を確認する。
- ローカルルーティングは別試験にし、クラウド通信と端末資源を測る。
- 割引終了後の標準レートで月間費用を再計算する。
Fusionの利点は、開発者がモデル名を覚え続ける負担を減らし、簡単な依頼と難しい依頼でモデル呼び出しを変えられることです。一方、候補モデル、協調方法、費用が実行ごとに変わるため、「どのモデルを採用したか」だけでは評価できません。固定した課題と受け入れ条件を用意し、ルーターを含む一つの実行系として比較してください。