目次
AWSは2026年10月21日、データ分析用の実装「Deep Insight」を題材に、マルチエージェントを本番運用へ移す際の五つの課題を公開しました。注目点は、複数のAIを並べたことではありません。処理順をグラフで固定し、計画を人が承認し、計算を別の担当が検証し、生成コードを隔離して実行し、失敗を追跡できる構成まで一体で示したことです。
本稿は新サービスの速報ではなく、公開されたAWSの技術記事「5 production challenges in multi-agent systems」とDeep Insightの公式リポジトリを基にした導入判断の解説です。自社のAI機能を一つの万能エージェントから分業構成へ変えるべきか、変えるならどこを固定し、何を測るべきかを整理します。
スポンサーリンク
八つの担当を置く前に「分業が必要な理由」を決める
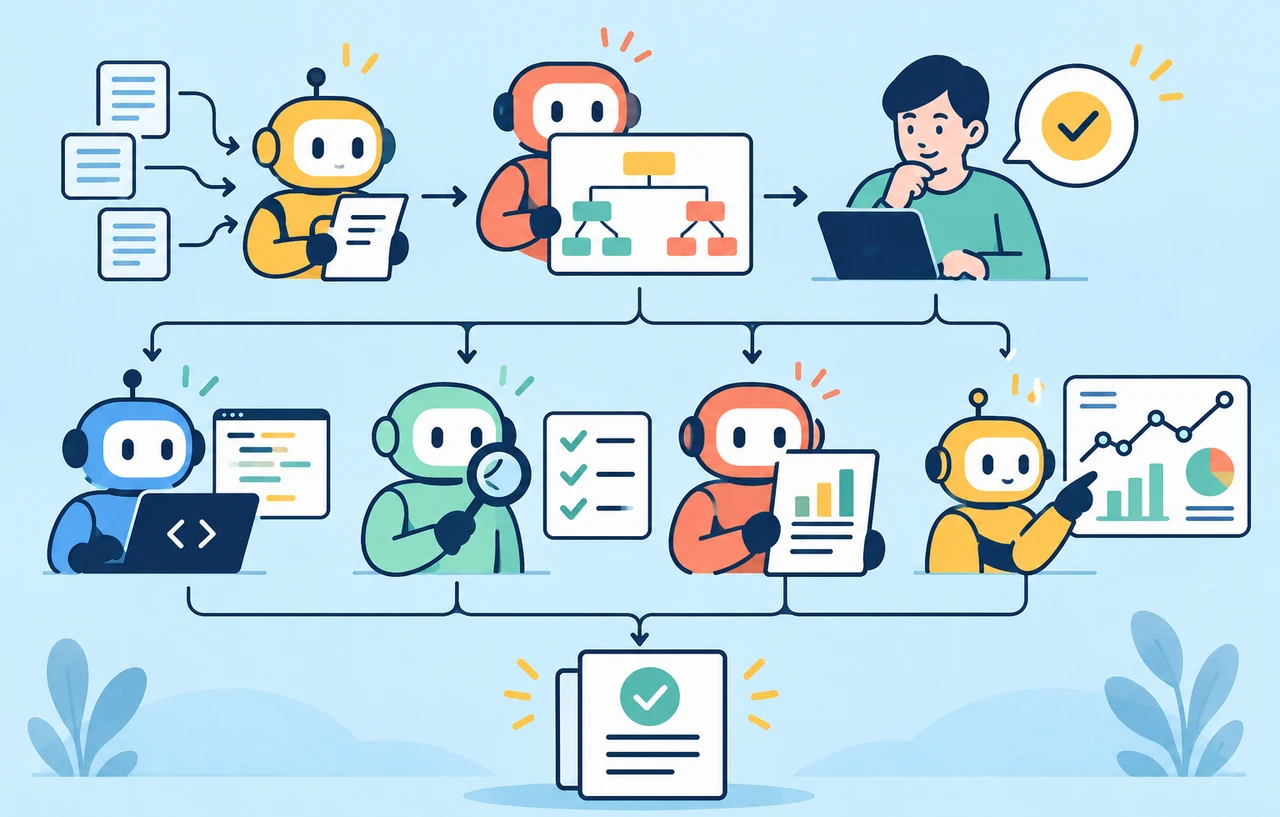
Deep Insightは、CSVと自然言語の依頼から分析、グラフ、検算、引用付きDOCXレポートを作るシステムです。Coordinator、Planner、Plan Reviewer、Supervisor、Coder、Validator、Reporter、Trackerという八つの役割を使います。各担当は独立したコンテキストで自分の作業だけを行い、結果を次へ渡します。
この分割には具体的な境界があります。Coordinatorは依頼を振り分け、Plannerは実行可能な手順へ分解し、Plan Reviewerは利用者へ計画を提示します。承認後はSupervisorが専門担当を呼び、Coderが分析コードと成果物を作り、Validatorが元データから計算をやり直し、Reporterが検証済み情報をレポートへまとめ、Trackerが完了状態を更新します。
自社で同じ数のエージェントを作る必要はありません。重要なのは、分割ごとに入力、出力、責任、合格条件が変わることです。「精度が上がりそう」という理由だけで担当を増やすと、呼び出し回数、待ち時間、障害点、追跡対象が増えます。単一モデルと通常コードで十分な分類や変換は分けず、独立した検証や人の承認が必要な箇所から切り出す方が判断しやすくなります。
自由な会話だけにせず実行順をグラフへ移す
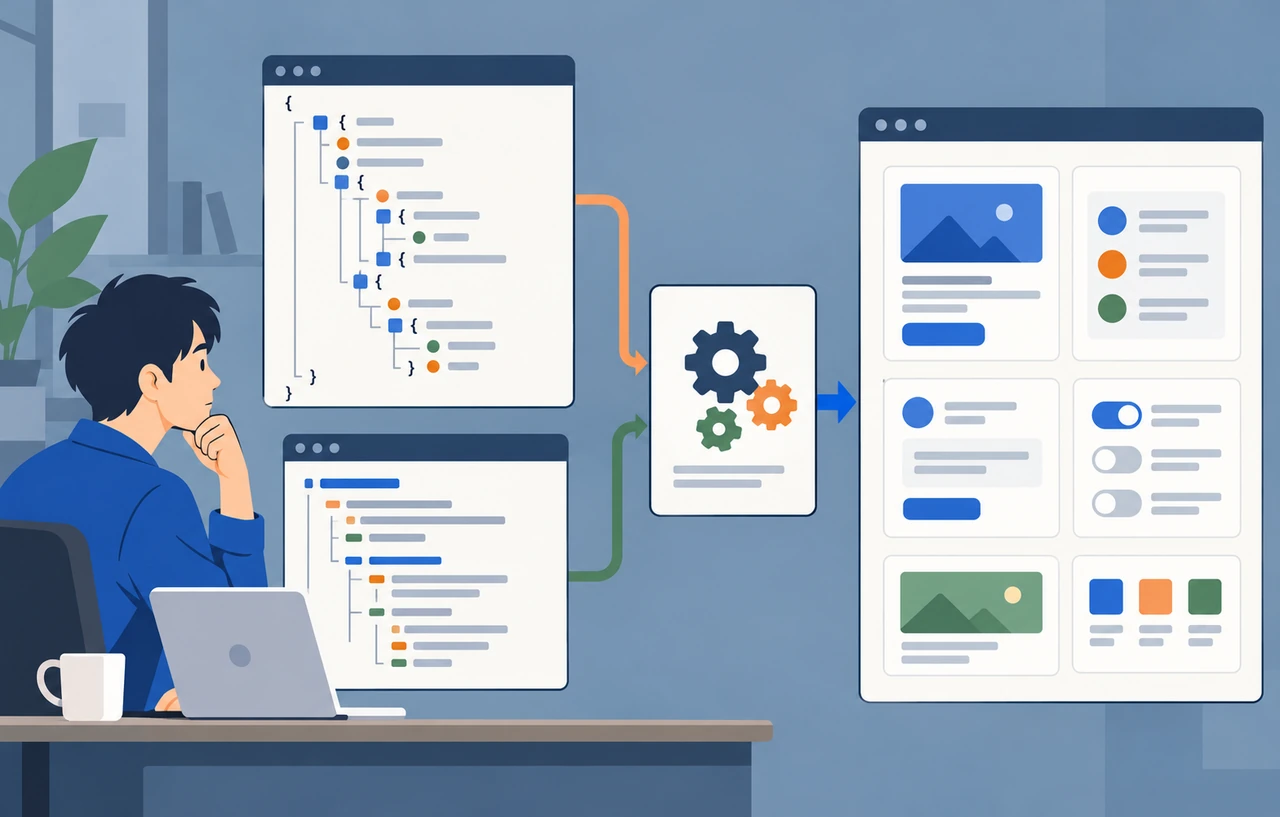
Deep InsightはStrands Agents のGraphパターンで、CoordinatorからPlanner、Plan Reviewer、Supervisorへ進む順序を定義します。計画に修正指示があればPlannerへ戻り、承認された場合だけSupervisorへ進みます。専門担当はAgents as ToolsパターンでSupervisorから必要なときに呼び出されます。
この設計の意味は、モデルに毎回「次は何をすべきか」まで自由判断させないことです。業務上必須の承認、検証、成果物作成を制御フローへ置けば、指示文の解釈が揺れても工程そのものを守りやすくなります。一方、分析方法や文章化のように状況へ応じた判断が必要な部分は、専門エージェントへ委ねられます。
公開実装では計画の修正回数とノード実行回数に上限があり、無限に差し戻す状態を防ぎます。Web版の計画確認は300秒後に自動承認される仕様です。この値をそのまま採用するのではなく、自社では「応答がない」を承認とみなせるかを先に決める必要があります。支出、公開、削除など影響の大きい操作なら、期限切れは停止へ倒す方が業務要件に合う場合があります。
スポンサーリンク
計画の承認と結果の検証は別のゲートにする
Plan Reviewerが確認するのは、何をどの順序で行うかという計画です。正しい計画を承認しても、Coderが作った計算やグラフが正しいとは限りません。そこでValidatorは、Coderの説明をそのまま採用せず、計算メタデータと元データを読み、対象の計算を再実行します。公開記事の例では差が0.01以内なら合格とし、検証済みの値を引用情報へ渡します。
この分離は、生成物を別のAIに「レビューして」と頼むだけとは異なります。検証担当が同じ中間結果だけを読めば、最初の誤りを共有する可能性があります。元データ、期待する計算式、生成物を対応付け、通常コードで比較できる項目は決定的な判定へ寄せます。許容差は金額、割合、丸め規則など業務単位で定義し、サンプルの0.01を万能な基準にしません。
また、Trackerは各専門担当の後にチェックリストを更新し、未完了項目があれば次へ進まない規則を支えます。ただし、公開実装のTrackerもの判断です。「完了と記録された」ことと「成果物が存在し内容が合格した」ことは分けます。ファイル生成、データ保存、外部の反映などは実際の状態をコードで確認し、その結果を進行条件に使う設計が必要です。
モデルは全体で一つ選ばず役割ごとに配分する
Deep Insightは、軽い振り分けをHaiku、複雑な計画を拡張思考付きOpus、実行・検証・報告・進捗管理をSonnetへ割り当てます。さらに、同じ長いシステム指示やツール定義を繰り返すSupervisor、Coder、Reporterではを使い、入力費用を抑える構成です。異なる内容を扱うValidatorとTrackerではキャッシュを使いません。
これは「最も高性能なモデルをどこでも使う」構成でも、「安いモデルへ全面移行する」構成でもありません。失敗したときの影響と、仕事の難しさを担当ごとに分けています。自社で比較する場合も、モデル単価だけでなく、一件を完了するまでの呼び出し回数、キャッシュ命中、再試行、検証、人の差し戻しを合計します。
モデル名を先に固定するより、まず担当ごとの評価ケースを作ります。Coordinatorには誤ルーティング率、Plannerには必須工程の欠落、Coderには実行成功と成果物、Validatorには誤りの検出率、Reporterには根拠との一致を設定できます。モデルを変えるときは一つの役割だけを同じ条件で比較すれば、全体の品質差を原因不明のまま受け入れずに済みます。
スポンサーリンク
開発環境の実行方法を本番へ持ち込まない
公開実装のセルフホスト版は、生成したPythonをローカルのsubprocessで動かします。素早く試せる一方、本番で同じ方法を使えば、システムファイル、計算資源、他利用者のデータへ影響する余地が広がります。Managed AgentCore版では、セッションごとに一時的なFargateコンテナを用意し、生成コードを分離して実行します。
公開された構成では、AgentCore、ALB、FargateをプライベートVPC内に置き、S3、Bedrock、ECRへVPCで接続します。セキュリティグループとで到達先と権限を絞り、成果物はS3へ移した後、コンテナは一時間で終了します。ALBのスティッキーセッションは、一連の処理を同じ実行環境へ戻すために使われます。
ここで読み違えてはいけないのは、コンテナ化だけで生成内容の正しさまで保証されない点です。AWSの記事も、Validatorは計算を再確認する一方、アップロードデータに隠れたや、生成文章の有害性・根拠不足までは検出しないと説明しています。実行環境の隔離、入力の扱い、出力の根拠確認は別の対策として設計します。
ダッシュボードは成功率より原因を追える形にする
Deep InsightのOpsダッシュボードは、処理状態、トークン使用量、経過時間をDynamoDBへ記録し、失敗時はSNSで管理者へ通知します。2026年10月の更新では、各ジョブについてエージェントの実行順、計画承認、ツール呼び出し、生成コードと出力、成果物を追跡できる機能も案内されています。ブラウザーのストリームが切れても、が最終状態を報告する設計です。
本番監視では「 200だった」「最終レポートが作られた」だけでは不十分です。どの役割で止まったか、何回再試行したか、承認前後で計画がどう変わったか、検証に不一致があったか、成果物と引用がそろったかを追います。利用者の画面接続が切れたことと、バックエンド処理の失敗も分けます。
評価ハーネスで完成・正確さ・費用を同時に測る
公式リポジトリには評価ハーネスがあり、固定した分析依頼を実行して、レポート・引用・検証ファイルがそろったか、数値が元CSVと一致するか、一件当たりの費用、キャッシュ命中率、所要時間、コード実行の失敗を記録します。変更前後を同じシナリオで複数回比較できる構成です。
導入判断では、平均の品質点だけでなく、工程別の失敗と総費用を一緒に見ます。専門担当を増やして正確さが上がっても、処理時間や障害率が許容できなければ本番要件を満たしません。逆に、安いモデルへ置き換えて一回の呼び出し単価が下がっても、再試行と人の修正が増えれば総費用は上がります。
最初の比較対象は、現在の単一エージェントまたは人の手順です。同じ入力で、完成率、重大な誤り、所要時間、モデル費用、人の確認時間を測ります。分業構成は役割ごとに一つずつ加え、どの境界がどの失敗を減らしたかを確認します。評価セットの作り方は、関連記事のAIの改善を勘で判断しないために|評価データと回帰テストの始め方で詳しく整理しています。
採用前に確認する七つの条件
- 分業する役割ごとに入力、出力、責任、合格条件が決まっている。
- 必須の順序、差し戻し、停止、実行回数の上限が制御フローにある。
- 計画承認と成果物検証を分け、無応答時の扱いを業務影響に合わせている。
- 元データから独立して確認できる値は、通常コードでも再計算する。
- モデルを役割別に評価し、再試行と人の確認を含む総費用を測る。
- 生成コードを利用者・セッション単位で隔離し、権限、通信、寿命を制限する。
- エージェント順、承認、ツール実行、検証結果、最終成果物を追跡できる。
Deep Insightの価値は、八つの名前をそのまま模倣できることではありません。モデルの判断へ任せる部分と、コードや人の承認で固定する部分を分け、開発時の便利な実行方法を本番の隔離環境へ置き換え、変更を測る仕組みまで公開していることです。自社では必要な役割だけを採用し、一つの失敗原因を観測・修正できる小さな構成から始めてください。
スポンサーリンク