目次
GitHub CopilotをVS Codeの補完やチャットだけでなく、OpenCode、Claude Code、Codex、Zedなどのクライアントからモデルプロバイダーとして使う選択肢が増えています。ところが、導入したツールが実際に使われているのか、どのツールがトークンを多く消費しているのかをIDE別の数字だけで判断すると、外部クライアントの利用が集計から抜けることがありました。
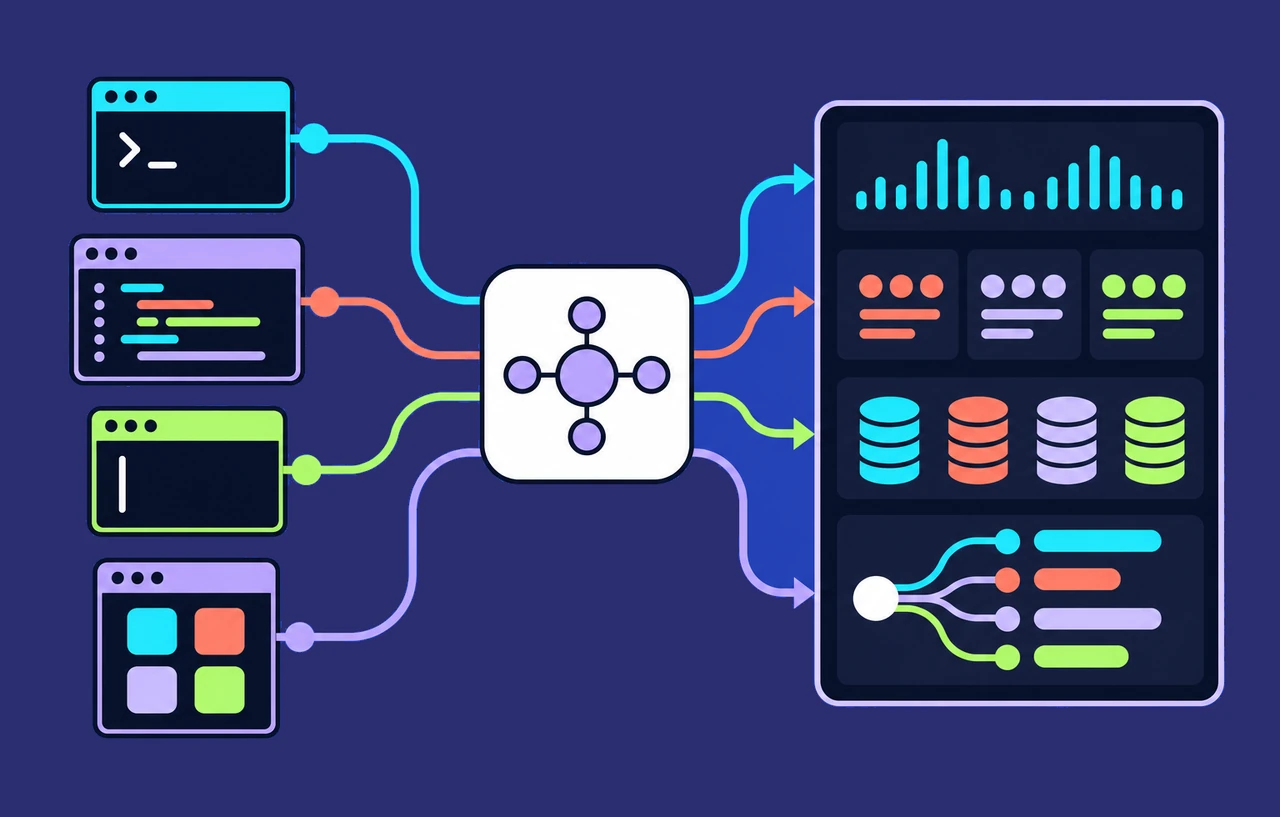
GitHubは2026年10月23日、Copilot usage metrics APIにtotals_by_clientを追加したと発表しました。新しい配列は、Copilotを利用するクライアントごとに、成功したモデル呼び出し、セッション、入出力トークン、モデル別の利用を集計します。これは新しいコーディング機能ではなく、既存の利用状況を判断するための観測機能です。
本稿は2026年10月25日にGitHub Changelogの発表とCopilot usage metrics REST APIの公式資料を確認した開発者向けAIトレンド記事です。フィールドで確認できる事実と、本サイトが提案する比較方法を分けながら、ツール継続・統合・廃止の判断へつなげます。
スポンサーリンク
IDEの外で使うCopilotをクライアント単位で見られる
GitHubの発表によると、totals_by_clientは企業、組織、企業ユーザー、組織ユーザーの1日レポートと28日レポートへ追加されました。28日集計では、各日のday_totals内に配列が入ります。既存フィールドを変更するのではなく追加する更新で、利用がない場合は空配列になります。
clientには、例としてopencode、claude_code、codex、zed、copilot_cli、github_app、cloud_agent、code_review、vscode、jetbrainsが示されています。認識できないクライアントはotherへまとめられます。名称は利用者が自由入力したアプリ名ではなく、各統合が送信するintegration IDを基にした最善努力の分類です。したがって、クライアント名を本人確認済みの識別子や厳密な資産台帳として扱うことはできません。
前日の「GitHub CopilotのMCPを棚卸しする|既定ポリシーと利用メトリクスの運用設計」では、MCP、スキル、エージェントなどの設定名を追うメトリクスを扱いました。今回のtotals_by_clientは拡張の名前ではなく、モデル要求を送ったクライアントを軸にします。同じCopilot CLIで複数のスキルを使う場合も、クライアント比較とスキル比較は別の切り口です。
四つの数字は同じ母数ではない
| フィールド | 確認できること | 読み違えやすい点 |
|---|---|---|
request_count | 成功したモデル呼び出しの数 | 利用者が送ったプロンプト数ではない |
session_count | クライアント内の異なるセッション数 | 作業件数や完了タスク数とは一致しない |
token_usage | 入力・出力トークンと1要求当たり平均 | 請求額や成果物の品質を直接表さない |
totals_by_model | モデル別の要求・トークンと選択方法 | unknownや製品側選択を利用者選択と混同しない |
最も重要な注意点は、request_countがプロンプト数ではなくモデル呼び出し数だということです。一つの依頼を処理する途中で、計画、コード生成、要約、再評価など複数のモデル呼び出しが起きれば、利用者の操作は一回でも要求数は増えます。要求数を「開発者が何回質問したか」や「何件のタスクを完了したか」と直接比較すると、エージェント型クライアントほど不利に見える可能性があります。
セッション数も成果件数ではありません。長い一つのセッションで複数の変更を進める使い方と、短いセッションをタスクごとに分ける使い方では値が変わります。本サイトでは、request_count ÷ session_countを作業の複雑さそのものとは呼ばず、「一セッション当たりモデル呼び出し密度」のような観測指標として扱うことを提案します。急増時は、複雑な作業が増えたのか、再試行が増えたのか、クライアント更新で内部処理が変わったのかを調べます。
token_usageは費用や応答時間を考える材料になりますが、GitHubの発表はこの値を請求明細とは説明していません。プロンプトと出力のトークン量が分かっても、プランの包括枠、プレミアム要求、モデルごとの乗数、製品側の内部処理を含む実際の請求とは別です。コストを判断するときは、契約・請求データと同じ期間、組織、モデルへ揃えた上で照合します。
スポンサーリンク
モデル選択は三つの経路に分かれる
totals_by_modelにはmodel_selection_modeが入り、利用者が直接指定したuser_selected、自動選択のauto、製品が選んだproduct_selectedを区別します。まだ個別に報告されない選択方法はother、正規化できない値はunknownです。
GitHubは、Copilot code reviewとCopilot cloud agentについて、製品がモデルを選ぶためproduct_selectedになると説明しています。さらにコードレビューのモデル名はunknownとして報告されます。そのため、モデル別の表だけを見て「このチームは不明なモデルを手動で大量に選んだ」と結論付けることはできません。クライアントと選択方法を同時に見て、製品仕様による不明値を分けます。
運用では、手動指定率を高い・低いだけで評価しない方がよいでしょう。固定モデルが必要な再現性の高い検証ではuser_selectedが妥当です。日常的なコード補完ではautoが速度と品質のバランスを取りやすい場合があります。cloud agentやcode reviewではproduct_selectedが通常です。目的別の期待値を先に決め、逸脱したときだけ理由を確認します。
エージェントアプリの活動件数とは別物
GitHubはtotals_by_clientとagent app activityを明確に区別しています。前者はCopilotを使ったモデル要求とトークンを数えます。後者はGitHub上でClaudeやCodexなどのエージェントアプリが開始したジョブを数えます。外部クライアントから一つのジョブが複数回モデルを呼ぶ可能性があるため、二つの数字が一致しないのは異常ではありません。
GitHub Docsのメトリクス差異の解説でも、totals_by_3rd_party_agent[].user_initiated_interaction_countとトップレベルのuser_initiated_interaction_countを照合しないよう案内しています。CLIの利用もIDEテレメトリーとは別に集計され、CLI利用はIDEのアクティブ利用者数へ加算されません。比較表には、各数字のイベント、収集場所、時間窓を記載する必要があります。
スポンサーリンク
3日待ってから同じ期間を比較する
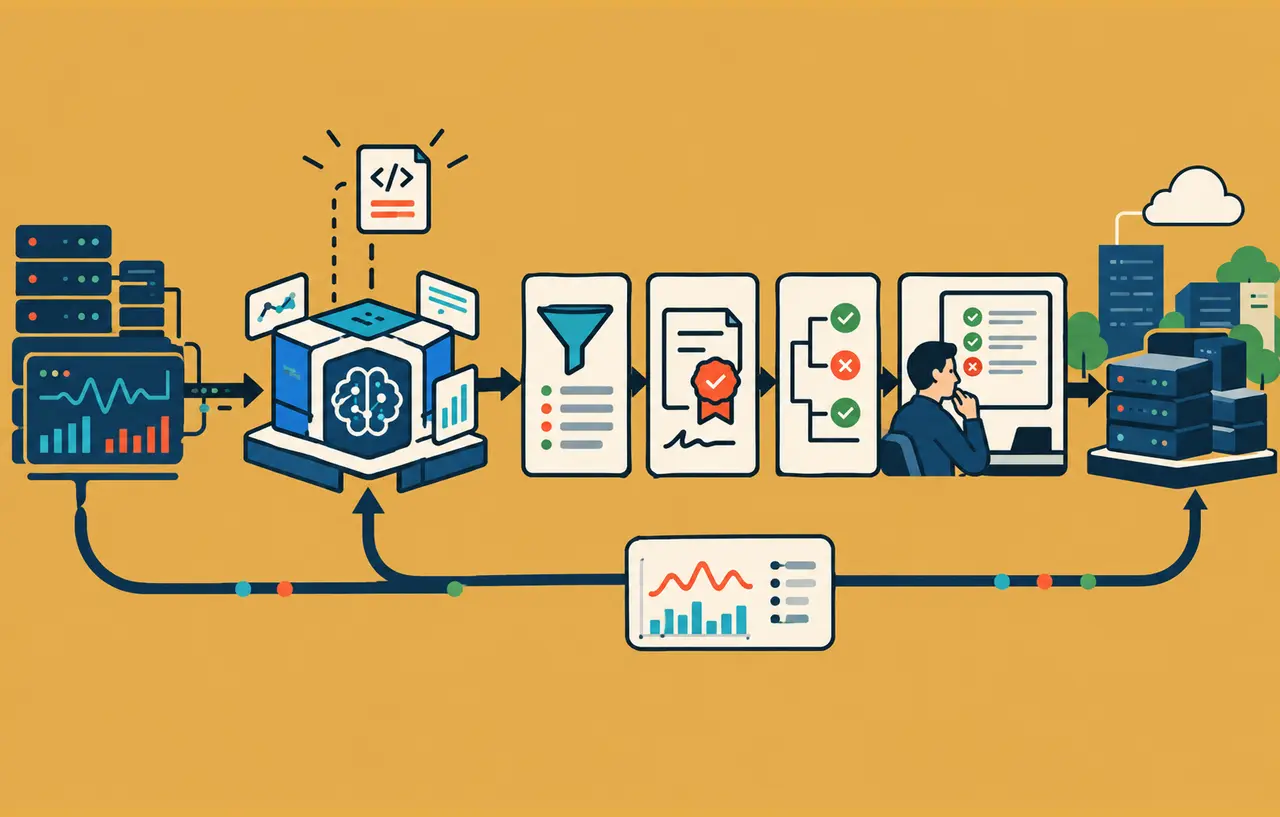
GitHub Docsによると、IDEテレメトリーは非同期で処理され、直近の日付は未完成に見える場合があります。通常は完全なUTC日で3日以内に確定し、早く書き出したNDJSONは再取得すると値が変わる可能性があります。日次ダッシュボードを作る場合、速報値と確定値を同じ系列へ上書きせず、取得日時と対象日を保存します。
REST APIはレポート本体ではなく、期限付きの署名付きURLを返します。企業・組織の1日版と最新28日版があり、企業のエンドポイントを有効にするにはCopilot usage metricsポリシーをEnabled everywhereにする必要があります。取得できるのは企業所有者、請求管理者、組織所有者、対応する閲覧権限を持つカスタムロールなどです。定期処理ではURLだけを保存せず、期限内にNDJSONを回収し、対象期間、スコープ、取得時刻、スキーマ版を一緒に保管します。
IDEテレメトリーを無効にした利用者では、IDE・機能・言語・行数などの詳細が欠ける一方、サーバー側テレメトリーによりアクティブ利用者として現れる場合があります。トップレベルの利用者数が内訳の合計を上回っても、直ちにデータ破損とは言えません。今回のサーバー側クライアント集計は外部ツールの盲点を減らしますが、すべての内訳を補完するものではありません。
導入判断は利用量と成果を二段で見る
本サイトでは、最初の28日を観測期間とし、ツールごとのモデル利用量を成果指標と分ける方法を提案します。利用量の表にはクライアント、要求、セッション、入出力トークン、モデル、選択方法を置きます。成果の表には、完了タスク、採用された変更、レビュー差し戻し、CI通過、作業時間など、自社で測れる値を置きます。二つを日付とチームで結び付けます。
- 利用が少ない場合は、不要と決める前に対象業務、導入案内、認証やクライアント設定の失敗を確認する
- 要求数だけ多い場合は、再試行、長い自律処理、内部サブタスク、エラー回復をサンプリングする
- 出力トークンが多い場合は、成果物に必要な長さか、冗長な説明や生成後の破棄が多いかを調べる
otherが増えた場合は、未承認ツールと断定せず、integration ID、対応版、正規化状況を確認する- モデル選択が想定と違う場合は、利用者設定、auto、製品側選択を切り分ける
モデルやプロンプトを変更した結果の品質は、利用メトリクスだけでは判断できません。「AIの改善を勘で判断しないために|評価データと回帰テストの始め方」で扱った固定評価セットと合格条件を併用し、品質、時間、トークン、運用負担を同じ変更前後で比較してください。利用量が増えたことと、開発成果が良くなったことは別の事実です。
最初に作る集計表
初回は高度なBI画面を作るより、1日1行・クライアント1行の明細を保持する方が再計算しやすくなります。原本のNDJSONを日付別に保存し、派生表には対象日、企業または組織、クライアント、モデル、選択方法、要求数、セッション数、入力・出力トークン、取得時刻を持たせます。3日後に同じ対象日を再取得し、確定値へ更新します。
週次レビューでは、前週差だけでなく構成比も見ます。クライアント別の要求比率、出力トークン比率、モデル選択方法の比率を並べると、利用者数の増減と一件当たり処理量の変化を分けやすくなります。ただし、integration IDによる分類、複数呼び出し、遅延テレメトリーという限界を注記し、個人の生産性順位には使わない方が安全です。
totals_by_clientによって、IDE外のCopilot利用は以前より把握しやすくなりました。採用判断で見るべき順番は、クライアント別の利用を確定値で把握し、モデル呼び出しと人の操作を混同せず、最後に自社の成果・品質・請求と照合することです。新しい配列は答えそのものではなく、外部AI開発ツールを同じ土俵で比較するための共通の観測点になります。