目次
Anthropicは2026年11月2日、ClaudeのMessages でMessage threadsをベータ提供したと発表しました。最初のリクエストで会話履歴を送り、次からは直前の応答IDと追加分だけを送る仕組みです。ツール実行のたびに長い履歴をアップロードするエージェントで、送信量と最初の出力までの待ち時間を減らす候補になります。会話の正本はアプリ側に持ち、スレッドが消えても履歴から再開できる設計が前提です。
Claude PlatformのリリースノートとAnthropicのMessage threads公式ガイドによると、対象はClaude API、Claude Platform on 、Anthropic管理のClaude Models on Google Cloud、Claude in Microsoft Foundryです。Claudeのチャット製品の会話機能ではなく、Messages APIに渡すオプションです。本記事では、顧客対応アプリが複数回のを行うケースを例に、通常のリクエストから何を変えるかを整理します。掲載した手順は公式仕様に基づく設計例で、速度や料金を実測したものではありません。
スポンサーリンク
履歴の送信を減らしてもモデルには会話を渡す
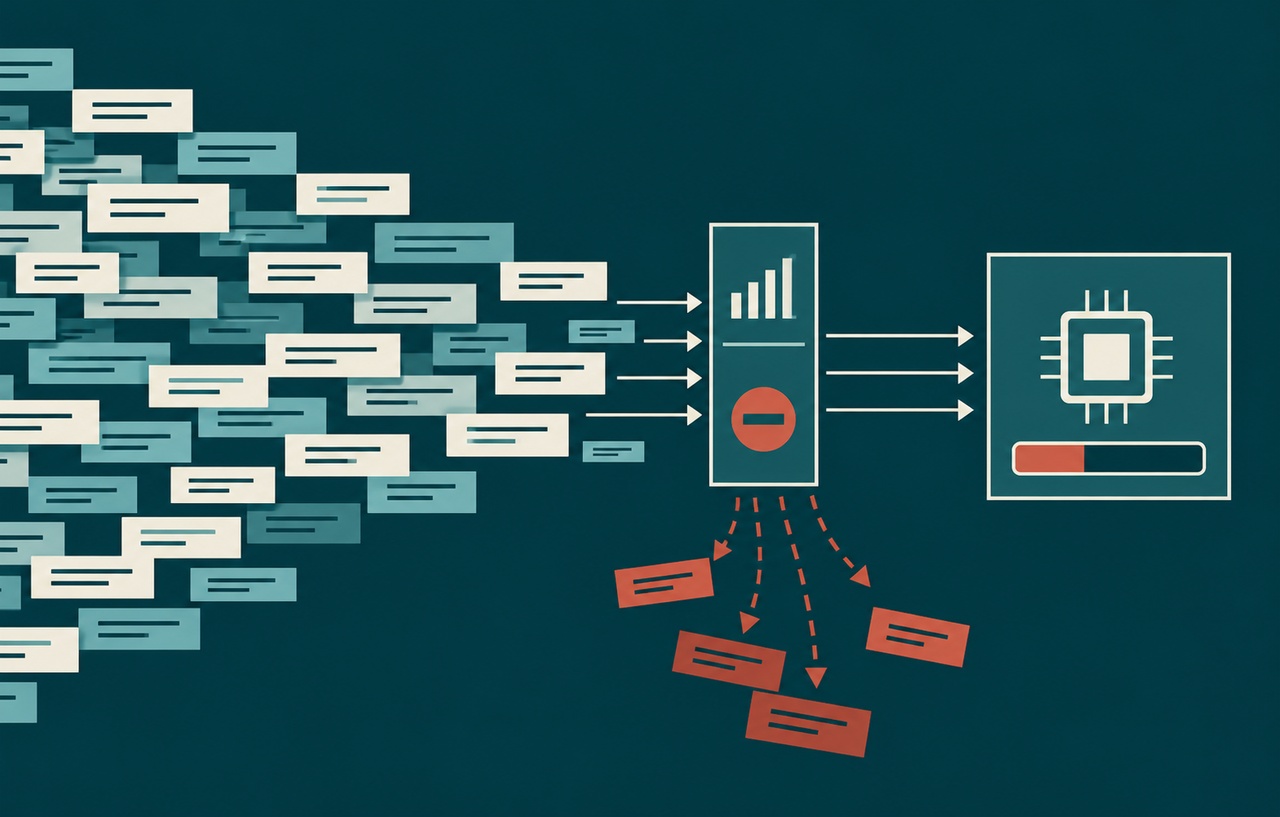
従来の呼び出しでは、注文状況を調べるツールの結果をモデルへ返すたびに、最初の質問からその時点までの履歴をリクエストに入れます。スレッドを使う場合、初回に履歴、システム指示、ツール定義を渡し、次の呼び出しでは新しい利用者メッセージやツール結果だけを送れます。API側で会話を組み直してからモデルを呼び出すため、過去の会話を毎回転送して解析する処理を減らせます。
ここで減るのはクライアントが毎回送るデータです。モデルに渡るコンテキストから過去の会話が削られるわけではありません。したがって、リクエストのバイト数を見ただけで入力トークンや請求額が同じ割合で下がるとは判断できません。長いシステム指示がある場合でも、履歴が短く呼び出しが一回で終わるなら、スレッドを使った場合の復旧処理を追加する価値は小さくなります。
スレッドは最後のリクエストから5分で期限切れになり、最後に使用されてから1時間以内に削除されます。APIが各ターンを保存することも保証されていません。たとえば、問い合わせの中で検索と注文照会を立て続けに実行する用途には試す価値がありますが、利用者が翌朝返信するチャットや、承認待ちで止まる仕事を同じスレッドで維持する前提にはできません。5分は待ち時間を設計する目安であり、4分以内なら必ず継続できるという保証ではありません。
初回と継続で送る項目を分ける
初回はthreadのtypeをcreateにして、通常のMessages APIで使う履歴、system、toolsを送ります。応答は通常のMessageオブジェクトなので、そのidを次回に使います。継続時はtypeをcontinueにして、previous_message_idに直前の応答IDを入れます。messagesには、その応答の後に増えた内容だけを置きます。初回に使ったsystemやtoolsは継続リクエストに入れません。値をnullにして送る場合もエラーになるため、キーそのものを省きます。
次は を使う最小例です。モデルとベータ指定は両方で同じにし、2回目に初回の質問や回答を入れていません。コードにある変数firstのidは、利用者の会話IDではなくAPIの応答IDです。実際にアプリへ入れる場合は、応答を受け取るたびに次回の起点を更新します。
import anthropic

client = anthropic.Anthropic()
options = {
    "model": "claude-opus-5-5",
    "max_tokens": 512,
    "betas": ["message-threads-2026-08-12"],
}

first = client.beta.messages.create(
    **options,
    system="Answer shipping questions briefly.",
    messages=[{"role": "user", "content": "How long does shipping take?"}],
    thread={"type": "create"},
)
second = client.beta.messages.create(
    **options,
    messages=[{"role": "user", "content": "What about weekends?"}],
    thread={"type": "continue", "previous_message_id": first.id},
)
systemやtoolsを送らないことと、ほかの設定をすべて省略できることは別です。モデル、thinking、tool_choice、output_config、上位のcache_control、ベータ指定の集合などは、初回と同じ値を継続でも渡す必要があります。反対に、max_tokens、stream、metadataなどは変更できます。会話の途中で応答形式を切り替えるアプリでは、画面の操作に合わせてoutput_configを直接書き換えるのではなく、履歴を含む新しいcreateへ移るか、従来どおりスレッドなしで送る構成にします。
この区別はツール設計にも効きます。例えば、最初は注文照会だけ、後から返品見積もりを追加するアプリでは、継続時にtoolsを差し替えられません。両方を初回の構成に含められるか、照会と返品を別のスレッドに分けるかを先に決めます。初回の構成をアプリ側で記録しておけば、設定が変わったときに誤って古い応答IDを使うことも防げます。特定のモデルではsystemやtoolsの変更により既存のthinkingブロックが無効になるため、再作成する場合は公式ガイドの条件に従います。
スポンサーリンク
会話の保存と応答IDの更新をアプリ側で行う
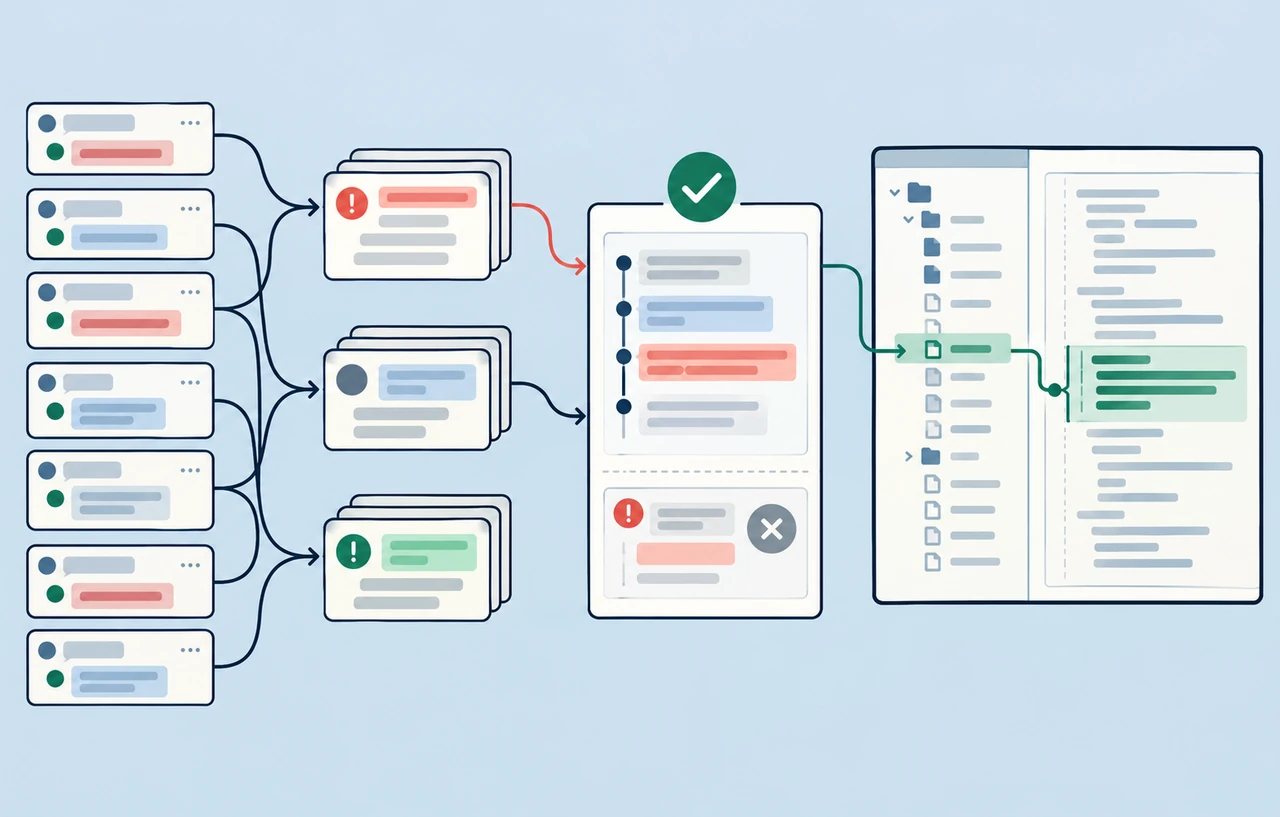
サポートアプリを例に取ると、保存するのは会話ID、利用者メッセージ、確定したモデル応答、ツールの結果、最後に確定した応答IDです。スレッドIDに相当する値だけを持っていても、再作成時に送る履歴がありません。SDKのスレッドヘルパーは履歴をオブジェクトのメモリーに保持しますが、プロセスを越えて保存するものではありません。ワーカーの再起動や別のワーカーでの再開があるなら、自分のから同じ順序で履歴を取り出せるようにします。
同じ応答IDを起点にできる継続は一度だけです。利用者が二つのメッセージを続けて送ったり、ツールのが複数ワーカーに届いたりする場合は、会話ごとに送信を直列化します。後続メッセージは先行処理の完了後に送るか、順序を保ってまとめて渡します。履歴の途中から回答を分岐させる操作は、以前の応答IDをもう一度使うのではなく、その時点までの履歴から別のcreateを作ります。
並列ツール呼び出しがある場合も、ツールの仕事を同時に実行することと、会話の次のターンを同時に二つ作ることは区別します。例えば配送状況と請求情報を別々に照会するなら、結果を対応するツール呼び出しにひも付け、モデルへ返す順序をアプリで確定します。ストリーミングでは途中の表示をそのまま確定済みの履歴とせず、終了イベントまで読めた応答を起点にします。SDKヘルパーが応答を記録するのもmessage_stopに到達したときです。
継続できない理由で再送の方法を変える
404の場合は、まずエラーの詳細がthread_not_foundかを見ます。対象モデルが存在しない場合も404なので、すべての404を履歴再送のきっかけにすると原因を隠します。thread_not_foundは、期限切れのほか、直前の応答が保存されなかった場合などにも起こります。その場合はアプリ側の正本から、必要な新しいメッセージを一度だけ加えた履歴を作り、systemとtoolsも付けてcreateします。すぐに再び継続できなくなる場合は、同じ処理を繰り返さずスレッドなしの実行を検討します。
400でthread_fingerprint_mismatchが返ったら、固定項目の差を調べます。設定変更が意図したものであれば、変更後の値と履歴で新しくcreateします。意図しない差なら、初回の設定と同じ値を組み立て直します。thread_continue_in_flightの場合は、先行する送信の結果を受け取れるなら待ちます。通信が途切れて先行結果を回収できず、同じ継続が拒否された場合は、公式ガイドの復旧経路に従って履歴から再作成します。
モデルのリクエストを作り直せることは、外部の業務処理をもう一度行ってよいことを意味しません。例えば返品受付のように外部状態を変更するツールをすでに実行したなら、同じ業務操作を区別するキーと処理結果を先に残します。再開時には保存済みの結果を会話へ戻せるか確認し、ツール呼び出しが再び生成されても受付を二重に作らないようにします。モデル応答の再取得と、業務処理の再実行の判断を分けておくと、スレッドを切り替えたときにも既存の処理結果を使えます。
スポンサーリンク
送信量とキャッシュ効果を分けて測る
スレッドはそれだけでを有効にしません。キャッシュの比較をするなら、両方で同じ方針を適用し、キャッシュなしの比較とも分けます。公式ガイドでは上位のcache_controlを固定して各ターンに送る方法と、各ブロックに明示する方法を案内しています。明示方式で全履歴から再作成するときは、過去のメッセージにつけたブレークポイントをそのまま積み上げず、上限と必要な位置を点検します。スレッドを使うリクエストの上限は4個で、初回のsystemやtoolsの指定も後のリクエストで数えられます。
導入試験では、同じモデル、同じ会話とツール結果を使い、スレッドなしとありで送信バイト数、リクエスト開始から最初の出力まで、最終応答の完了までをそれぞれ測ります。最初の出力が早くなっても、外部ツールの待ち時間や長い回答が支配的なら、仕事全体の時間はほとんど変わらないことがあります。入力、キャッシュの読み書き、出力に関するusageも記録すると、通信量とAPI利用量を別々に説明できます。履歴が短い回と長い回、画像を途中で初めて加える回も分けると、通常時の効果と再作成が必要になる条件を比較できます。
もう一つ測るのは復旧コストです。短い間隔で成功する会話に加えて、5分を超えてから再開するケース、同時送信が起きるケース、ワーカーを再起動したケースを試します。再作成にかかった時間と回数を含めて、成功した仕事一件あたりの待ち時間を比較します。正規の入力に対する品質やツールの実行回数が変わっていないことも確認します。スレッドが使える回だけを集計すると、利用者の長い待ち時間やネットワーク切断がある運用で効果を見誤ります。
ベータを採用しやすいのは、一つの仕事の間に大きな履歴を何度も送り、各ターンが短い間隔で進む用途です。逆に単発の分類や人の返信を長く待つチャットは、毎回履歴を組み立てる実装の方が運用を読みやすくできます。まず一つの仕事で通常のMessages APIに戻せる経路を残して試し、短縮できた時間が再作成や運用負担を上回るかで判断します。
参考資料
AnthropicのMessage threads公式ガイド