目次
本番のでは、 200が返り、応答時間も正常で、に例外がなくても、利用者の条件を落としたり、確認していない内容を確定扱いしたりすることがあります。Googleが公開したAQuA(Ambient Quality Agent)は、こうした「正常に見える失敗」を本番の会話ログから探し、同じ原因の失敗をまとめ、時のソースへ結び付ける参照実装です。
この記事は新製品の性能比較ではなく、2026年10月31日に確認したGoogle公式資料を基に、AQuAを導入する前の判断と運用手順を整理した実践解説です。対象は、AIエージェントをすでに本番へ出しており、固定した評価セットだけでは実利用の失敗を拾い切れない開発・運用チームです。AQuAの実行結果を本サイトで再現したものではありません。
スポンサーリンク
AQuAが解決するのは本番投入後の「外側の評価ループ」
開発中の評価では、用意した質問や合格条件を使い、モデル、、ツール定義の変更前後を比較します。この方法は回帰テストに欠かせませんが、公開後には想定外の言い回し、長い会話、途中の条件変更、複数エージェント間の引き継ぎが増えます。モデルやを更新しただけでも、既存のを通過したまま回答品質が変わることがあります。
AQuAはリクエスト処理の経路へ入る仕組みではありません。Google Cloudプロジェクト内で、Cloud Trace、Cloud Logging、BigQueryに保存された軌跡を定期実行、デプロイ後、または任意のタイミングで読みます。会話ログ、ソースのスナップショット、分析結果はプロジェクト内に置き、稼働中のエージェントへ自動で書き戻しません。利用者への応答を遅らせず、運用の裏側で評価する構成です。
5段階で会話を抽出し、失敗候補を検証する
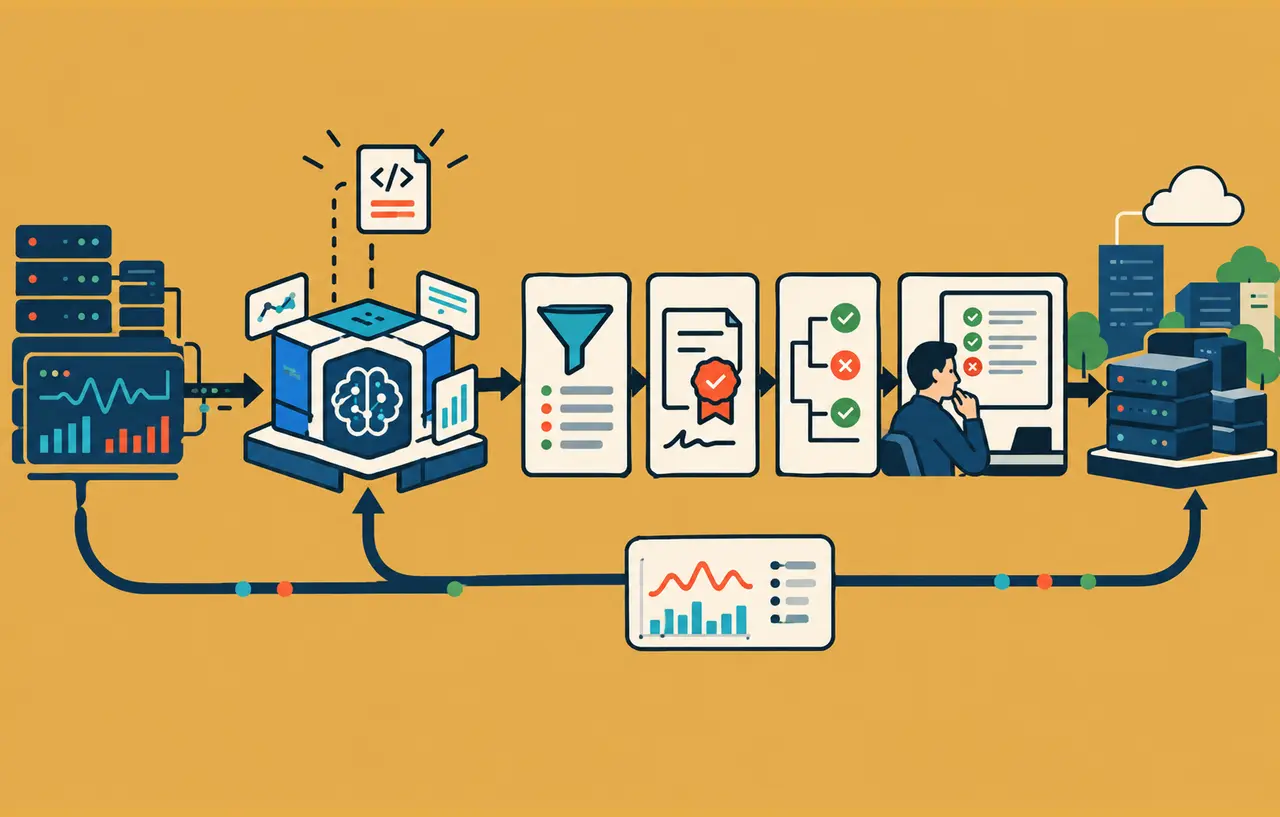
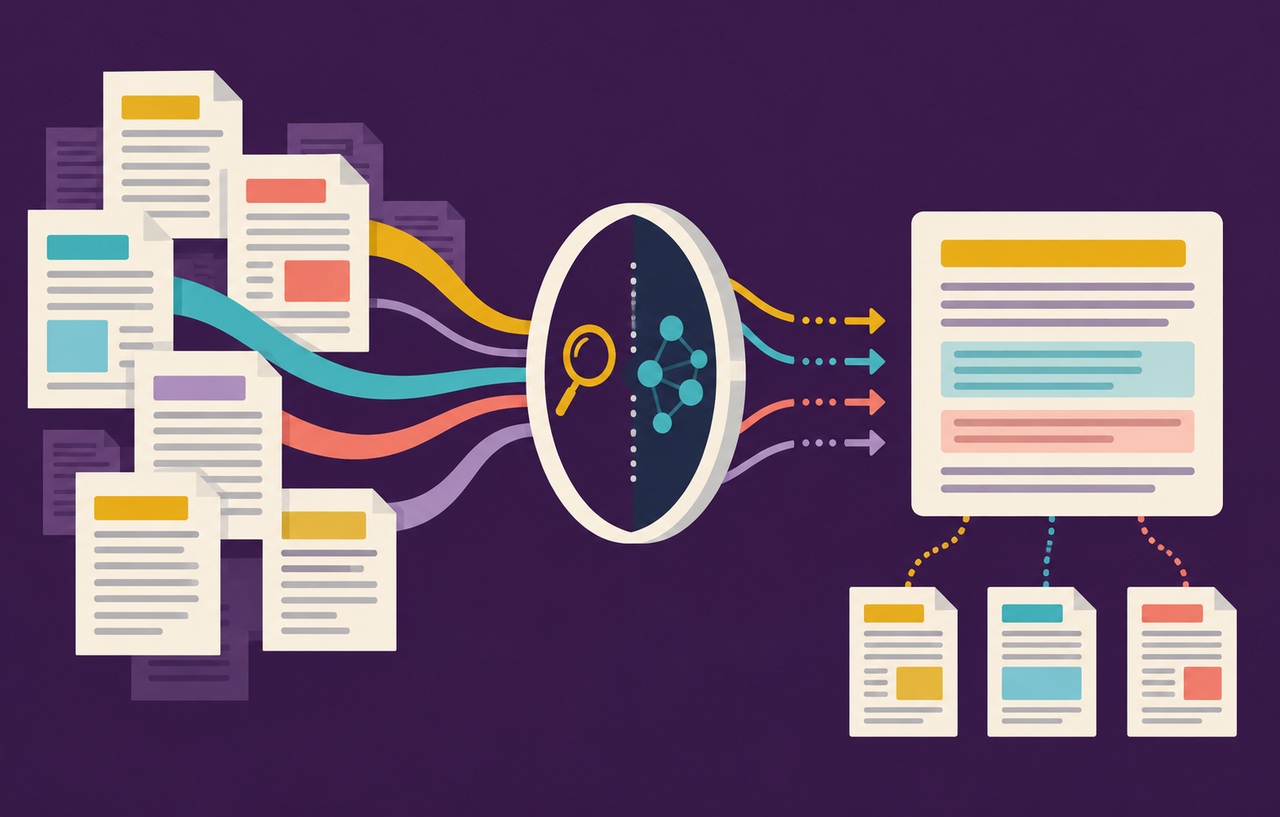
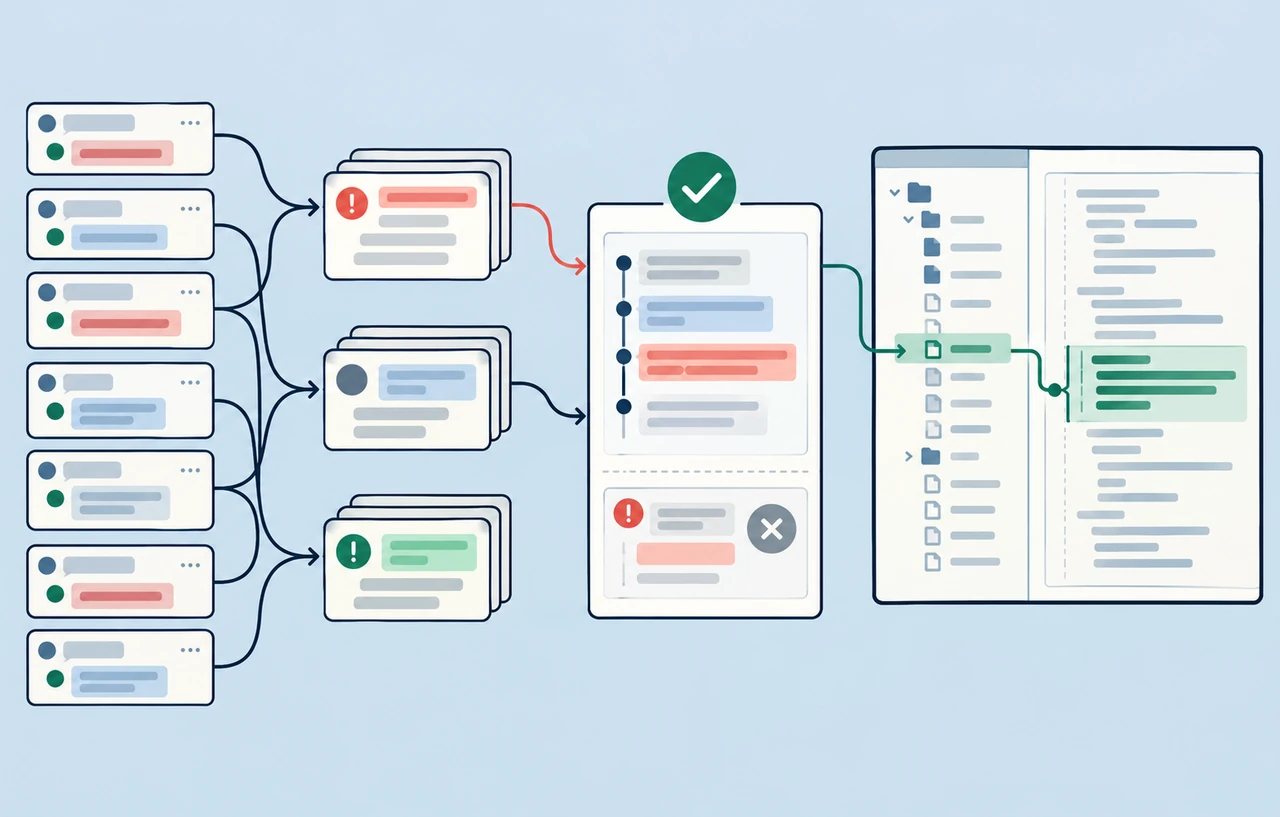
一回の実行は、単に全会話へ点数を付ける処理ではありません。公式資料では、次の5段階で本番の軌跡を「対応できる課題」へ変換します。
- Sample:最近のから最大1,000件を無作為に抽出します。上限を設けることで一回の費用を予測しやすくします。
- Review:手順、ツール選択と引数、根拠、タスク完了など9項目の観点で会話を確認し、失敗時は実際の動作と期待動作を構造化して残します。
- Cluster:同じ失敗メカニズムに見える指摘をまとめ、個別の苦情ではなく繰り返す問題として扱います。
- Verify:別のモデルが各候補を最大3件の会話全文と照合し、根拠が支えないクラスターを除外します。
- Track:確認済みの課題をNEW、RECURRINGとして追い、14日間再発しなければ自動でRESOLVEDへ移します。
ここで重要なのは、モデルが作った最初の分類をそのまま障害票にしないことです。AQuAは候補と検証済みの結果を分け、誤検知のクラスターを会話全文で落とします。Googleの掲載例では、32セッションから42件の指摘を9クラスターへまとめ、検証によって3クラスターを除外しました。この数字は旅行エージェントの例に限られ、ほかのシステムの精度を保証するものではありません。
スポンサーリンク
goal.mdで自社の失敗条件を伝える
汎用的な「良い回答」の基準だけでは、業務固有の失敗を拾えません。予約エージェントなら、座席番号を利用者が指定した場合でも空席確認が必要です。問い合わせ分類なら、存在しない部署へ振り分けないことや、判断材料が足りなければ保留することが重要です。
AQuAでは、平文のgoal.mdをレビュー用プロンプトへ加え、製品として守るべき条件と無視してよい差を伝えます。「最終確定はツール結果に基づく」「会話途中の変更を次の担当へ渡す」「挨拶や文体の差は対象外」といった境界を先に書くと、表現上の好みより業務上の失敗へ集中できます。必要ならeval_config.yamlに決定的な指標も加え、モデル判定とは別に推移を追えます。
Google CloudのAgent evaluation自体は、評価ケースの定義、推論、トレース生成、指標計算、分析、最適化という反復工程を提供します。AQuAはその考え方を本番ログの継続的な抽出と原因調査へ伸ばします。固定データで変更前後を比べる方法は、既存記事「AIの改善を勘で判断しないために|評価データと回帰テストの始め方」で解説しています。AQuAは固定テストを置き換えるものではなく、そこへ追加すべき実利用の失敗例を見つける役割です。
デプロイ時のソースへ原因を結び付ける
会話ログだけでは、モデル、オーケストレーション、ツール定義、指示文のどこで条件が失われたか判断できません。AQuAはagents-cli deployの際にソースツリーの変更不能なスナップショットをCloud Storageへ保存し、対象リビジョンと会話を対応させます。
担当者が課題を調べると、原因調査エージェントは失敗した軌跡と当時のソースを読み、内の問題なら<path>:<start>-<end>の形式で該当行を示します。存在しないファイルや行への参照はサーバー側で拒否されます。原因が外部依存、別エージェントからの引き継ぎ、取得データにある場合は、そのステップを示し、根拠のないコード修正案は作りません。
ただし、AQuAは修正を自動適用せず、Pull Requestも自動作成しません。得られた課題をagents-cli aqua get-insightで取得し、開発で修正し、失敗した会話をローカル再生または評価データへ追加してから、本番へ戻します。Google Agents の拡張と評価工程については「Google Agents CLIでLangChainを扱う|ADK以外でも評価・配備を共通化」も参考になります。
スポンサーリンク
導入前に決めるデータ、費用、担当範囲
| 確認項目 | 導入時の判断 |
|---|---|
| 取得する会話 | 個人情報や業務機密を除外・マスキングし、保存期間と閲覧権限を決める |
| 評価範囲 | 重大な業務フローと無視する表現差をgoal.mdへ明記する |
| サンプル数 | 最大1,000件を前提に、発生率が低い重要フローを別集計する |
| 費用 | Review、Cluster、Verify、必要時だけの原因調査を分けて予算化する |
| 担当者 | NEWの一次確認、誤検知の却下、修正、再評価の責任者を決める |
| 合格条件 | 平均点だけでなく、重要な失敗の再発件数と未評価件数を確認する |
Googleの試算例では、短い単一エージェントの96セッションでレビュー、クラスタリング、検証の合計が0.70ドル、複数エージェントで一セッション約50スパンを含む32セッションでは3.76ドルでした。原因調査は課題ごとに0.33〜2.47ドルとされています。モデル、トークン量、料金は変わるため、自社の予算値として流用せず、代表的なトレースで一回分を測ってください。
また、無作為抽出だけでは、発生率が1%でも重大な失敗を毎回拾えるとは限りません。長時間動くコーディングエージェントや調査エージェントでは、数百ターンと大量のツール出力が評価コンテキストへ収まらない問題もあります。AQuAはこれらを今後の課題として挙げています。導入後は「見つからなかった」を「問題がない」と読み替えず、抽出件数、処理失敗、検証上限を実行記録と一緒に確認します。
現行版の前提を確認し、合成データから試す
2026年10月31日に公式リポジトリを確認した時点で、AQuAはv0.2.0として公開されています。前提はPython 3.11〜3.13、uv、npm、agents-cli 1.10以降、Terraformです。agents-cliへ組み込む場合は、動作確認したリビジョンを固定し、拡張本体とagents-cli-extensions.yamlをで再現できる状態にします。
agents-cli extension add google/adk-recipes#core/python/ambient-quality-agent \
  --ref ambient-quality-agent/v0.2.0
agents-cli installへ接続する前に、公式リポジトリの合成データデモで画面とデータ構造を確認できます。make demoはGoogle Cloudプロジェクト、認証情報、モデル呼び出しを使わず、用意された一か月分の実行と課題をローカル表示します。
git clone https://github.com/google/adk-recipes.git
cd adk-recipes/core/python/ambient-quality-agent
make demo
本番接続では、ダッシュボードをCloud RunとIAPで保護します。Google Cloud組織に属するプロジェクト、閲覧者、テレメトリーデータセットへの読み取り権限を先に確認してください。組織を使わない構成では、公式手順が示すIAP無効化とagents-cli aqua ui-proxyの運用条件を別途評価します。
この段階では、NEW、RECURRING、RESOLVEDの遷移、課題から会話へ戻れるか、担当者が原因と根拠を区別できるかを確認します。次に、匿名化した少数の本番トレースを使い、既知の失敗を検出できるか、正常な挙動を誤検知しないかを較正します。最初から全会話へ広げず、失敗条件が明確な一つの業務フローで、評価費用と人の確認時間を測る方が導入判断に結び付きます。
改善を公開する前に同じ失敗条件で再評価する
AQuAが提示した行番号付きの修正案は、原因調査の出発点です。提案された一行を直して同じ会話だけ通すと、その例に合わせ込んだだけでも成功に見えます。課題に添付された会話から利用者の発言を抽出し、同じ条件の別表現、正常系、隣接する業務フローを加えた評価セットを作ります。そのうえで、修正前のリビジョンと修正後のリビジョンを同じ指標で比較します。
Googleの旅行エージェント例では、座席確認を飛ばす失敗が15セッションから2セッションへ減り、食事条件の引き継ぎ漏れは7件から0件になりました。一方、別のツール未設定による5セッションの失敗は残りました。全体の合格数だけを見ると改善したように見えても、直していない失敗まで解決したとは限りません。課題ごとの再発件数、全体の合格率、変更していない重要フローの三つを分けて記録します。
公開後は新しいリビジョンで再びAQuAを動かし、同じクラスターがRECURRINGになるか、一定期間現れずRESOLVEDになるかを追います。修正時に作った再現ケースはCIの固定評価へ残し、本番ログから得た学びを次回の変更判定へ使える資産にします。
AQuAが向くチームと急がなくてよいケース
AQuAが向くのは、本番の会話軌跡を取得でき、変更リビジョンを追跡でき、失敗を修正・再評価する担当者がいるチームです。複数のツールやサブエージェントを使い、インフラ監視だけでは見えない業務上の失敗がある場合は、固定テストへ実利用の例を戻す経路を作れます。
一方、まだ成功条件を文章にできない、会話ログを適切に扱えない、失敗が見つかっても修正担当がいない段階では、先に固定した評価セットと変更前後の比較を整える方が優先です。AQuAの価値は、課題を自動で直すことではなく、読めない量の本番会話から、根拠付きで人が判断できる候補を作る点にあります。評価結果を障害対応、改善計画、回帰テストへ戻す運用まで設計してから採用してください。
スポンサーリンク