目次
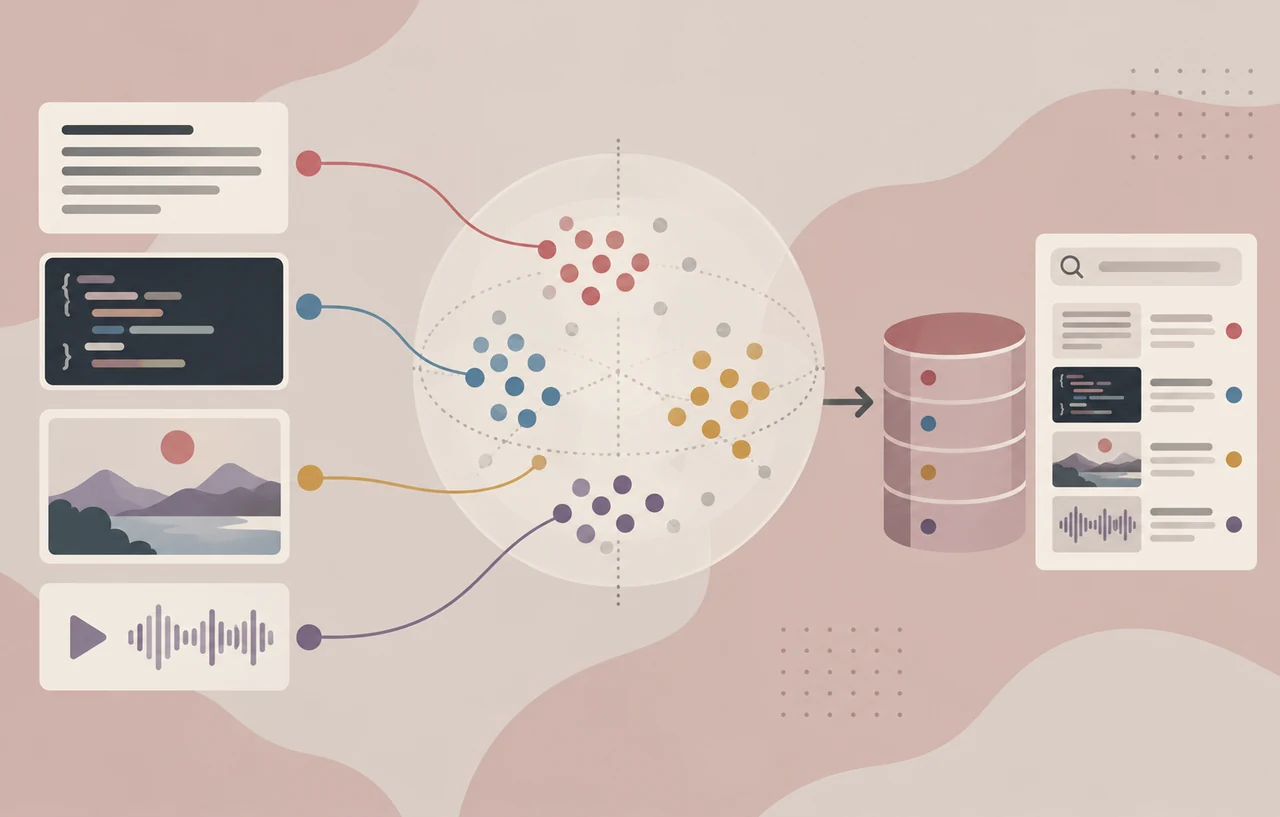
テキストの検索索引へ、製品画像、説明動画、音声まで追加したい。しかし、媒体ごとに別の埋め込みモデルと索引を持つと、検索処理と評価が分かれ、端末上で使うメモリーも増えます。Googleが2026年10月6日に公開したEmbeddingGemma 2は、テキストとコード、画像、動画、音声を同じ768次元の空間へ写し、異なる媒体を一つの類似度計算で比較できるオープンモデルです。
この記事はニュースの短報ではなく、Googleの開発者ガイド、モデルカード、マルチモーダル実装例を2026年11月2日に確認した導入判断の解説です。対象は、ローカル検索、、コード検索、メディア検索を実装する開発者です。本サイトではモデルを実行しておらず、性能値はGoogleが公開した評価結果として扱います。
スポンサーリンク
一つのモデルでも読み込む構成は四つある
EmbeddingGemma 2はGemma 4を基礎にした埋め込みモデルで、テキスト部分が270M、画像用エンコーダーが170M、音声用エンコーダーが300M、全体では740Mパラメーターです。動画は画像用エンコーダーでフレームを処理します。入力の種類は違っても、最終的なベクトルは同じ空間に置かれます。
| 扱う媒体 | 有効な構成 | 規模 | 向く用途 |
|---|---|---|---|
| テキスト・コード | 画像と音声を無効化 | 270M | 文書検索、コード検索 |
| テキスト・画像・動画 | 音声を無効化 | 440M | 商品画像、図表、動画検索 |
| テキスト・音声 | 画像を無効化 | 570M | 会議音声、音声アーカイブ |
| すべて | 全エンコーダー | 740M | 複数媒体を横断する検索 |
最初から740M版を読み込む必要はありません。SentenceTransformerのconfig_kwargsでvision_configとaudio_configを無効化すると、使わない重みを読み込まずに済みます。まず実データにある媒体だけで構成し、画像や音声を追加するときにエンコーダーを有効にする方が、起動時間とメモリーの効果を測りやすくなります。
from sentence_transformers import SentenceTransformer

model = SentenceTransformer(
    "google/embeddinggemma-2",
    config_kwargs={"vision_config": None, "audio_config": None},
    truncate_dim=256,
    normalize_embeddings=True,
)
同じチェックポイントから読み込む四構成は共有ベクトル空間を使うため、270Mのテキスト構成で作った質問ベクトルと、画像エンコーダーを含む構成で作った文書・画像ベクトルを比較できます。Googleは、テキストだけで始めた索引へ後から画像や音声を足す場合、既存の埋め込みを再計算しなくてよいと説明しています。ただし、次元数や前処理、モデルのリビジョンまで自由に混ぜてよいという意味ではありません。
検索では質問と資料に別の指示を付ける
テキスト入力では、用途を示す短いタスク指示が検索品質に影響します。Web・文書検索なら質問側にSearchQueryを指定し、資料側はタイトルと本文をtitle: ... | text: ...の形で渡します。コード検索にはCodeRetrieval、質問応答にはQuestionAnsweringが用意されています。
検索は質問と資料の役割が異なる非対称タスクです。両方を同じ平文で埋め込むと、モデルが学習時に想定した区別を使えません。一方、分類やクラスタリング、文章同士の類似度では、比較する入力へ同じ種類の指示を適用します。媒体だけでなく、検索・分類・類似度のどれを行うかを索引の設定として残してください。
画像、動画、音声にはテキスト用プレフィックスを付けません。テキストと画像を一つの商品情報として埋め込む場合は、<|image|>、<|video|>、<|audio|>で媒体を置く位置を示せます。画像だけの索引と商品説明だけの索引を後から結合するのではなく、一件の商品を複合入力として表す選択肢です。
スポンサーリンク
256次元を出発点にしても一律には決めない
標準の出力は768次元ですが、Matryoshka Representation Learningにより512、256、128次元へ切り詰められます。次元を減らすと、ベクトルDBの保存量、転送量、類似度計算を減らせます。Googleの例では、bfloat16で100万件の768次元ベクトルが約1.5GB、128次元では約250MBです。
ただし圧縮率だけで決めてはいけません。Googleのモデルカードでは、768次元から256次元にした場合、MMEB v2全体の値は59.01から56.24へ下がり、128次元では45.65です。テキスト・コードでは128次元も候補になりますが、画像・動画・音声を含む検索では低下が大きくなります。Googleは768または512次元をマルチモーダル・視覚文書検索、256次元を保存制約がある構成、128次元を大規模なテキスト索引や再順位付け前の候補抽出として案内しています。
切り詰めたベクトルは、コサイン類似度に使う前に再度L2正規化が必要です。正規化を忘れても例外にならず、もっともらしいスコアのまま順位が悪化するため、見落としやすい点です。encode()へtruncate_dimとnormalize_embeddings=Trueを指定し、質問と索引の次元を必ず一致させます。
float16は使わずNaNと無言の劣化を検査する
EmbeddingGemma 2の活性値はfloat16の表現範囲を超えるため、Googleはbfloat16またはfloat32を指定しています。float16ではNaNだけでなく、例外を出さずに劣化した埋め込みが返る可能性があります。対応GPUではbfloat16、一般的なCPUではfloat32を基準にし、生成後に有限値、ノルム、代表的な検索順位を確認します。
画像は一件あたり70〜1120のソフトトークンを選べ、値を増やすと細部の表現と引き換えに待ち時間と入力長が増えます。動画は既定で1秒に1フレームを取り、最大フレーム数や均等抽出を変更できます。音声は16kHzへ処理されます。8,192トークンの入力枠は媒体間で共有されるため、長い説明、複数画像、動画、音声を同時に入れれば、それぞれに使える量は減ります。
スポンサーリンク
共有空間でも媒体ごとの品質差は残る
同じ768次元へ出力されることは、すべての媒体で同じ精度になることを意味しません。Googleのモデルカードは、テキスト、コード、画像、視覚文書、動画、音声をそれぞれ異なるベンチマークと指標で報告しています。例えばコード検索のMTEBはNDCG@10、画像を含むMMEBはHit@1やNDCG@5、音声検索はMRR@10です。数値を横並びにして「音声より画像が強い」と判断することはできません。
横断検索の評価では、検索元と検索先の組み合わせを明記します。「写真を文章で探す」「音声を文章で探す」「似た動画を動画で探す」は別のテストです。各組み合わせで上位1件、上位5件、再順位付け後の結果を記録し、媒体別の失敗を全体平均へ埋めないようにします。特定の媒体だけ品質が足りなければ、共有索引を維持したまま候補件数や再順位付けを変える判断もできます。
また、このモデルは利用者向け文章を生成するモデルではなく、入力をベクトル表現へ変換します。検索結果の、表示してよい媒体の判定、不適切な近傍結果の除外はアプリ側の責任です。埋め込みがローカルで動くことと、元データを端末へ保存してよいことも別に確認してください。
既存索引へ追加できる条件と再索引が必要な条件
EmbeddingGemma 2内で同じ次元、同じ前処理、同じリビジョンを保ち、利用するエンコーダーだけ追加するなら、既存テキスト埋め込みを残したまま画像や音声を加えられます。これは段階導入の利点です。文書検索から始め、次にスクリーンショットや操作動画を同じ検索へ加える構成を検討できます。
一方、別モデルで作った索引、異なる次元、異なるタスク指示、正規化方法が不明なベクトルをそのまま混ぜるべきではありません。旧EmbeddingGemmaや他社モデルから移る場合は、新索引を別に作り、同じ質問セットで比較します。切り替え中は索引にモデルID、リビジョン、次元、dtype、プレフィックス、媒体処理設定を記録し、質問側が誤った索引へ送られないようにします。
導入評価は媒体別と横断検索に分ける
Googleのベンチマークはモデル選定の参考になりますが、自社の商品画像、録音品質、コード規約、言語構成で同じ順位になる保証はありません。評価セットには、テキストからテキスト、テキストから画像、テキストから動画、テキストから音声を分けて入れます。さらに、似た画像で説明だけが違う例、同じ単語を含むが音が違う例、動画の一瞬だけに対象が出る例を含めます。
比較するのは正解が上位に入る割合だけではありません。モデルの読み込み時間、ピークメモリー、一件の埋め込み時間、索引サイズ、問い合わせの待ち時間も記録します。まず768次元・必要なエンコーダーだけの構成を基準にし、512、256、128次元を一つずつ比較します。画像のトークン量や動画のフレーム抽出まで同時に変えると、どの設定が品質へ効いたか分からなくなります。
EmbeddingGemma 2の価値は、すべての媒体を無条件に一つへ詰め込むことではありません。検索したい媒体を選び、同じ空間へそろえながら、使わないエンコーダーと過剰な次元を外せる点にあります。既存のテキストRAGを置き換える前に、横断検索が本当に必要か、256次元で必要な再現率を保てるか、端末上のメモリーと待ち時間に収まるかを、固定した実データで確認してください。
関連記事
スポンサーリンク