目次
社内資料を使うRAGで、元のPDFを削除したのに、AIが古い内容を回答することがあります。原因を「モデルが覚えている」と決め付ける前に、検索インデックス、分割したチャンク、回答キャッシュ、会話履歴にデータが残っていないか確認してください。元ファイルの削除と、AI機能全体からの削除は同じ操作ではありません。
本稿は、RAGの文書削除が反映されない原因と、ベクトルDBの削除漏れを調べる開発者向けの恒久対策です。2026年10月24日にAzure AI Searchの公式資料を確認し、汎用的な削除管理の設計を提案します。新しい漏えい事件のニュースではありません。構成例と検証手順は仮想例であり、特定サービスの消去完了を実測したものではありません。
スポンサーリンク
削除対象を元文書だけで数えない
RAGでは、原本からテキストを抽出し、検索しやすい単位へ分割し、埋め込みやメタデータと一緒に保存します。さらに取得結果を使って生成した回答が、会話履歴やキャッシュに残る場合があります。検索できなくすることと、保存されている複製を消すことは区別が必要です。
まず、原本、抽出テキスト、チャンク、埋め込み、検索用メタデータ、生成回答、ログ、バックアップを一覧にします。すべてのシステムがすべてを持つわけではありません。採用していない保存先を増やすのではなく、実際の取り込み・生成・監視経路から洗い出してください。
文書IDと派生物のIDを対応付ける台帳があると、削除の範囲を追いやすくなります。ファイル名だけでは、同じ名前の別文書や改訂版を区別できません。テナント、文書ID、版、取り込み実行IDを組にして、どのデータから何が作られたかを説明できるようにします。
Azure AI Searchでも変更検知と削除検知は別
Microsoftの変更・削除検知の資料は、Azure Storage由来の変更検知が行われても、元データの削除がそのまま検索インデックスからの削除につながるわけではないと説明しています。削除ポリシーを初回の取り込みから設定する必要があり、後から追加しても過去の削除漏れを自動的に解消するとは限りません。
これはAzureのインデクサー方式に関する仕様です。すべてのベクトルDBが同じ動作をするという意味ではありません。ただし、「取り込みが同期されたなら削除も同期されるはず」という思い込みを検証する材料になります。自分の製品で削除の起点と完了条件を調べてください。
Azure Blobのネイティブなsoft deleteを使う場合も、保持期間中にインデクサーが状態を検知できることなどの条件があります。障害や処理の遅れでその期間を過ぎると、想定した削除が実行されない可能性を考える必要があります。保持期間を短くする判断と、検索削除が追い付く条件を分けて点検します。
スポンサーリンク
分割文書では子チャンクの削除を確認する
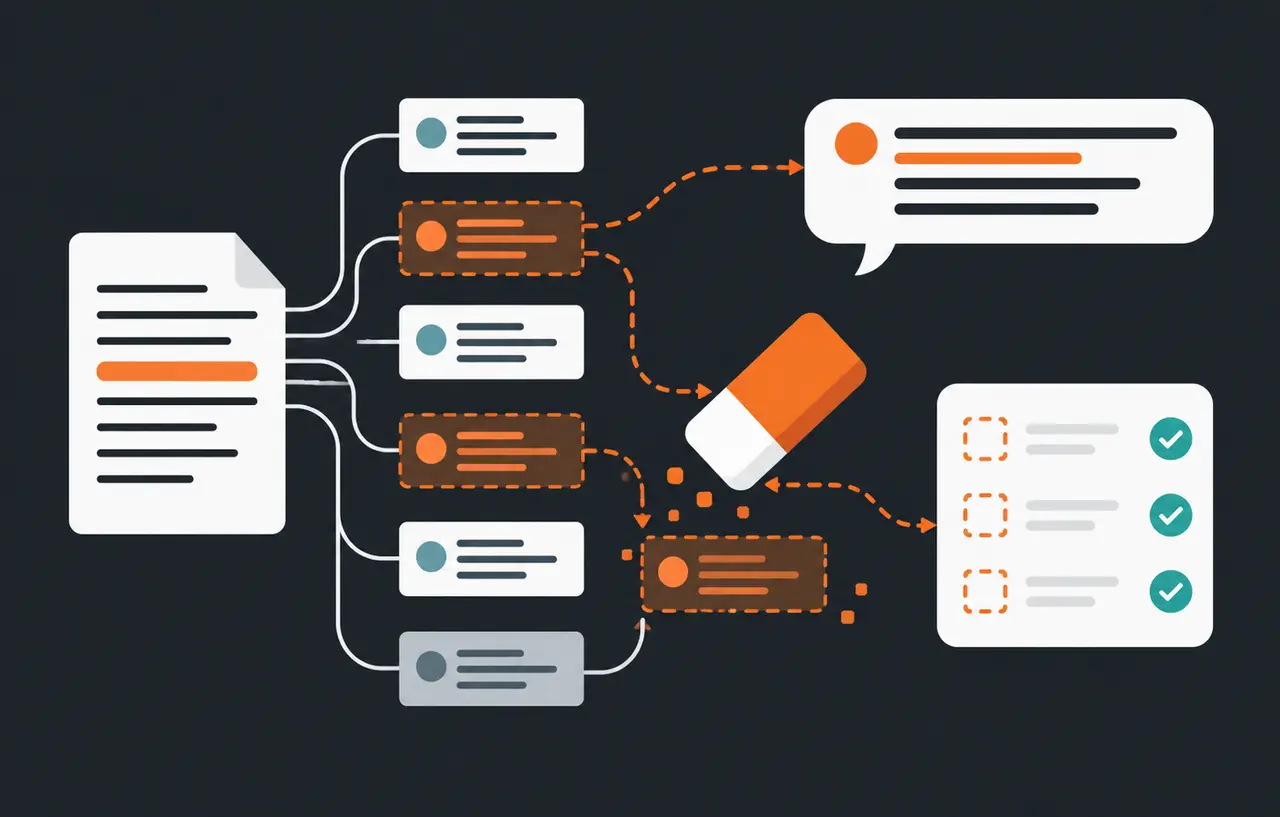
原本一件が多数のチャンクになる構成では、親文書が消えたことだけを確認しても不十分です。Azure AI Searchのindex projections資料は、親の完全な削除を子へ反映するにはデータソースの削除検知ポリシーが必要で、未設定なら不要な子文書を手動で削除する必要があると説明しています。
また、原文を短くして不要なチャンクが減る更新と、親文書を丸ごと削除する処理は、同じ条件ではありません。文書の更新で正しく動いたから完全削除も動くとは判断できません。実際の取り込み方式と、親子関係を管理する機能を確認します。
独自実装では、取り込み時に作ったチャンク一覧を保存し、文書単位で列挙して削除できるようにします。件数を固定して「末尾の番号まで削除する」方式は、分割規則や版の変更で漏れるおそれがあります。失敗したチャンクのIDを記録し、対象だけを再実行できる処理にします。
検索の除外を先に行い物理削除を追跡する
緊急に内容を使わせない必要がある場合、すべての保存物を消し終わるまで検索を許可し続けるのは適切ではありません。本サイトの提案は、アプリが管理する削除状態を最初に確定し、その文書を新しい回答へ利用しないようにしたうえで、派生データの削除を追跡する方式です。
状態は、受付、検索利用の停止、派生物削除、結果確認、保存先ごとの残存確認などに分けます。利用者に見せる状態も、「検索で利用しません」と「全保存先の消去が完了しました」を同じ文言にしないようにします。実際のサービスの保持仕様を超えた保証は避けてください。
検索結果を受け取った後にも文書の状態を再確認すると、削除直前に取得された結果が回答へ混ざるリスクを減らせます。ただし、すでに利用者へ配信した回答や、処理中のモデル入力を後から完全に取り消せるとは限りません。どこまで中断できるかを実行基盤の仕様として決めます。
スポンサーリンク
削除処理は親のIDと派生物をセットで管理する
次は処理順序を表す擬似コードで、Azure SDKやMCPの実在APIを示すものではありません。テナントと文書IDの認可を先に行い、処理中に失敗しても検索停止の状態が失われないようにする考え方を示しています。個別の保存先には対応する削除APIと検証を実装します。
削除要求を受け付ける
  → 利用者が対象文書を削除できるか確認
  → 文書を「利用停止」に変更し世代を更新
  → 同じ文書の取り込みジョブを停止または無効化
  → 対象版のチャンクと埋め込みを削除
  → 回答キャッシュと派生データを処理
  → 保存先ごとの削除結果を確認
→ 残存理由と保持期限を記録Microsoftのインデックスへのデータ投入資料は、文書をキーで識別し、upload、deleteなどの操作を指定する方式を説明しています。削除要求を送ったことだけで完了とせず、処理結果を確認し、必要なら再読取で対象の残存を検査します。
文書IDとチャンクIDの対応が失われている場合は、まず対象を特定する必要があります。事故対応の焦りから他組織のインデックスまで全削除することは避けます。どうしても安全な再構築が必要なら、影響範囲、停止時間、再取り込み対象、ロールバック時に復活させない方法をレビューします。
再取り込みとの競合で古いデータを戻さない
削除の直前に取り込みジョブが原本を読み始めていると、削除後に古いチャンクを書き戻す場合があります。単に検索インデックスを消すだけでは、この競合を防げません。取り込み開始時と書き込み直前で、文書の世代と利用状態を確認する方式が考えられます。
たとえば文書の状態に削除済みの印を残し、その世代より古いジョブの結果を採用しない設計にします。この印は一般にtombstoneとも呼ばれますが、具体的な形式はアプリが決めるもので、すべての製品に同じAPIがあるわけではありません。印をいつ消してよいかも、再送やバックアップの保持期間に合わせて決めます。
再試行は同じ削除要求として追跡します。失敗のたびに新しい削除ジョブを無制限に作ると、完了状態と残存件数が分かりにくくなります。処理単位のIDを持ち、保存先ごとの結果と失敗理由を更新する形が実務的です。削除処理に再現性があることと、二重実行で影響が増えないことを確認します。
回答履歴とキャッシュを別に扱う
検索対象を消しても、過去の回答が会話画面へ表示される場合があります。その回答に削除対象の機微情報が含まれるなら、検索インデックスだけでなく、履歴側の扱いを決める必要があります。一方、監査や契約で保持すべき記録がある場合もあり、利用者向けの説明と実装をそろえます。
キャッシュには、質問だけでなく、どの文書のどの版を根拠にしたかという依存情報を残す方法が考えられます。文書単位で無効化できなければ、対象テナントのキャッシュ世代を進めるなど、運用可能な粒度を選びます。完全な依存追跡には保存量と実装負担がかかるので、用途の機密度と比較します。
ベクトルを消しただけで、保存したチャンク本文やログが消えたとも限りません。逆に、モデルの学習への利用を停止したことが、アプリ内の履歴削除を意味するわけでもありません。自社の保存先と外部提供元の保持条件をそれぞれ確認し、異なるサービスの削除機能を一つの処理として説明しないようにします。
バックアップを戻した後にも削除を維持する
本番から消えた内容が、障害復旧で戻ることがあります。バックアップを保持する理由と、日常の検索利用から除外する仕組みは両立させて設計します。バックアップを通常の回答処理から直接検索できる場所へ置かないことも重要です。
復元時は、復元したデータの時点と削除台帳の時点を比較し、その後の削除要求を再適用してから公開します。削除台帳まで古いバックアップで上書きすると、何を除外すべきか分からなくなります。台帳の保護と復旧手順を、データ本体のバックアップ設計へ組み込みます。
スポンサーリンク
完了判定は質問への回答だけに依存しない
削除を検証するには、架空の文書へ固有の目印を入れ、取り込み、回答、キャッシュ利用まで確認してから削除します。その後、文書IDによる検索、キーワード検索、意味検索、過去の質問の再実行、別の聞き方を試します。目印を返さなかったという結果だけで、物理消去まで証明することはできません。
併せて、対象チャンクの残存、ジョブの再書き込み、履歴の表示、キャッシュの無効化、復元後の再適用を確認します。停止中のインデクサーや部分失敗も試してください。正常系だけでなく、削除を途中で中断しても運用担当が未完了部分を説明できることが、採用の重要な条件になります。
関連記事
RAGの利用者権限を検索へ引き継ぐ設計は、誰が読めるかを扱います。本稿は、読めた文書を削除した後、派生物と再取り込みまで管理して使わせなくする作業に焦点を当てています。
スポンサーリンク
参考資料
情報確認日:2026年10月24日。汎用の処理順と試験案は本サイトの提案です。本文と概念イラストの作成に生成AIを使用し、一次資料との照合と保存内容のレビューを行っています。