社内文書を読むAIは権限を引き継いでいる?RAGの情報漏えいを防ぐ設計
※本ページのリンクにはプロモーションが含まれています。
こんにちは、Ryohei(@ityryohei)です!
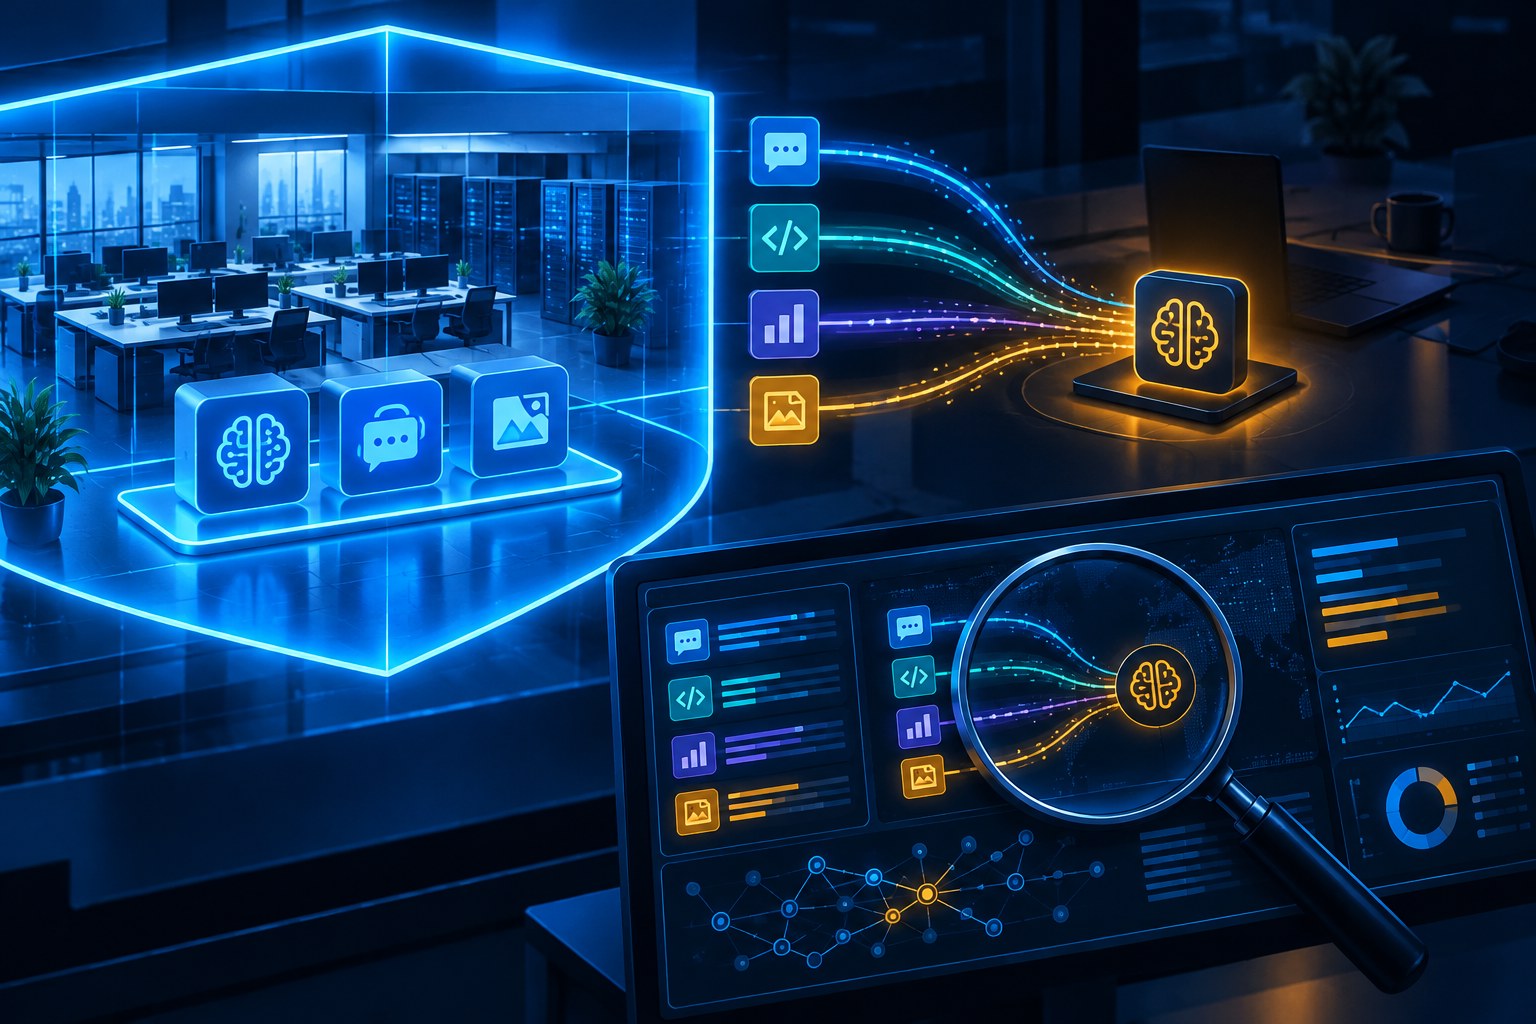
社内マニュアルや問い合わせ履歴をAIにつなぎ、質問に合う資料を探して回答させる。便利な仕組みですが、元の文書で「この部署だけ」「この顧客だけ」と決めていた閲覧権限は、AIの検索先でも維持されているでしょうか。
ログインできる社員であっても、すべての顧客情報や契約資料を読んでよいとは限りません。AIが文書を要約するようになると、元のファイルを直接開けなくても、回答を通じて内容を知れる場合があります。今回は、RAGの検索から回答まで、利用者の権限を保つ設計に焦点を当てます。
情報確認日:2026年10月14日。本記事は公式技術資料をもとにした深掘り解説であり、新たな侵害事件の速報ではありません。OWASPのLLM分類は2025版です。確認日を資料の公開日や事件発生日と混同しません。具体的な構成例は説明用の仮想例、導入・点検手順は本サイトからの提案です。
RAGは資料を探して渡す仕組み。権限が自動で移るとは限らない
RAG(Retrieval-Augmented Generation、検索拡張生成)は、質問に関連する外部資料を検索し、その内容を言語モデルに渡して回答を生成する構成です。文書を小さな断片に分けることがあり、この断片をチャンクと呼びます。文章を数値で表した埋め込み(embedding)を使って、意味の近い資料を探す構成もあります。
OWASP:LLM08:2025 Vector and Embedding Weaknessesは、アクセス制御の不備、利用者間の情報混入、埋め込みからの情報漏えいなどをリスクとして挙げています。検索精度が高いことは、利用者がその情報を読む権限を持つことの証明にはなりません。関連性と閲覧許可は別に判定する必要があります。
例えば、制作会社が顧客Aと顧客Bの運用資料を同じ検索基盤へ登録したとします。Aの担当者が質問したとき、文章の意味が近いからといってBの契約条件を取り出してよいわけではありません。「顧客Bについて答えない」とAIへ指示する前に、検索処理がAに許可された資料だけを扱えるかを確かめます。
AIへ渡す前に、読める資料の範囲を確定する
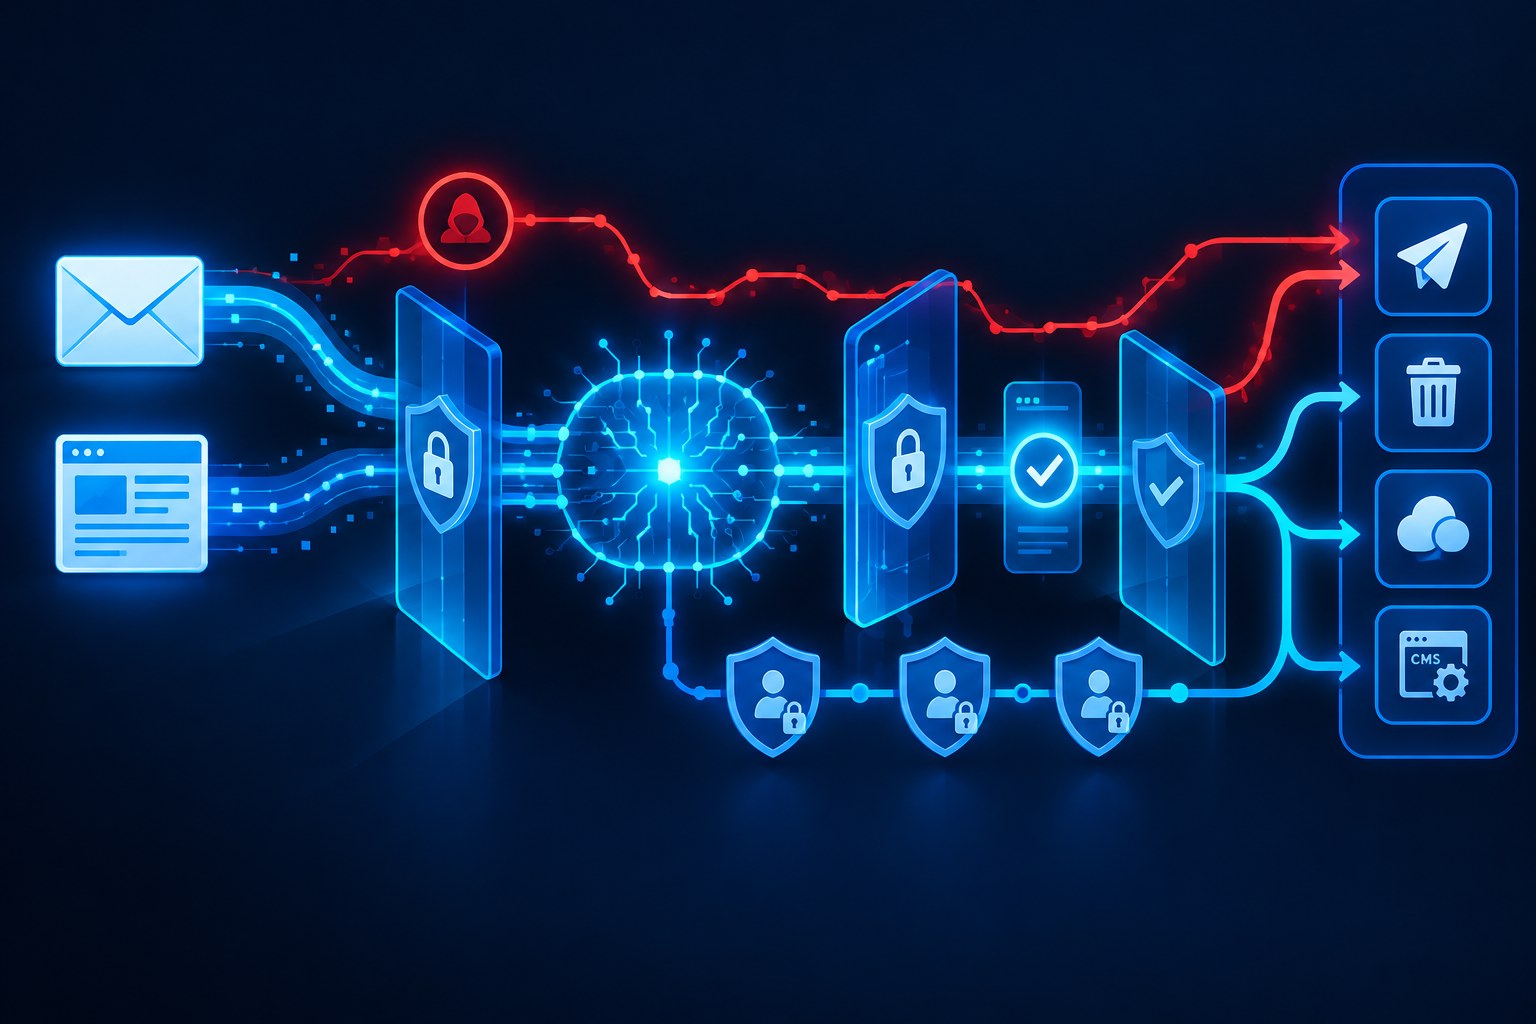
OWASP:RAG Security Cheat Sheetでは、元文書のアクセス制御を各チャンクへ引き継ぎ、登録時だけでなく検索時にも確認することを求めています。アクセス制御を言語モデル任せにせず、内容がモデルへ届く前に強制する点が重要です。
本サイトからは、利用者の認証情報をサーバー側で確認し、その人の顧客、部署、プロジェクトなどの所属を取得してから検索範囲を組み立てる構成を提案します。ブラウザーから届いた顧客IDや、モデルが選んだ検索フィルターを、そのまま権限の根拠にしないでください。
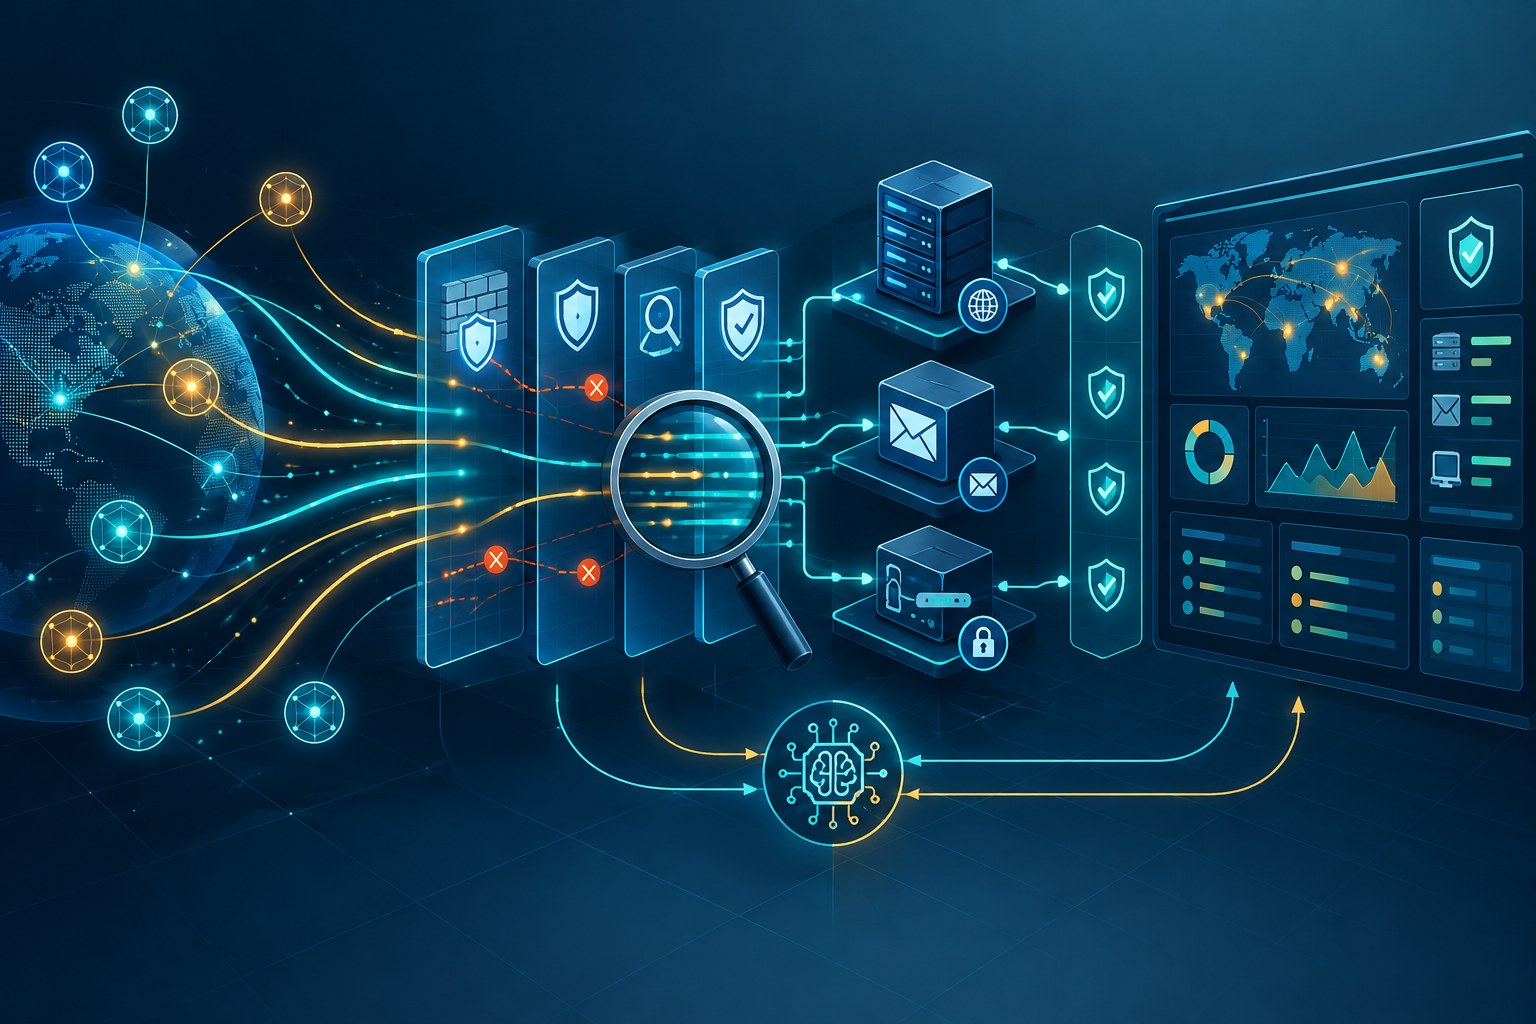
検索後に画面から禁止文書を隠すだけでは、モデルがすでに内容を読んでいるかもしれません。検索候補の生成、本文取得、再順位付け、モデルへの入力という各段階で、禁止された内容がどこまで進むのかを確認します。後段の処理まで含めて、権限外の本文が渡らないことを受け入れ条件にしましょう。
文書を分割するとき、権限情報も一緒に扱う
登録用の連携アカウントが広い閲覧権限を持つ構成では、「登録できた文書だから全員に見せてよい」と判断しないことが必要です。資料を取得できる取り込み処理の権限と、質問する人の権限は役割が違います。大きな文書を分割するときに、元ファイルの閲覧条件が落ちていないかを点検します。
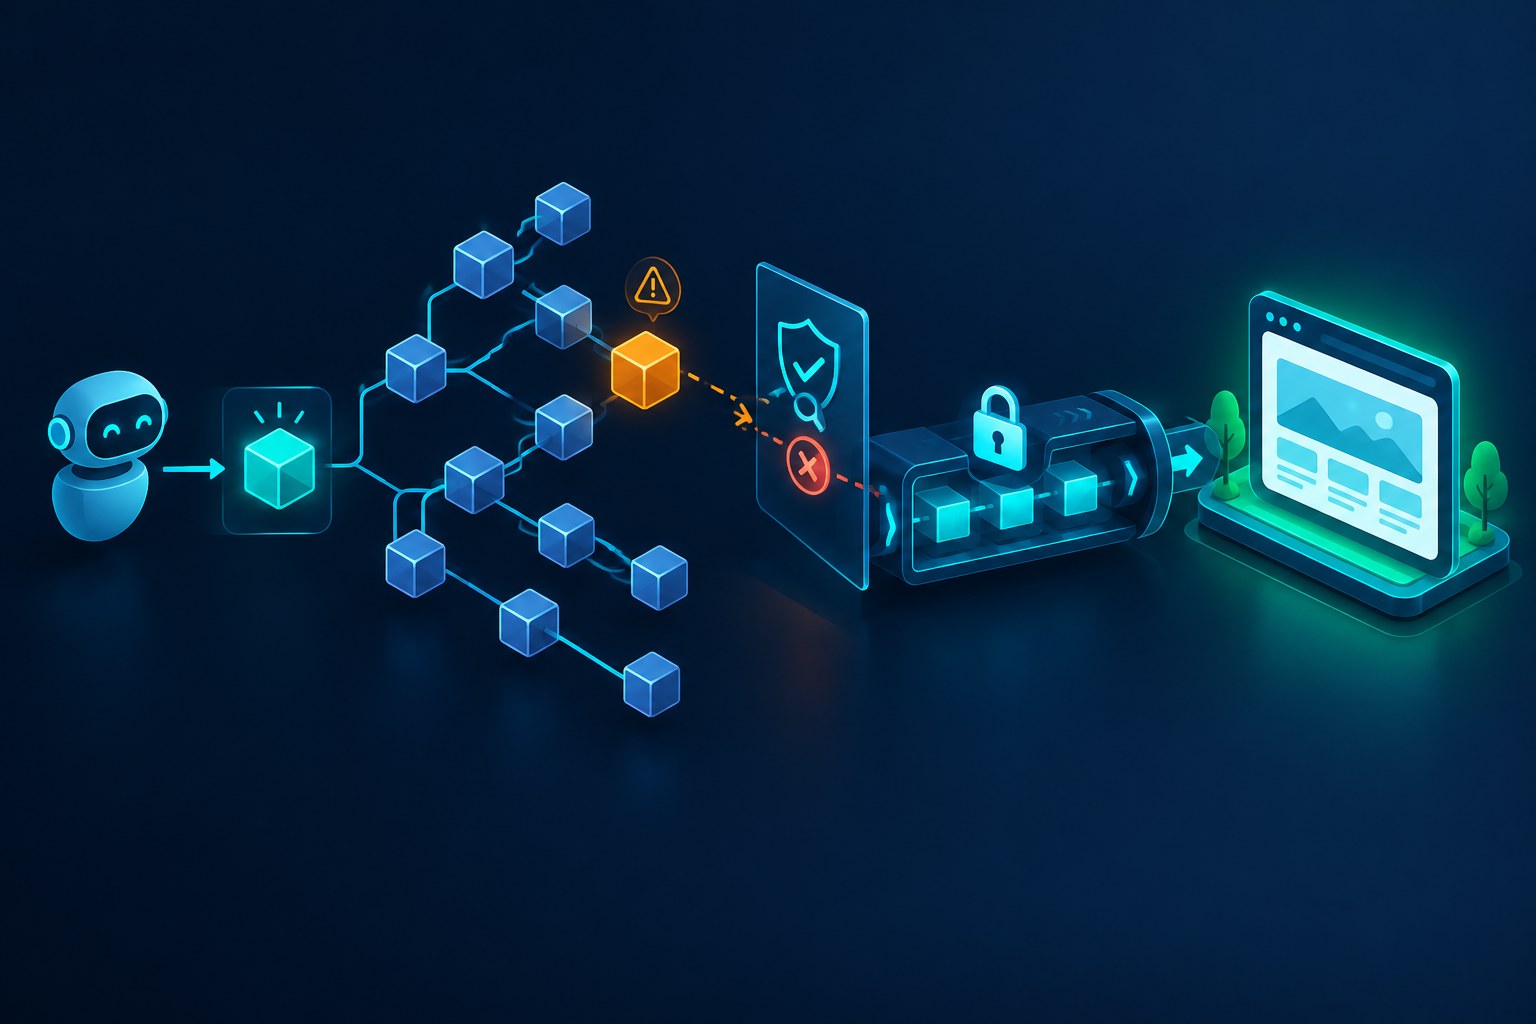
実装担当者とは、文書ID、チャンクID、データの所属、権限判定に使う情報、元文書の版、更新状態を関連づけることを提案します。権限情報のない断片を「公開」とみなすのではなく、確認できるまで検索対象から外す設計です。文書の一部を差し替えたとき、古い断片が残るかどうかも確認します。
検索基盤へ分類ラベルを保存するだけで終わらせないでください。ラベルを誰が付け、どの認証済み情報と照合し、権限変更後にいつ更新するかまで決める必要があります。単に「機密」という文字列があることと、検索APIが閲覧を拒否することは同じではありません。
Azure AI Searchの例:文字列フィルターと本人確認を区別する
Microsoft Learn:Azure AI Searchの文書単位アクセス制御は、文書単位の制御としてsecurity filtersを説明しています。アプリが利用者やグループの識別文字列を検索条件に渡し、該当しない文書を結果から除外する方式です。これはフィルターへ正しい識別情報を渡すアプリ側の実装が重要になる仕組みです。
同資料では、Microsoft Entraの情報と文書の権限メタデータを使う組み込み方式なども紹介されていますが、確認した時点では一部はプレビューです。機能名だけで導入済みと判断せず、利用するAPI、SDK、データソース、同期の制約を確認してください。
どの方式でも、検索サービスへ接続できるアプリの権限と、その利用者が各文書を読める権限は別です。運営者から開発担当者へは「検索APIのキーを持っているか」ではなく、「この利用者の文書権限を、検索要求のどこで判定しているか」と質問すると、確認対象が明確になります。
顧客ごとの分離は有効。ただし接続先の選択も認可する
Pinecone Docs:Implement multitenancyは、サーバーレスのインデックスで顧客ごとにnamespace(データを区分して操作する単位)を分け、書き込みや検索をそのnamespaceへ向ける構成を示しています。共有検索基盤で複数顧客を扱う場合の分離方法の一例です。
ただし、namespaceの名前を分けただけで、利用者のアクセス権が自動的に決まるわけではありません。Aの利用者が送った要求でBのnamespaceを選べないよう、サーバーが認証済みの所属に基づいて選択する必要があります。顧客単位の分離と、同じ顧客内の担当者・部署ごとの制限も区別してください。
本サイトからは、顧客や機密区分をまたぐことが不要な検索では、範囲を明示的に分ける設計を提案します。一方、横断検索が必要な管理者には、別の権限と記録を用意します。共有か分離かという製品選択より先に、誰がどの範囲を検索できるべきかを決めることが重要です。
権限を取り消しても、古い回答やキャッシュが残る
文書を非公開にする、担当者をプロジェクトから外す、顧客契約を終了する。こうした変更が元の文書システムだけに反映され、検索インデックス側には反映されないと、古い状態で回答できてしまうおそれがあります。運用開始時の権限が正しいだけでは足りません。
OWASPのRAG資料は、文書の削除や権限変更を、派生した検索データや回答キャッシュまで反映することを扱っています。キャッシュを利用者・所属・権限の範囲に合わせ、元資料の変更時に無効化する点も示しています。質問文が同じであることだけで、回答を別人へ再利用しない設計が必要です。
実務では、権限変更から反映完了までの許容時間を決め、その間に何を止めるかを明確にすることを提案します。同期に失敗した機密資料は保留する、関係する検索範囲を一時停止する、といった手順です。障害時に権限情報が取れないからフィルターなしで検索する、という代替動作を避けます。
過去の回答も扱いを決めてください。権限取消後に新しい検索を止めても、過去の会話履歴に引用済みの内容が残る場合があります。保存期間、閲覧者、削除対象、監査記録の扱いは用途に合わせて定めます。すでに利用者が受け取った情報を、後から完全に回収できると保証するべきではありません。
WordPressの公開検索と社内検索は混ぜない
WordPressの記事をAIの参照資料にするなら、公開記事だけの検索と、下書き・非公開記事・会員向け資料を扱う検索を分けて考えます。取り込みアカウントが管理者であるために読めた文書を、匿名訪問者のチャットへそのまま使っていないかを確認してください。
また、投稿の閲覧条件と添付資料の条件が一致するとは限りません。実際の配信経路、会員機能、外部ストレージの設定を確認します。会員向けページから取得したPDFを検索基盤へ登録するなら、PDFの全文、断片、引用、タイトルを誰へ返すかまで決めることを提案します。
レンタルサーバー上で独自開発しない場合も、導入するプラグインやSaaSへ質問できます。「権限が自動で反映されますか」だけでなく、「登録対象の投稿状態」「利用者単位の検索制限」「取消の反映時間」「キャッシュの共有範囲」を確認してください。回答が確認できない範囲は、公開済みの資料だけに用途を限定する判断もあります。
権限のテストは、回答文だけでなく取得記録まで見る
OWASP:Authorization Cheat Sheetは、原則拒否、各要求での権限検査、権限設計を検証するテストを推奨しています。この考え方をRAGへ適用し、正常に答えられるケースと、答えてはいけないケースを組にして検証することを提案します。
- 顧客Aの利用者:Aの許可資料は取得でき、Bの資料は検索結果・本文・引用に現れないことを確認する。
- 同じ顧客の別部署:所属が同じでも、制限された契約や人事資料を取得しないことを確認する。
- 権限変更後:既存の会話、再検索、回答キャッシュを使っても、取消対象が再び返らないことを確認する。
- 同期失敗時:権限情報や認証情報を取得できない場合に、検索範囲が広がらないことを確認する。
- 公開利用者:下書き、非公開文書、会員資料の内容や機密のタイトルが混入しないことを確認する。
検証は自社で許可された環境に、架空の資料とテストアカウントを用意して行います。画面の回答に禁止情報がなかっただけでは、取得処理が安全だったと証明できません。検索結果の文書ID、利用者の所属、適用した権限、モデルへ送った範囲を照合します。ログに実際の機密本文を大量に保存しないよう、記録内容も設計してください。
RAGの安全性は、回答の賢さではなくデータの境界で点検する
権限の制御を整えても、取得した資料の誤り、プロンプトインジェクション、生成内容の誤りは別の課題として残ります。出力チェックは必要ですが、権限外の資料をモデルへ渡さない設計の代わりにはなりません。また、検索データが数値になっているから匿名化済みだとも判断しないでください。
最初から全社のすべての資料をつなぐのではなく、公開可能な文書や権限が明確な小さな範囲から始めることを提案します。対象資料、利用者、権限変更、保存期間を説明できる状態にしてから範囲を広げる。社内文書を読むAIでは、関連する情報を見つける力と、その人に見せてよい情報だけを渡す仕組みを、別々に設計することが大切です。
参考資料
- OWASP:LLM08:2025 Vector and Embedding Weaknesses
- OWASP:RAG Security Cheat Sheet
- Microsoft Learn:Azure AI Searchの文書単位アクセス制御
- Pinecone Docs:Implement multitenancy
- OWASP:Authorization Cheat Sheet