目次
は2026年11月2日、セルフマネージドApache Kafkaを入力にするLambdaのイベントソースマッピングでQueueモードを提供開始したと発表しました。KafkaのShare Groupsを利用し、同じパーティションのレコードを複数の実行で並行処理できるようになります。Web が受け付けた画像変換やファイル検査をKafka経由で処理するチームにとっては、トピックの分割数を増やす前に試せる選択肢です。導入の判断は、順序を外しても結果が正しく、再配信されても成果物が壊れないかで始めます。 AWS Compute BlogのQueueモード発表
スポンサーリンク
順番が入れ替わると困る仕事を先に分ける
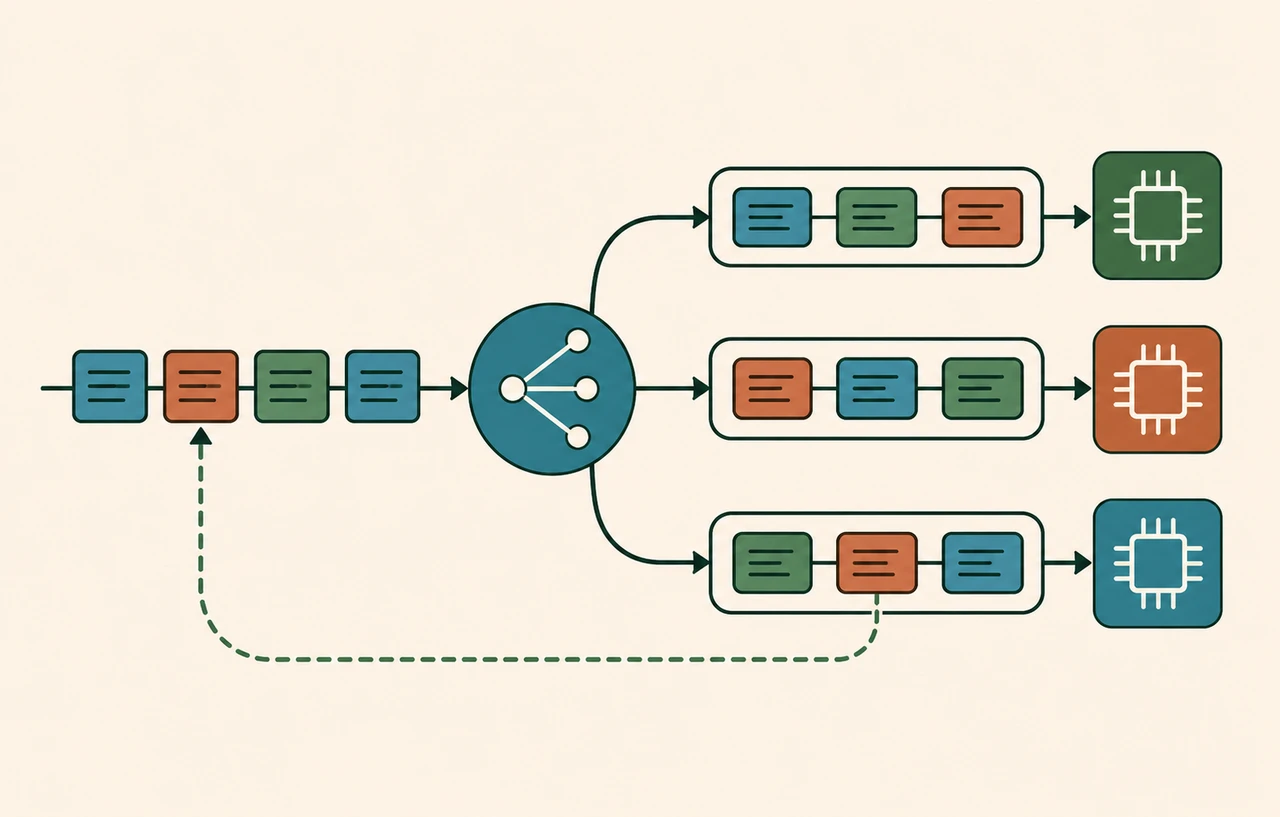
LambdaのイベントソースマッピングはKafkaからレコードを取得し、まとめて関数を呼び出します。従来のStreamモードでは、一つのパーティションを同じグループの一つのコンシューマーが担当します。既存のマッピングに対する既定値はStreamです。Queueモードでは、同じパーティションから複数のポーラーが仕事を取得できるため、先に投入した仕事が後から終わることがあります。順序の判断はトピック全体とパーティション内を分けて行います。
例えば画像Aのサムネイル生成に時間がかかっても、画像Bの生成を先に完了できれば一覧の表示に役立ちます。一方、一件の注文に対する「受付」「取消」の状態変更を受信順のまま反映する構成では、取消が先に処理されると結果が変わります。このような経路では、同じ業務キーを同じパーティションへ送る既存の順序設計を確認し、Streamを維持する選択が適しています。順序が不要なのはどのイベントかを、トピック名ではなく処理結果から判断します。
画像でも、同じ保存先を上書きする複数の更新は相互に影響します。古い原本からの変換が遅れて終わると、新しい画像を上書きすることがあります。原本の版と変換条件を成果物のキーへ入れ、公開先を指すレコードを更新する場合は現在の原本の版と照合する方法が考えられます。別の画像同士が独立していても、同じ画像の更新同士まで独立しているとは限りません。
クラスターの対応と取得開始点を調べる
AWSの発表で示された前提は、Share Groupsを有効にしたKafka 4.2以降と、セルフマネージドKafka用のイベントソースマッピングです。クラスターを外部事業者が運用する構成でも、Kafka Queue機能が使えるか確認します。既にKafkaへ接続できることだけでは、このモードを選べる根拠になりません。マッピングを作る前に対象環境のブローカー版、Share Groupsの設定、接続経路、認証方式、関数の実行ロールを点検します。 AWS Lambda開発者ガイドのセルフマネージドKafka連携
切り替え時に特に注意するのは、最初にどのレコードを読むかです。QueueモードではマッピングのStartingPositionやStartingPositionTimestampを指定できません。新しいShare Groupの読み始めはKafka側のshare.auto.offset.resetで決まります。Apache Kafka 4.2の設定資料では既定がlatestで、earliestや期間を指定する選択肢も示されています。既存のStream側の進捗が新しいグループへ引き継がれる前提で切り替えると、読まれない仕事や二重処理が生まれます。 Apache Kafka 4.2のグループ設定
まず検証トピックへ識別子の異なるレコードを数件入れ、マッピング作成前に投入したものと、利用開始後に投入したものを分けて集計します。テストでearliestを使う場合も、保持期間を過ぎたレコードの復元には使えません。過去分が必要なら、Kafkaに実際に残っている範囲と、アプリ側の未完了一覧から再投入できる範囲を先に突き合わせます。
スポンサーリンク
一つの検証トピックで接続と並列性を確かめる
次は、設定ファイルでQueueモードを指定する未実行例です。AWS と対象環境が設定項目に対応し、検証用の関数、トピック、ブローカーが用意されていることを前提とします。認証やVPCの指定は接続方式ごとに異なり、実際の設定には開発者ガイドに沿った項目を追加してください。この例は少数のレコードで試すため、バッチの最大件数を10としています。
{
  "FunctionName": "image-variant-test",
  "SelfManagedEventSource": {
    "Endpoints": {
      "KAFKA_BOOTSTRAP_SERVERS": ["broker.example.com:9092"]
    }
  },
  "Topics": ["image-variant-test"],
  "BatchSize": 10,
  "SelfManagedKafkaEventSourceConfig": {
    "ConsumptionMode": "Queue"
  }
}
aws lambda create-event-source-mapping --cli-input-json file://queue-esm.json
aws lambda get-event-source-mapping --uuid REPLACE_WITH_TEST_MAPPING_UUID作成後は応答にあるマッピングの識別子を使い、取得した設定、状態、対象トピックを確認します。Queueモードでは時間でバッチをためるMaximumBatchingWindowInSecondsも指定できません。既存のテンプレートから設定を移す際は、モード名に加えて、読み始めとバッチ時間の項目を点検します。CLIが入力を受け付けない場合は、まずCLIが新しい項目を認識するかと、サービス側が設定の組み合わせを拒否しているかを分けて調べます。
マッピングが有効になった後は、一つのパーティションへ小さな仕事を送り、そのうち一件だけを遅くします。観察するのは、遅い仕事の完了を待たずに別の仕事が開始・完了するかです。テスト関数に記録する項目は、業務イベントID、パーティション、オフセット、実行の識別子、開始時刻と完了時刻です。完了順だけを見ると、複数の実行が重なったのか、たまたま速い仕事が先に取り出されたのかを区別できません。
再配信で成果物が増えないかを試す
Share Groupでは取得中のレコードに一時的なロックがかかります。Lambdaの呼び出しが成功すれば処理済みとして扱われ、失敗したレコードは再び取得され得ます。AWSは実行中にポーラーがロックを延長すると説明しています。ロック時間の数値だけで、関数の実行期限や業務処理全体の期限を判断しないでください。Lambdaのマッピングでは重複処理があり得るため、ロック中に他の処理が取得しないことと、将来の再配信が起きないことを区別します。 AWS Lambda開発者ガイドのセルフマネージドKafka連携
同じイベントが届くたびに外部サービスへ通知する関数では、書き込み直後に例外が発生すると通知が再送されるおそれがあります。DBで完結する処理なら、イベントIDを一意に記録する操作と業務更新を同一トランザクションにまとめられるか検討します。外部への送信はDBだけで完了を保証できないため、送信側で使える冪等キーや、送信予定と結果を追跡できる構成を別に設計します。実行IDは呼び出しごとに変わるので、同じ仕事を識別するキーには業務イベントIDを使います。
検証では、正常終了、成果物の保存後に関数が失敗する場合、入力に恒久的な不備がある場合を分けます。二番目では、関数が二回動いても同じ版の成果物が二重登録されないことを確かめます。三番目では、処理不能なレコードを無制限に再試行していないか、失敗先から業務IDを特定できるか、修正後にどの経路で戻すかを試します。失敗先を用意しただけで元のデータを取り出せると想定せず、選んだ送信先に実際に届く情報で復旧手順を通します。
AWSが説明するLambda側のMaximumRetryAttemptsと、Kafka側の配送回数制限は別の設定です。どちらが先に効くかは構成に依存します。正常なレコードと失敗するレコードを同じバッチへ入れ、再処理される範囲も記録します。関数エラー時にバッチを分割する設定を使う場合は、有効にする前後で正常なレコードへの影響を比べます。運用では失敗した試行の数と、処理を完了できなかった業務イベント数を分けて集計します。
スポンサーリンク
並列度は下流が受けられる量から決める
Queueモードはパーティション数とは別に実行を増やせます。実際の処理量は、取得側の容量、関数の同時実行枠、処理時間、下流の容量にも依存します。既定のオンデマンドは検証を始めやすく、ポーラー容量を設定するプロビジョンドは、待ち時間や負荷の変動に対応するための選択肢です。プロビジョンドで最大ポーラー数を決める際は、Share Groupに参加できるコンシューマー数の制約も確認します。 AWS Compute BlogのQueueモード発表
仮に一回の呼び出しが下流APIへ最大三件を並行送信する実装なら、関数が二十並列のとき、単純な設計上の検討値は最大六十件の同時要求です。これは処理件数の実測ではありません。実装がバッチ内で逐次処理する場合と一括で並行処理する場合では、同じ関数の同時実行枠でも下流の負担が変わります。DB接続、外部APIの利用制限、タイムアウト後の再送を含め、先に同時実行の予算を決めます。
負荷試験では、一定量を流す区間、短時間に投入を増やす区間、下流を遅らせる区間を用意します。記録するのは投入から完了までの時間、滞留の増減、関数の実行時間、失敗や再配信、下流側の接続待ちです。ポーラーだけ増やして滞留が減らないときは、同時実行制限で関数が起動できないのか、関数が起動しても下流待ちで終わらないのかを分けます。件数が伸びても完了までの時間が悪化するなら、採用条件を満たすとは判断しません。
二重実行を防ぎながら本番へ移す
AWSの発表では同じトピックにStreamとQueueのマッピングを設けられます。両者は独立して読むため、同じ処理先へ書く構成で並行稼働させると、副作用が重なる可能性があります。先に検証用のトピックや副作用のない比較用関数で動きを確かめ、元の処理と並べる場合も書き込み先を分けます。検証から本番へ移す境界には、対象となるイベントの種類と、どちらの経路が成果物を確定するかを記録します。
切り戻しでは、旧マッピングの再開だけで欠けた仕事が埋まるとは考えず、投入した業務IDと完了した業務IDを照合します。試験では、切り替え時刻の前後で送った仕事について、どちらの経路が処理したか、失敗先に残ったか、未処理として再投入できるかを確認します。順序を要する経路を維持しつつ、独立した仕事で重複・滞留・復旧を管理できることが、Queueモードを採用する判断材料になります。
関連記事
DBの確定との境界については、LaravelのafterCommitによるジョブ投入順序の解説も参照できます。Laravelの設定とは別に、イベントの投入と処理結果の確定を切り分ける視点が役立ちます。
参考資料
AWS Compute BlogのQueueモード発表
AWS Lambda開発者ガイドのセルフマネージドKafka連携
Apache Kafka 4.2のグループ設定