目次
は2026年11月11日、Amazon SageMaker HyperPod上のPyTorch Distributed Data Parallel(DDP)で、Silent Data Corruption(SDC)を検知し、疑わしいノードを隔離して学習を再開する実装例を公開しました。SDCはGPUがエラーを報告せず、もっともらしい誤った演算結果を返す現象です。学習が停止しないまま勾配や重みへ誤りが混ざるため、損失曲線やジョブの終了状態だけでは気付けない場合があります。
今回の公開物は、HyperPodへ新しいマネージド機能が追加されたという発表ではありません。学習コード側に三つの検査を組み込み、検知後はHyperPodのノード管理機能と組み合わせて復旧する技術解説とサンプル実装です。大規模なGPU学習を運用するチームは、監査間隔による負荷、再現可能なマイクロバッチ、共有チェックポイント、誤検知時の判断者まで含めて採否を決める必要があります。
スポンサーリンク
Silent Data Corruptionが通常の監視をすり抜ける理由
GPUの訂正不能なメモリエラーやXid、温度異常のように、ハードウェアやドライバーが報告する障害は、HyperPodのヘルスモニタリングと自動復旧の対象にできます。一方、SDCではカーネルが完了し、出力も有限値のままです。ジョブは正常に進み、チェックポイントも形式上は保存できます。ファイルのチェックサムを検証しても、保存前に誤った重みが作られていれば「誤りを正しく保存したファイル」しか確認できません。
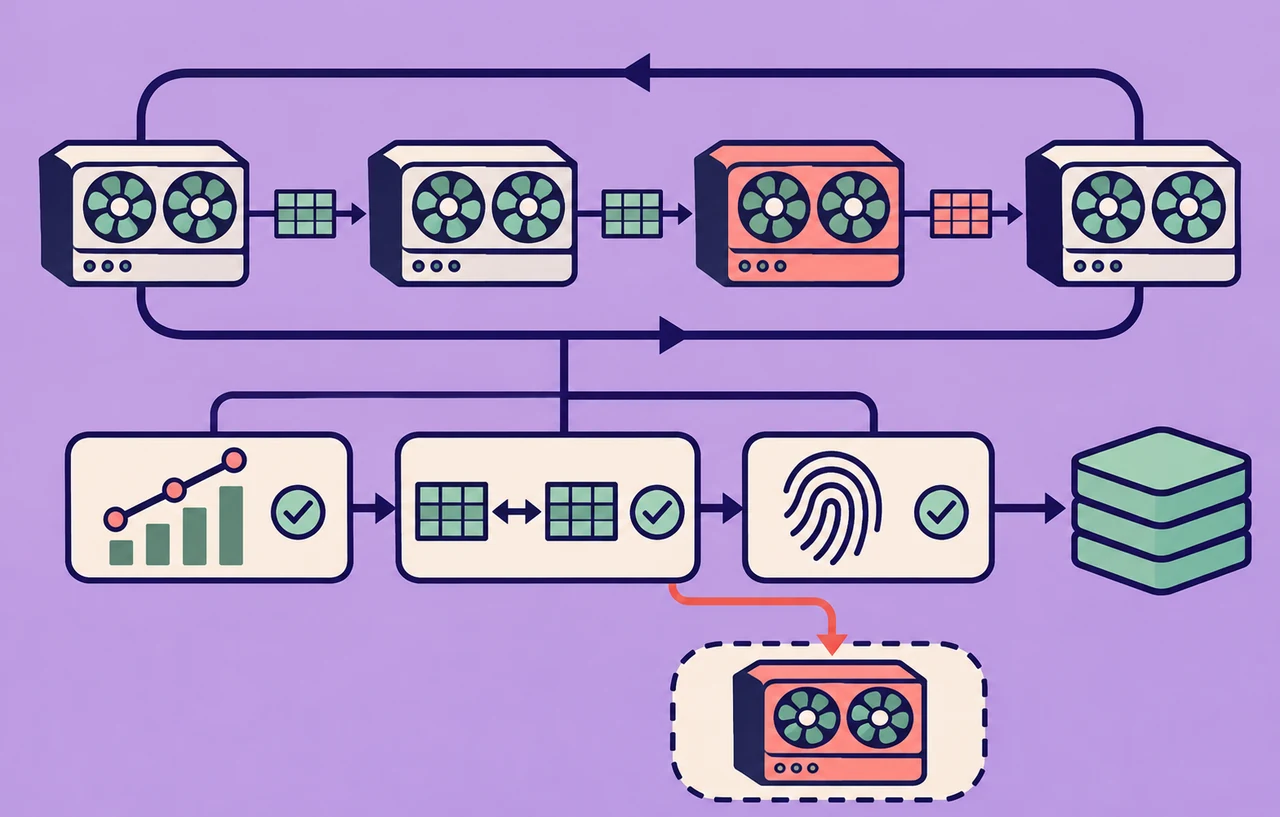
AWSの実装は、この空白を学習処理の内側から埋めます。単一の指標へ依存せず、分散通信の前後、別ノードによる再計算、オプティマイザー更新後という異なる地点で整合性を調べます。異常を検知した時点でチェックポイントの公開を止めることが重要です。検知だけ追加しても、疑わしい状態を「最新」として保存して再開に使えば、復旧にはなりません。
DDPへ追加する三層の検査
| 検査 | 実行位置 | 分かること | 主な限界 |
|---|---|---|---|
| 非有限勾配チェック | all-reduceの前後 | NaNやInfの発生。通信前なら発生rankも絞れる | 有限値の誤りは通過する |
| リング再実行監査 | 指定した監査step | 別ノードが同じマイクロバッチを再計算し、lossや勾配の一致を確認する | 監査しないstepの一過性異常は逃し得る |
| 重みフィンガープリント | optimizer.step後 | 同じ更新を行ったreplica間で重みの食い違いを検出する | 厳密な多数決には3コピー以上が必要 |
第一層は、各rankで勾配がNaNやInfになっていないかをall-reduceの前後で調べます。通信前に異常があればローカルrankを特定しやすく、通信後だけなら集約中の異常も疑えます。ただし、SDCの出力が有限値ならこの層だけでは検知できません。
第二層のリング監査では、監査対象のstepで別ノードが隣のrankのマイクロバッチを再実行します。既定の軽量な経路は再現可能なlossを比較し、決定論を強めた経路では勾配のフィンガープリントまで比較できます。元の実行と再実行が一致しなければ、どちらかに問題があります。3台以上の異なるノードを使えば複数の比較結果から疑わしいノードを絞れますが、同じ物理ノード内のGPUだけで輪を作ると独立した確認になりません。
第三層は各replicaの重みから二つの64bit集計値を作り、optimizer.step後に照合します。勾配が同じでも、更新処理や保存された重みにだけ誤りが生じた場合を拾う役目です。フィンガープリントの一致は強い証拠になりますが、暗号学的な完全性証明ではありません。2コピーの不一致では異常の存在は分かっても、どちらが正しいかは決められません。自動隔離まで行うなら、厳密な多数決が成立する構成を確認します。
スポンサーリンク
導入前に揃える四つの前提
- 異なるノード上のGPUを3台以上用意する。監査の独立性と多数決の前提です。AWSのサンプルはHyperPodのEKSクラスターを対象にしています。
- マイクロバッチを正確に再構成できるようにする。seed付きsamplerだけでなく、前処理、乱数、autocast、loss計算まで同じ条件にします。
- チェックポイントを共有ストレージへ置く。ノード交換ではローカルボリュームが失われ得るため、Amazon FSx for LustreやAmazon S3など、交換対象から独立した保存先が必要です。
- rankと実体の対応を記録する。起動時にrank、Kubernetesノード、インスタンスID、GPU UUIDを対応付け、アラームから隔離対象へ戻れるようにします。
再実行の決定論は特に難しい条件です。データだけ同じでも、非決定的なCUDAカーネル、BatchNormの状態更新、乱数を使う層、forward hookの副作用があれば比較結果が変わります。AWSは決定論的な実装の有効化やCUBLAS_WORKSPACE_CONFIGの設定を示していますが、未対応の演算ではエラーになることがあります。まず本番モデルと同じ演算で、故障を注入しない状態の誤警報率を測る必要があります。
監査間隔は検知範囲と学習速度の交換条件
AWSは、ml.p5.48xlargeを3〜4台、H100 80GBを24〜32基、PyTorch 2.9とCUDA 13、約9.53億パラメーターのLlama風モデル、合成データという条件で負荷を測定しました。通常のDDPは1 stepあたり157.4msでした。検査を有効にして監査を行わない場合は169.0msで7.4%増、既定のloss監査を10 stepごとに行う場合は177.0msで12.5%増、100 stepごとなら169.3msで7.6%増でした。
勾配まで決定論的に比較する監査は重く、10 stepごとで211.9ms、34.7%増でした。100 stepごとでは173.3ms、10.1%増です。AWSはこの検証条件では「決定論的監査を100 stepごと」を現実的な開始点として示していますが、普遍的な推奨値ではありません。モデル、sequence length、通信比率、監査対象の演算で負荷は変わります。自分のワークロードで、監査間隔中に失い得る更新数と追加時間を同じ表へ載せて決めるべきです。
故障を注入しない実行では、15,320回の監査と3,080回の重み検査でアラームがなく、AWSは95%信頼水準で誤警報率がおよそ5,100回に1回未満という上限を示しました。これは掲載されたモデルと環境での結果です。異なる演算やhookを含む学習へ、そのまま適用できる保証ではありません。
スポンサーリンク
検知後は停止・隔離・診断・交換を分ける
異常を検知したら、最初に学習とチェックポイント公開を止めます。次にrank対応表からKubernetesノードとGPUを特定し、ノードをcordonして新しいpodが載らないようにします。DCGM、Xid、ECC、温度、電力などのテレメトリーは原因の手掛かりになりますが、値が正常でもSDCを否定できません。深いで再現性を調べ、交換するかを判断します。
初期導入では、アラームからノード交換までを完全自動化せず、人の承認を挟む方が安全です。ソフトウェアの非決定性をハードウェア故障と誤認すると、健全なノードを交換し続ける可能性があります。異なるノードでも同じ入力で同じ不一致が再現するならソフトウェア側を疑い、特定ノードに追随するならSDCの強い候補として扱います。ただし、同じノードで再現しないことだけではSDCを除外できません。
交換を決めたら、HyperPodのノード交換操作を使い、疑わしい期間より前の共有チェックポイントから再開します。読み込み直後にも重みフィンガープリントを照合し、全replicaが同じ状態から始まることを確かめます。Karpenterを使う構成では、cordonしただけで必ず代替ノードが増えるとは限りません。pending podなど、置き換えを要求する状態まで含めて手順を検証します。
この方式がカバーしない範囲
三層を組み合わせても、すべての誤りを検知できるわけではありません。有限値のall-reduce誤りが監査対象外のstepで一度だけ起き、重みの比較でも全replicaへ同じ結果として反映されれば通過する可能性があります。監査間隔が長いほど、検知前に破棄する更新も増えます。チェックポイントへ「検査済みstep」を記録できても、そのcheckpointが数学的に正しいという証明にはなりません。
また、AWSのサンプルは通常のDDPを前提にしています。unused parameter、勾配蓄積、状態を持つ層や副作用のあるhookは個別検証が必要です。FSDPやZeROのようなsharded weight、tensor parallel、pipeline parallel、context parallelでは、重みの持ち方と通信の境界が異なります。DDP用のフィンガープリントや多数決を移植しただけでは成立しません。対象の並列方式ごとに、同じ計算を独立に再確認できる地点を設計し直します。
本番導入の判断手順
- 現在の監視が扱うのは報告されたハードウェア障害か、計算結果の整合性まで含むかを分ける
- 本番と同じモデル・データ処理で、再実行が決定論的になる範囲を確認する
- 監査間隔ごとに、追加時間と巻き戻す最大step数を測定する
- checkpoint保存前のゲートと、疑わしい期間を追跡するを実装する
- rankからノード・GPUへ戻る対応表、cordon、深い診断、交換、再開を訓練する
- 誤警報率を蓄積し、自動交換へ進める条件と承認者を決める
SDC対策の価値は、アラームを一つ増やすことではありません。誤った計算を検知した時に、汚染されたcheckpointを残さず、対象ノードを特定し、既知の状態へ戻れる運用経路を作ることです。まずは小さな検証ジョブで三つの検査と復旧手順を通し、その後に学習時間と失い得る更新量のバランスを調整するのが現実的です。
関連記事
- AIの改善を勘で判断しないために|評価データと回帰テストの始め方 — 計算基盤の整合性とは別に、モデルや変更後の出力品質を比較する方法を整理しています。
スポンサーリンク
参考資料
- AWS Machine Learning Blog「Detecting and recovering from silent data corruption on Amazon SageMaker HyperPod」
- AWS Documentation「SageMaker HyperPod clusters orchestrated by Amazon EKS」
- AWS Documentation「Manually manage resiliency on SageMaker HyperPod EKS clusters」
- AWS Labs「PyTorch DDP SDC detection example」