目次
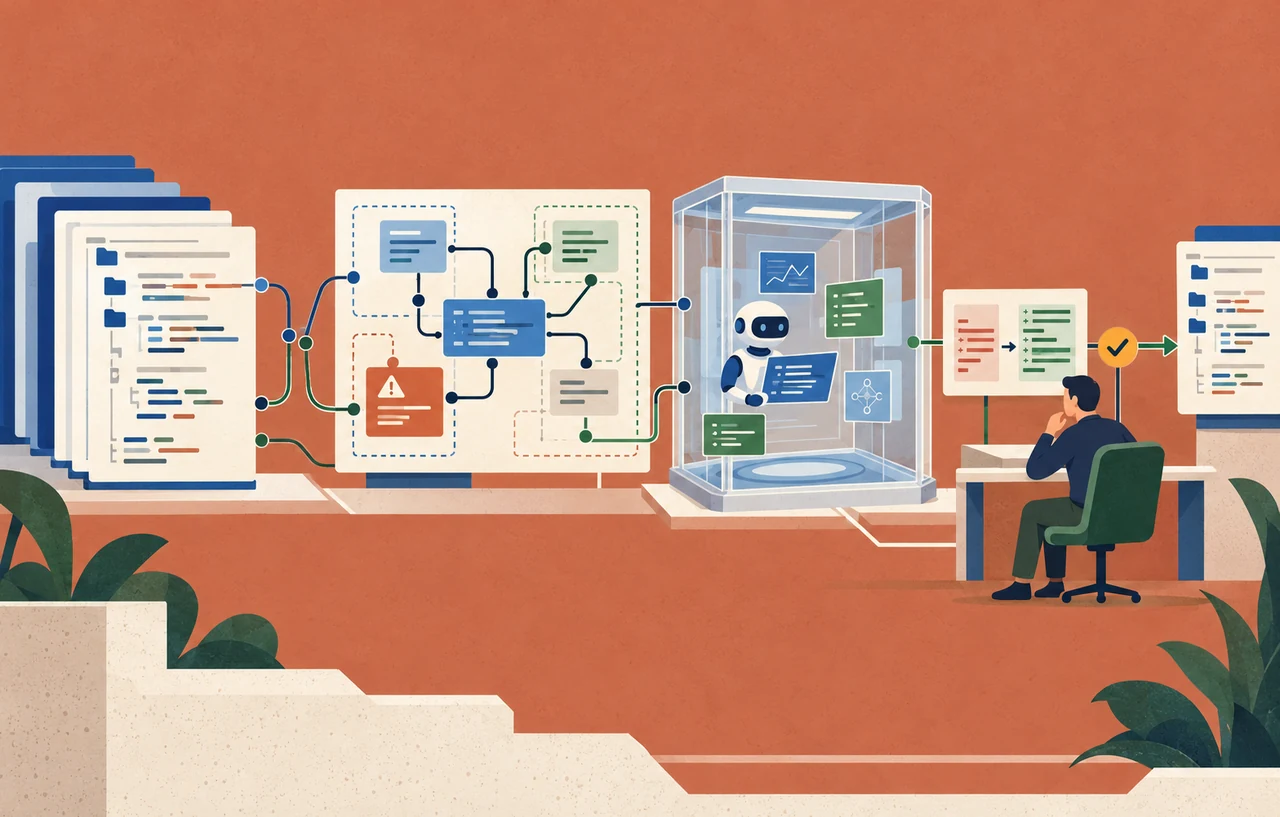
コードをAIへ渡せば、脆弱性の発見から修正案まで自動で進む——Codex Securityは、その作業をGitHubやローカルのコードに対して行うセキュリティエージェントです。ただし、スキャン完了や「検証済み」という表示だけで安全を保証できるわけではありません。導入時に先に決めるべきなのは、どのコードを読ませるか、どの攻撃者像を前提にするか、AIが作った証拠とを誰が確認するかです。
本記事は、OpenAIが更新したCodex Securityのヘルプ、プラグイン資料、スキャン手順を2026年10月25日に確認した安全な導入の解説です。新たなの速報ではありません。公式資料で確認できる機能と、本サイトが提案する運用判断を分けて整理します。
スポンサーリンク
最初にCloud・プラグイン・CLIを分ける
Codex Securityには、接続したGitHubリポジトリを継続的に調べるCloud、Codex上でリポジトリや差分を調べるプラグイン、端末やから実行するCLIがあります。OpenAIは、Cloudを管理された継続スキャン、プラグインを試用や一つのコードベース・変更差分の調査、CLIをローカル開発やCI/CDへの組み込みに向く選択肢として説明しています。
| 方式 | 主な対象 | 導入前に確かめること |
|---|---|---|
| Codex Security Cloud | 接続したGitHubリポジトリの継続スキャン | 接続対象、組織の権限、課金枠、履歴を含む初回スキャン |
| Codex Securityプラグイン | リポジトリ、フォルダ、ブランチ、コミット、差分 | 開く作業フォルダ、追加コンテキスト、実行するモデルと推論量 |
| Codex Security CLI | ローカル開発、バルク処理、CI/CD | 実行環境の権限、秘密情報、ネットワーク、成果物の保存先 |
この違いは、操作画面の好みではなく信頼境界の違いです。Cloudを使うなら、GitHub上のどのリポジトリを接続し、誰がスキャン設定を管理できるかが中心になります。プラグインやCLIでは、選択したフォルダに何が含まれ、実行環境からどこへアクセスできるかを確認します。「Codex Securityを導入する」という一語で済ませず、対象コード、接続先、実行場所を方式ごとに台帳へ記録してください。
脅威モデルが誤れば、見つけるべき問題もずれる
Codex Security Cloudは、リポジトリを解析して、攻撃者の入口、信頼境界、機密データ、重要なコード経路を含む脅威モデルを作ります。このモデルは閲覧・編集できます。プラグインのスキャンでも、攻撃者が操作できる入力、越えてはいけない境界、機密操作、重点領域を追加コンテキストとして渡せます。リポジトリ直下のSECURITY.mdには、報告対象、除外範囲、重要度の前提を継続的な方針として書けます。
ここで人が補うべきなのは、コードだけでは分からない本番環境の事実です。たとえば、管理が社内ネットワークだけに公開されるのか、公開インターネットから到達できるのかで、同じ入力処理の優先度は変わります。認証後の一般利用者と運用管理者で許される操作も異なります。外部のへ送信できる情報、ジョブが保持する権限、テナント分離の単位も、リポジトリの構造だけから正確に推定できるとは限りません。
- 外部から到達できる入口と、攻撃者が制御できる値
- ・認可・テナント分離で守るべき境界
- 秘密情報、個人情報、決済情報、署名鍵などの重要資産
- サーバー側リクエスト、ファイル操作、コマンド実行など高影響の処理
- 対象外にする生成物、テスト用コード、廃止予定コンポーネント
初回スキャンの前に、この五点を開発者と運用担当者が短く合意すると、AIが推定した脅威モデルをレビューしやすくなります。AIへ詳細な前提を渡すこと自体が目的ではありません。実際の配置と異なる前提で重要度を上げ下げしないための作業です。
スポンサーリンク
「検証済み」は完全な再現や網羅を意味しない
Codex Securityは、候補となる問題を隔離環境で再現し、攻撃経路や実行結果を確かめてから提示しようとします。これは、構文パターンだけで大量の警告を出すスキャナーとは異なる価値です。一方、公式のスキャン手順は、完了したスキャンと完全な網羅は別の主張だと明記しています。実行時の再現がなくても、ソースコード上の根拠から判断される場合があり、確認を先送りした領域や未解決の疑問も残ります。
レビューでは「検証済み」という一語より、対象リビジョン、調査範囲、攻撃者がどこから到達するか、どの制御が失敗するか、影響を支える証拠、再現できなかった条件を読みます。モノレポでは全体を一度に渡すより、所有者とセキュリティ境界が明確なサービスやパッケージ単位に分ける方が、何を調べたのかを追跡しやすくなります。
また、Codex Securityはファジングや署名ベースのスキャンそのものではありません。既存のSAST、依存関係スキャン、秘密情報検出、コンテナ検査、動的試験を置き換えたと判断しないでください。既存ツールで拾う既知パターンと、コードベースの文脈を使って攻撃経路を調べる役割を並行させ、重複より見落としの種類を評価するのが適切です。
提案パッチは自動適用せず、別工程で確かめる
公式ヘルプによれば、Codex Securityはコードを自動変更せず、人が確認するパッチを提案し、必要ならPull Requestへできます。この境界は維持すべきです。脆弱な経路を閉じても、認証フロー、互換性、性能、エラー処理を壊す修正はあり得ます。発見に使った同じ説明だけで修正を正当化せず、既存レビュー、テスト、を通します。
- 対象のリビジョンと攻撃経路を人が確認する
- 根本原因と、修正で維持すべき正常系を言語化する
- 提案差分を通常のコードレビューへ送る
- 脆弱な入力を再現するテストと既存の回帰テストを実行する
- マージ後に同じ条件で再検証し、検出だけで終了しない
AIによるパッチへ別のAIコードレビューを重ねても、人の責任が消えるわけではありません。レビュー担当者は、修正が境界の手前で入力を拒否するのか、危険な操作へ到達できなくするのか、単に既知の再現手順だけを通らなくするのかを区別します。テストの設計については、AIの改善を勘で判断しないための評価データと回帰テストも参考になります。
スポンサーリンク
権限と費用は小さく始めて観測する
Codex Securityは現在、ChatGPT Enterprise、Edu、Business、Pro向けのリサーチプレビューです。Cloudはトークン課金で、既存利用者には有料利用前の通知とオプトインがあり、資金がなければスキャンが停止すると説明されています。EnterpriseとEduでは、Codex CloudとCodex Securityの利用権限に加え、スキャン設定を管理する管理権限をロールやSCIM同期グループへ分けられます。
最初から全リポジトリを接続せず、非本番で機密度が比較的低く、担当者とテストが揃った一つのサービスから始めます。利用者と設定管理者を分け、接続リポジトリ、スキャン頻度、使ったモデル、推論量、対象リビジョン、調査範囲、所要時間、費用、採用・却下した指摘を記録します。プラグインの公式ページにはInteractive・Read・Writeの能力表示があるため、インストール時には表示される権限と接続アプリを確認し、必要な範囲だけを許可します。
評価指標は発見数だけにしません。人が確認できた真の問題、誤検知、重要度の修正、調査を先送りした範囲、修正後に再現しなくなった件数、レビュー時間を追います。結果が改善しない場合、モデルを強くする前に、脅威モデル、スキャン単位、SECURITY.md、ビルド・検証手順を見直します。
初回スキャンを比較可能な基準にする
最初の一回は、製品の発見能力を断定するテストではなく、自社の運用で比較を始める基準として残します。公式手順も、リポジトリのリビジョン、プラグインの版、モデル、推論量を記録するよう案内しています。加えて、対象フォルダ、追加した脅威情報、利用できたビルド・テストコマンド、ネットワークや外部サービスの制約を保存すると、次回の結果が変わった理由を追いやすくなります。
既知の脆弱性を使って試す場合は、その場所を事前にAIへ教えたのか、伏せたまま見つけられるかを記録します。既知の一件を発見できても、リポジトリ全体の網羅性は証明できません。反対に見つからなかった場合も、モデルだけが原因とは限らず、対象範囲、依存関係の準備、実行できなかったテスト、脅威モデルの前提を切り分ける必要があります。
共有用のreport.mdを保存するときは、単独のファイルだけを配布して終えず、どのコミットと設定から作ったかを紐付けます。問題を却下した場合も「誤検知」とだけ書かず、到達不能、別ので遮断、対象外の配置など理由を残します。後から環境が変われば、過去の却下理由が成立しなくなるためです。
導入可否を決める7項目
- Cloud・プラグイン・CLIのどれを使い、コードが置かれる場所を説明できるか
- 接続するリポジトリやフォルダを最小限に絞ったか
- 攻撃者、入口、信頼境界、重要資産を脅威モデルへ反映したか
- スキャン完了と網羅、ソース上の判断と実行時再現を区別するか
- AIの提案パッチを自動適用せず、通常のレビューとテストを通すか
- 既存のSAST・依存関係・秘密情報・動的試験を継続するか
- 権限、費用、誤検知、保留範囲、修正後の再検証を記録するか
Codex Securityの価値は、AIが安全という判定を代行することではなく、コードの文脈から調査仮説、攻撃経路、検証材料、修正案を作り、人が判断できる形へ近づける点にあります。小さな対象で基準を作り、何を確認できて何が残ったかを読めるチームなら導入候補になります。完了表示だけで安全性を判断する運用なら、接続範囲を広げる前にレビュー工程を整えるべきです。
関連記事
スポンサーリンク