目次
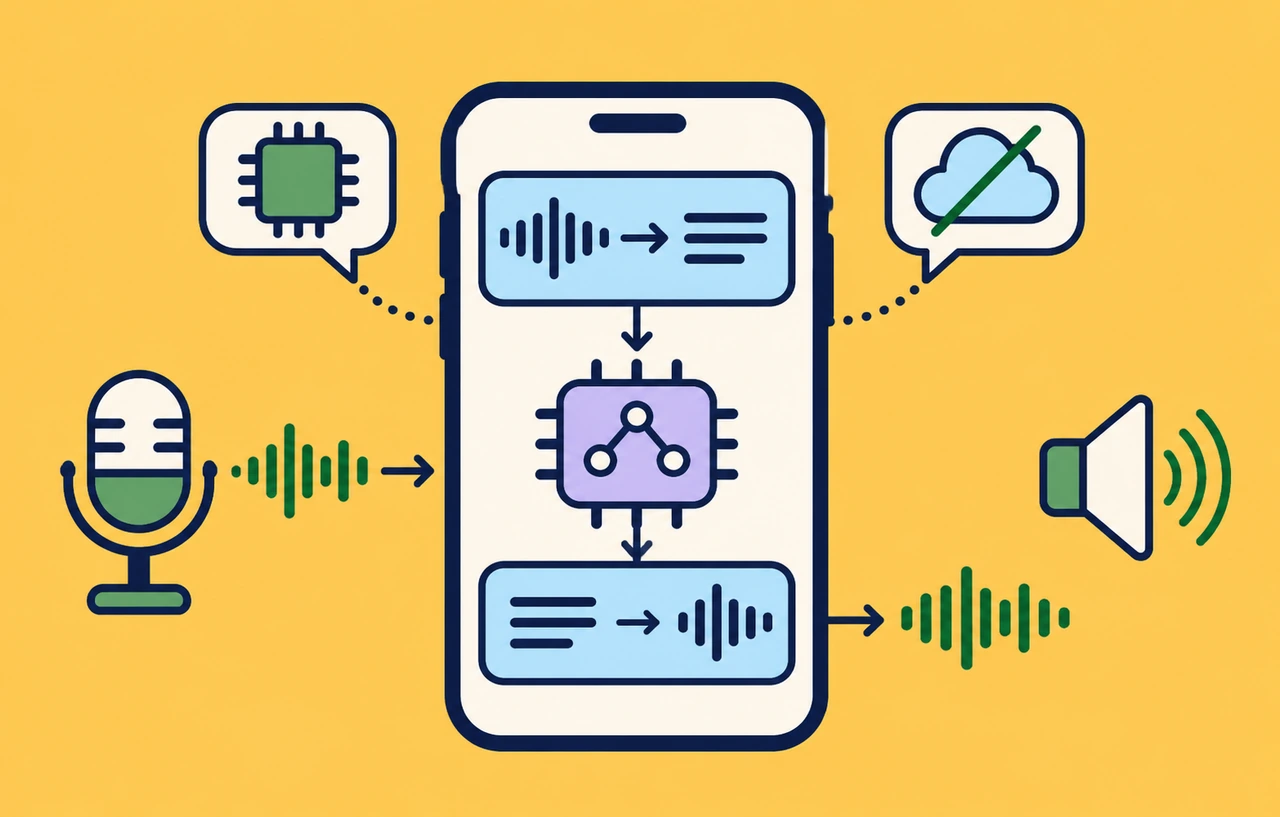
Googleは2026年11月10日、Google AI Edge Galleryに端末内で動く音声認識(ASR)と音声合成(TTS)を追加しました。通信できない環境でも、話した内容を文字にして小型言語モデルへ渡し、応答を音声で返す一連の処理を端末内で構成できます。対象はAndroidだけではありません。Googleは、Android向けのML Kitと、Web・iOS・macOS・Windows・を視野に入れたMediaPipe Tasks/LiteRTという二つの実装経路を示しています。
ただし「オフラインで動く」という一点だけで採用を決めるのは早計です。ML Kitの新しいGenAI音声はアルファ提供で、対応端末や利用条件が限られます。オープンウェイトのモデルを使う経路では、モデルの配布容量、初回起動、端末ごとの性能差をアプリ側で管理します。本記事では、発表内容を機能紹介で終わらせず、どの経路を選び、何を測って本番採用を判断するかを整理します。
スポンサーリンク
今回追加されたのは「音声モデルを分離したローカルパイプライン」
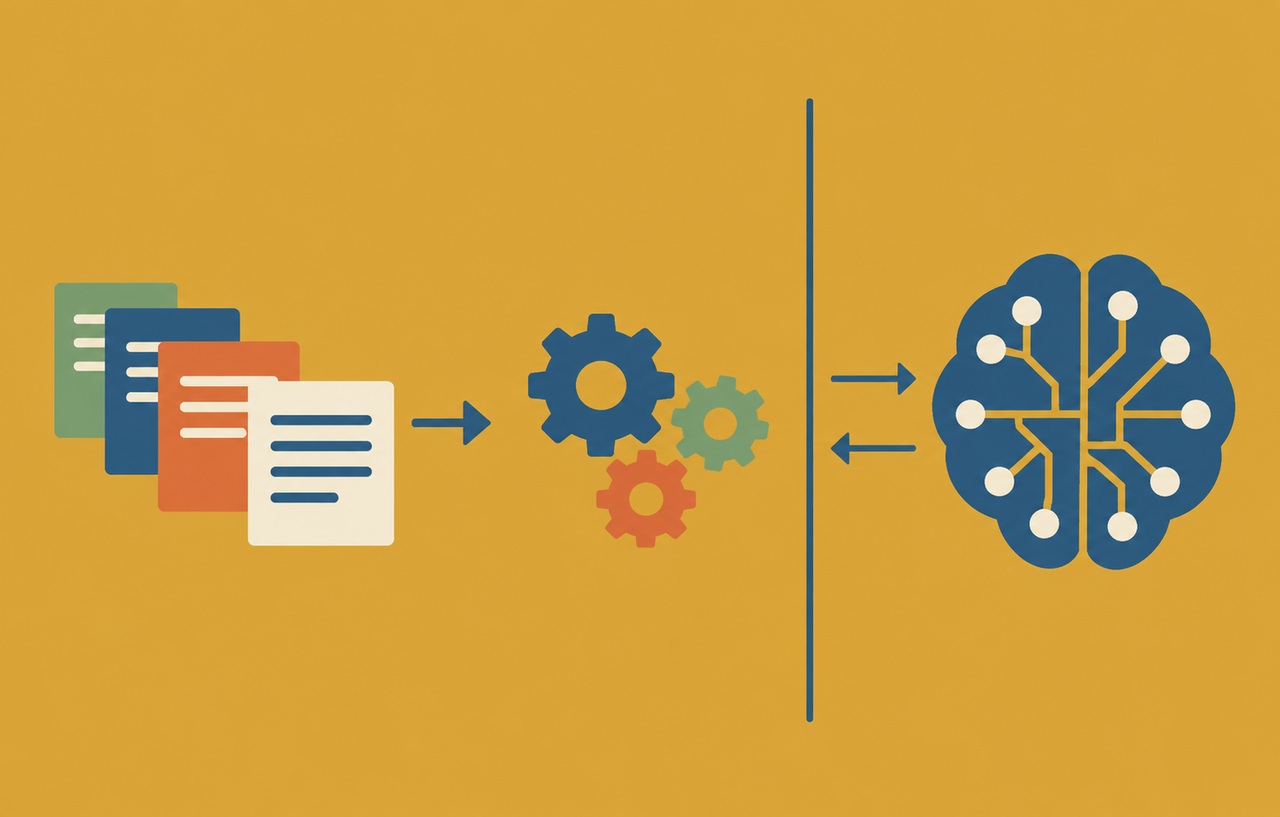
Google AI Edge Galleryの新機能は、音声を直接理解する一つの大きなマルチモーダルモデルだけに依存しません。ASR、Gemini NanoまたはGemma 4などの小型言語モデル、TTSを分離し、順につなぐ構成です。音声認識中は部分結果をストリーミングし、言語モデルの回答は文単位で合成へ送れます。音声モデルを分離することで、認識言語、声、モデルサイズ、対応ハードウェアを用途に合わせて交換しやすくなります。
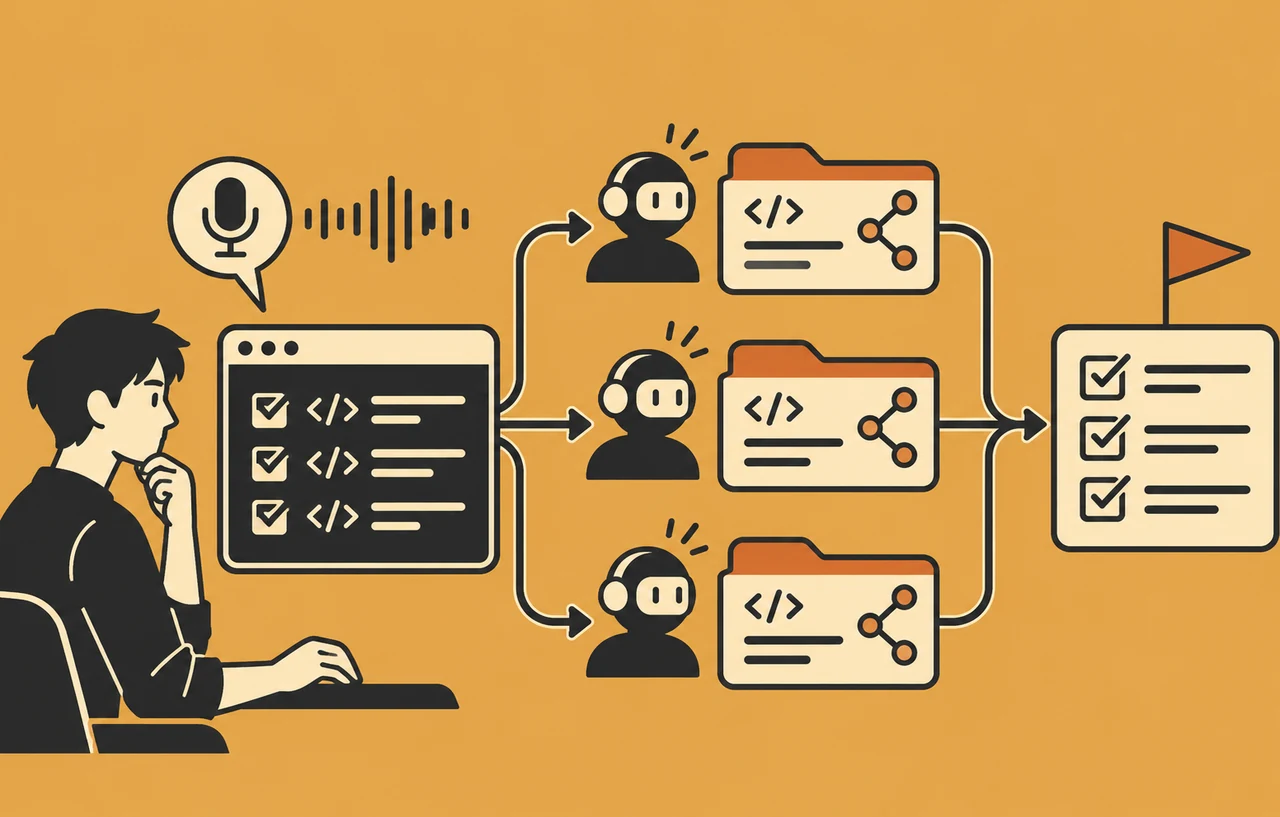
公開されたXR Language Teacherの例では、カメラ映像と音声質問を端末内モデルへ渡し、説明文と外国語フレーズを構造化出力で分離します。TTSは区分に応じて言語や声を切り替えます。AI Chatでは、Markdown記号を読み上げから除き、コードや表を飛ばし、文単位で音声合成を予約します。これは実装上の重要な示唆です。トークン生成と音声合成を無制御に同時実行すると、CPU・GPU・NPU、メモリ、音声バッファを取り合い、かえって無音時間や途切れが増えるためです。
Android中心ならML Kit、複数OSやモデル選択ならMediaPipe Tasks
| 選択肢 | 向いている構成 | 運用上の負担 |
|---|---|---|
| ML Kit GenAI Speech Recognition/Text to Speech | 対応するAndroid端末を明確に限定でき、OS統合モデルとハードウェア支援を使いたい | 端末・AICore・モデル利用可否の判定とが必要 |
| MediaPipe Tasks | Web、iOS、デスクトップを含め、共通の高水準APIでASR・TTSを組みたい | モデル配布、端末別ベンチマーク、VADや再生設計の確認が必要 |
| LiteRTを直接利用 | 独自モデルや細かな実行制御、特定ハードウェアへの最適化が必要 | 前処理、モデル変換、メモリ管理、品質検証の責任が最も大きい |
ML Kitの利点は、モデルをAPKへ同梱せず、AICoreやGoogleの音声サービスを通じて利用できることです。Googleの発表では、Android向けASRは100以上の言語、実時間の10倍の処理速度、TTSは約100ミリ秒で発話を開始し、24kHz音声を最大で実時間の50倍の速度で合成すると説明されています。これらはGoogleが示した測定値であり、利用者の端末や発話条件で同じ結果を保証するものではありません。
制約も明確です。ML Kit GenAI Speech Recognition APIはアルファで、SLAや非推奨化ポリシーの対象外であり、後方互換性を壊す変更があり得ます。はminSdk 26以上ですが、BasicモードはAPIレベル31以上、AdvancedモードはPixel 10・11系やGemini Nanoを搭載する一部チップセットなど、実行条件がさらに狭くなります。TTSも対応端末が限定され、GoogleのSpeech Recognition & Synthesisアプリが最新である必要があります。アプリの最低SDKだけを見て「全Android端末で利用可能」と判断してはいけません。
MediaPipe Tasksは、音声フレーム、Voice Activity Detection(VAD)、デコード処理などを高水準APIで扱い、iOS、macOS、Windows、Linux、Webへ広げる経路です。発表時点では、ASRにParakeet-TDT 0.6B、TTSにPocketTTS 100M、Kokoro-82M、英語向けのPhonon 31Mなどが例示されています。LiteRTでは、エンコーダー、デコーダー、トークナイザー、辞書、声の埋め込み、ボコーダーといった複数部品を一つの.litertlmへまとめて配布できます。
スポンサーリンク
本番アプリでは利用可否を起動時に判定する
端末内AIでは「SDKを組み込めた」と「その端末で機能を使える」は別です。ML Kitの公式手順では、認識器や音声を初期化した後にcheckStatus()で状態を確認し、DOWNLOADABLEならモデルを取得、AVAILABLEなら推論へ進み、UNAVAILABLEなら別経路を選びます。この判定を設定画面の奥に置くのではなく、音声ボタンを表示する前に行う設計が必要です。
when (speechRecognizer.checkStatus()) {
  FeatureStatus.AVAILABLE -> enableLocalVoice()
  FeatureStatus.DOWNLOADABLE -> showModelDownload()
  else -> enableFallbackInput()
}初期化直後のAICoreでは、構成ファイルの取得が終わらず、一時的に利用不可になる場合があります。ブートローダーをアンロックした端末は対象外です。したがって、利用不可を恒久的な非対応と決めつけず、「再試行可能」「端末非対応」「モデル取得失敗」「権限拒否」を分けて扱います。音声機能が使えないときも、テキスト入力、Android標準TTS、または許可を得たAPIへ切り替えられるようにします。
モデルのダウンロードは通信量とストレージを消費します。初回起動で自動取得すると、ユーザーは音声入力前に理由の分からない待ち時間を経験します。モデル名、概算容量、対象言語、Wi-Fi待機の有無、削除方法を示し、取得完了までは入力方法を残します。オフライン機能でも、最初のモデル取得や更新には通信が必要になり得る点を製品説明へ明記すべきです。
ASRは部分結果と確定結果を分けて扱う
ストリーミングASRは、話している途中の部分結果を連続して返します。部分結果は後から修正されるため、そのまま業務データへ保存したり、検索や外部操作を実行したりしない設計が安全です。画面には暫定表示し、確定結果を受け取ってから次の処理へ渡します。送信前にユーザーが編集できる導線も残します。
ファイル入力では形式も確認します。ML KitはMP3、WAV、FLAC、M4A、OGGを端末内でデコードしますが、raw PCMを与える場合は16bit、16kHz、モノラルが要件です。ストリーミング用のファイルディスクリプタへデータを速く書き過ぎるとバッファがあふれます。ONE_SHOTでは書き込み側を閉じないと終了が伝わらず、確定結果が返りません。音声認識の失敗をモデル品質だけの問題とせず、入力形式、終端、権限、バッファの順に切り分けます。
スポンサーリンク
TTSは文単位のキューとキャンセルを設計する
言語モデルの回答を一括で待ってからTTSへ渡すと、発話開始が遅くなります。一方、短すぎる断片ごとに合成すると、抑揚が不自然になり、キュー管理も複雑です。Google AI Edge Galleryの参照実装にならい、句点などで文を確定し、読み上げキューへ追加する方式が現実的です。コードブロック、表、URL、Markdown記号をどう扱うかは、合成前の正規化規則として固定します。
ユーザーが次の質問を始めたとき、前の回答を即座に止められることも重要です。停止、再開、文の移動、話速・声・言語の変更を状態として管理します。ASRのマイク入力とTTS再生が重なる構成では、端末のスピーカー音を再認識しないよう、半二重にするか、エコーキャンセルを含む音声経路を検証します。外国語を含む回答では、言語タグの欠落時にどの声へ戻すかも決めておきます。
導入前に測るのは平均速度だけではない
- 初回準備:モデル取得時間、容量、失敗率、再開可否
- 認識:発話開始から部分結果・確定結果までの時間、固有名詞や雑音下の誤り
- 合成:Time to First Audio、文間の空白、長文時の途切れ
- 資源:ピークメモリ、端末温度、電池消費、他の端末内モデルとの競合
- 利用範囲:対応言語、端末、OS、アクセシビリティ、オフライン復帰
Googleが示した速度は技術選定の参考になりますが、自社の最低対応端末で再測定します。ハイエンド端末一台の平均値だけでは足りません。初回と二回目以降、短文と長文、静かな室内と雑音、画面表示中とバックグラウンド復帰後を分けます。音声認識率だけでなく、訂正に要する操作回数や、発話開始まで待てず離脱した割合も確認すると、UIとしての採否を判断しやすくなります。
Google AI Edge Gallery自体は実験的なベータです。にはAndroid 12以上、iOS 17以上というアプリ要件が示されていますが、これは組み込む各APIやモデルの本番保証を意味しません。Galleryで試し、対象端末のベンチマークを取り、その後に自社アプリへ最小構成で組み込む段階的な進め方が適切です。
採用判断:通信不能が要件なら価値は大きい
地下、海外、工場、現場作業、ウェアラブルなど、通信不能でも応答を続ける必要があるアプリでは、端末内ASR・TTSの価値は大きいです。音声をクラウドへ送らずに処理できるため、通信遅延とAPI呼び出し回数も抑えられます。一方、幅広い端末で均一な品質を求める場合、クラウド音声APIの方が運用しやすいことがあります。端末内とクラウドを二者択一にせず、端末能力、通信状態、利用者の選択に応じて切り替える構成も検討できます。
既にオンデバイス検索を検討している場合は、EmbeddingGemma 2でマルチモーダル検索を構成する際の判断も参考になります。音声応答の待ち時間やツール実行との調停を見直す場合は、音声AIで非同期ツールと結果通知を設計する方法も併せて確認してください。