目次
は2026年11月5日、Amazon S3のデータを既存のDynamoDBテーブルへ書き込む「bulk put items」の一般提供を発表しました。商品カタログの定期更新や大量データの移行を担当するチームは、自前の書き込み処理を運用する代わりに、非同期ジョブとして取り込めます。採用前に決めたいのは、処理速度だけでなく、同じキーへの更新条件と途中停止後の照合方法です。 AWSの一般提供発表
本稿は11月16日時点の公式資料に基づく導入・運用の解説です。通常のが商品を更新している最中に、S3のファイルから一括投入する場面を想定します。掲載コードは未実行の説明例で、バケット、権限、テーブル、入力データを自分のへ置き換える必要があります。
スポンサーリンク
新しいテーブルの作成と既存テーブルへの投入を分ける
DynamoDB公式の動作説明では、従来のImport from Amazon S3は新規テーブルを作成し、bulk put itemsは既存テーブルに書き込むと区別しています。投入した項目は書き込まれた時点から読めます。一つのファイルを渡すことが、全件を同時に切り替える境界になるわけではありません。旧版と新版が混在する途中状態を読者向け画面や集計が許容するか、先に決めます。
AWSは、bulk put itemsがテーブルの読み書き容量を消費しない別経路を使うと説明しています。ただし、これをアプリ全体に影響がないという保証へ広げないでください。大量更新を受け取る後続処理や、更新途中のデータを読む業務の判断は残ります。少量のデータを秒単位で反映したい用途には、起動準備のある非同期ジョブより、通常のPutItemやBatchWriteItemを検討します。
入力ファイルの全レコードに書き込み条件を付ける
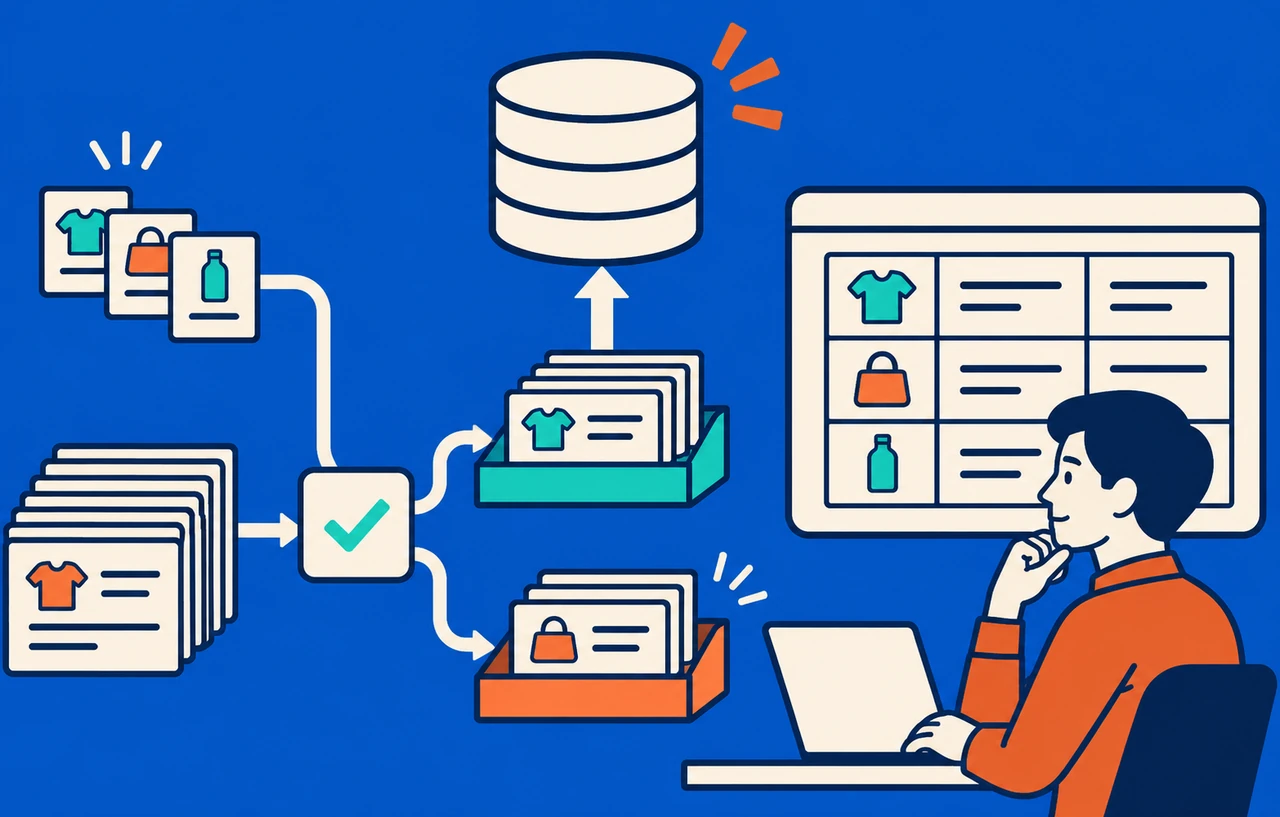
入力はDynamoDB またはAmazon Ionで、DynamoDB JSONは一行につき一つのレコードです。通常のJSON配列をそのまま渡す形式ではありません。公式の入力形式と条件式では、条件を省いた行は同じ主キーの既存項目を無条件で上書きすると説明しています。挿入だけにしたいなら、すべての行に主キーの存在を確認する条件を持たせます。
次は文字列のパーティションキーidだけを持つ検証テーブル向けの一行例です。新しい項目を入れるか、既存のversionが入力の12より小さいときだけ置き換えます。versionはアプリ側でも同じ規則で増やす数値とし、nameなど必要な属性を含む完全な項目を生成する前提です。
{"Item":{"id":{"S":"product-001"},"name":{"S":"Desk"},"version":{"N":"12"}},"ConditionExpression":"attribute_not_exists(id) OR #v < :new","ExpressionAttributeNames":{"#v":"version"},"ExpressionAttributeValues":{":new":{"N":"12"}}}既存項目のversionが13ならこの行はスキップされ、12でも再投入では置き換えません。既存項目にversionがない場合は、上の例では新規項目とは判定されないため、移行規則を別に決めます。時刻を版の代わりに使うなら、生成元ごとの時計のずれや同値の扱いまで設計してください。数値を付けただけで、どの更新が新しいかは決まりません。
PutItemの公式APIは、同じ主キーへのputが項目全体の置き換えになると説明しています。bulk put itemsの入力にも、部分更新のつもりで追加属性だけを載せないことが大切です。本記事では、既存項目に別属性を置いた試験を行い、取り込み後に必要な属性が残るかを確かめることを提案します。アプリと一括処理で同じ項目の所有範囲が曖昧なら、まずデータ生成方法を見直します。
スポンサーリンク
開始要求の再送とファイルの再投入を区別する
StartBulkPutItemsのAPI仕様では、同じClientTokenと同じパラメーターを8時間以内に再送すると、同じ操作を返します。通信が途切れた直後に別トークンで開始し直すと、要求の重複防止を失います。一方、翌日に同じ入力を意図的に再投入する操作は別ジョブであり、データを守るのは各行の条件です。開始要求の冪等性と、項目の更新規則を別に用意します。
次は対象とを設定し、対応するAWS を導入した後の開始例です。入力用と結果用のバケットは実在する検証用バケットに置き換え、実行ごとに専用の入力プレフィックスを作ります。同じ開始要求を再試行するときは、トークンと入力設定を維持します。
aws dynamodb start-bulk-put-items \
  --table-name CatalogTest \
  --input-s3-configuration '{"S3Bucket":"example-bulk-input","S3KeyPrefix":"run-001/","InputFormat":"DYNAMODB_JSON","InputCompressionType":"NONE"}' \
  --output-s3-configuration '{"S3Bucket":"example-bulk-report","S3KeyPrefix":"run-001/","OutputType":["ERROR","CONDITION_CHECK_FAILURE"]}' \
  --performance-tier STANDARD \
--client-token catalog-run-001公式の実行手順に従い、応答のBulkOperationArnを保存してDescribeBulkOperationで追跡します。ARNが返った時点を取り込み完了にしません。CLIにコマンドが見つからない場合はローカルの導入版、権限エラーなら利用中のを確認し、構文エラーと実行中ジョブの障害を分けて記録します。
完了状態だけでなくレポートと未処理範囲を照合する
公式の出力と照合手順では、ProcessedItemCountは読み取ったレコード数であり、書けた項目数ではありません。条件不一致はFailedItemCountに含まれず、COMPLETEDでもスキップがあり得ます。そこで例ではERRORとCONDITION_CHECK_FAILUREの両方を要求しています。入力件数から失敗件数を引いただけで、成功件数を報告しないようにします。
COMPLETED_WITH_ERRORSならERRORの対象を調べ、入力を直した再投入ファイルを作ります。条件不一致は単なる入力不良とは区別し、既存データの版が新しいために守られたのか、条件の設計が誤っていたのかを判断します。レポートには既存項目のoldImageが含まれるため、結果ファイルを誰が読めるかも確認します。
キャンセルしても、すでに書き込んだ項目は戻りません。CANCELLING中に結論を出さず、最終状態になってから、完了マニフェストのfileProcessingStatusとprocessedRangesを確認します。未処理範囲と修正したエラー行を次の入力へ分ける運用にすれば、全ファイルの再送に頼らず復旧できます。FAILEDも未書き込みを意味するとは限りません。結果出力の失敗がないか、FailureCodeとメッセージを読みます。
スポンサーリンク
テーブルの容量と後続処理の容量を別に見積もる
公式の制約と機能間の関係によると、global tablesは対象外です。またbulk書き込みは通常のConsumedWriteCapacityUnitsに現れません。テーブルの容量メトリクスだけを監視してもジョブの失敗を検知できないため、操作の状態と結果ファイルをジョブ管理側へ組み込みます。開始、監視、キャンセル、結果の読み取りまで、同じ運用担当が必要な権限を持つか確認します。
公式のベストプラクティスでは、DynamoDB StreamsやKinesisのコンシューマーが大量更新に追従できるよう、MaxWriteRequestUnitsで投入速度を制限する方法を示しています。DynamoDB Streamsの保持は24時間です。レートを抑えすぎると取り込み自体がタイムアウトする可能性もあるため、後続処理が持続できる速さと完了期限の両方を測ります。
入力は近いサイズの複数オブジェクトへ分け、特定のパーティションキーに偏らせない構成を検討します。取り込み中のS3オブジェクトは変更せず、訂正分は次の実行用に分けます。大きなファイルを後から差し替えて帳尻を合わせる運用では、どの版を読んだかの照合が難しくなります。
小さな検証で再投入まで確かめてから定期化する
公式の性能階層では、既定のStandardは完了時刻に余裕がある用途、Acceleratedは期限を重視する用途に位置付けています。Standardは全商用リージョンとGovCloudで提供され、Acceleratedの対応表には東京もあります。公式の時間目安にはテーブル規模、キー分散、インデックス、入力分割などの前提があるため、自社の完了時間として採用せず、同じ形のデータで確認します。
検証には新規キー、古い版、同じ版、新しい版、不正な行を用意します。本記事の提案として、投入前後の項目、条件スキップの理由、エラー修正後の結果を対応付けて残してください。途中キャンセルからの再開も試し、アプリが同時に更新した新しい版を再投入で戻さないことを確かめます。
定期実行へ進む条件は、ジョブの終了だけでなく、意図したスキップとエラーを説明でき、次に処理すべき範囲を特定できることです。大量データを運ぶ部分をサービスへ任せても、更新の優先順位と復旧時の判断はアプリ側に残ります。この二つを先に固めれば、カタログ更新や移行の手順を再現可能な形へ整理できます。
関連記事
Laravelのジョブ投入とDB確定の順序を制御するでは、非同期処理で「投入済み」と「完了」を分ける設計を扱っています。Laravel固有の解説で、DynamoDBの一括投入手順とは異なりますが、後続処理と再実行の境界を整理する際に役立ちます。
参考資料
AWS:bulk put items一般提供の発表
DynamoDB:Working with bulk put items
DynamoDB:入力形式と項目ごとの条件式
DynamoDB API:PutItem
DynamoDB API:StartBulkPutItems
DynamoDB:ジョブの開始・監視・キャンセル
DynamoDB:出力と結果照合
DynamoDB:制約・権限・他機能との関係
DynamoDB:bulk put itemsのベストプラクティス
DynamoDB:性能階層と対応リージョン