目次
Googleは2026年11月3日、の費用を「100万トークン当たりの単価」ではなく「正しく完了した1タスク当たりの費用」で評価する実装例を公開しました。短い確認まで高い思考レベルへ送る構成では、、再試行、内部思考が重なり、モデル単価を下げても実行全体の請求は増えます。対象はGeminiを使うコーディングエージェントや定型処理です。まずGemini 3.8 Flashの思考レベルをlowにして基準を作り、それでも費用や待ち時間が問題になる短い独立タスクだけ、軽量分類器でFlash-LiteとFlashへ振り分けます。
この記事は最新ニュースと実装判断の解説です。Google Developers Blogの50問ベンチマーク、Geminiの思考設定、コンテキスト、推論ログを2026年11月4日に確認しました。Google自身も、掲載例のJevを提供するTypeSafeと提携関係になく、特定製品の推奨ではないと明記しています。重要なのは分類器名ではなく、安い経路で成功できる処理を見分け、失敗を含む総費用で比較する設計です。
スポンサーリンク
先に「成功タスク単価」を定義する
入力・出力トークンの単価だけでは、エージェントの経済性を比較できません。ひとつの依頼が完了するまでに、モデルが何度も計画し、ツールを呼び、結果を検証し、失敗時にやり直すからです。月間費用を成功件数で割るだけでも出発点になりますが、本番ではタスク種別と難易度を分けます。
| 記録する値 | 見る理由 | 注意点 |
|---|---|---|
| 成功・失敗・人手差し戻し | 安い誤答を「節約」に数えない | 200を成功条件にしない |
| 入力・出力・思考・キャッシュ済みトークン | どこで費用が増えたか分ける | キャッシュ済み分を二重加算しない |
| モデル呼び出し、ツール呼び出し、再試行 | ループの長期化を検出する | 分類器の呼び出しも含める |
| エンドツーエンドの待ち時間 | 安くても遅い経路を見分ける | 分類器だけの時間で評価しない |
たとえば100件へ10ドルを使い、90件が自動検証を通った構成の成功タスク単価は約0.111ドルです。8ドルへ下げても70件しか通らなければ約0.114ドルとなり、請求総額は下がっても成果当たりでは悪化します。さらに人が修正した時間まで含めると差は広がります。成功条件は、コードならテスト合格、抽出なら必須項目と型の一致、ツール実行なら期待した状態変化など、用途ごとに機械判定できる形へ寄せます。
最初の最適化はルーター追加ではない
Googleの実験では、Gemini 3.8 Flashをlow thinkingで使う構成が、ルーターを持たない比較対象として50問すべてに正解しました。したがって、最初から分類、、複数モデルの監視を追加するより、同じモデルの思考レベルを下げて評価する方が単純です。3.8 Flashの既定はmediumで、low、medium、highを選べます。3.8 Flashではminimalは未対応です。
maxOutputTokensを小さくする方法は代用になりません。公式実験では、上限を300にした構成と4096にした構成で、簡単な27問の思考トークンはほぼ同じでした。上限は思考量の設定ではなく、思考と最終回答を合わせた生成の強制終了点です。難しい25問では300トークン上限によって7問が壊れ、6問は推論中に出力余地を失い、1問は誤答しました。費用を下げたいなら出力を途中で切るのではなく、thinking_levelを明示して比較します。
// Google Gen AI SDKを包むアプリ側の設定例
const baseline = {
  model: "gemini-3.8-flash",
  thinkingConfig: { thinkingLevel: "LOW" },
};

// maxOutputTokensは必要な回答長から決める。
// 費用調整のつまみとして極端に下げない。
既存のGemini 2.5系を使っている場合は、12月1日の移行と設定差も先に処理してください。対象モデルと破壊的変更はGemini 2.5 Pro・Flashの移行手順で整理しています。モデル移行とルーター導入を同時に行うと、品質変化の原因を切り分けにくくなります。
スポンサーリンク
分類器は一つの曖昧な質問をさせない
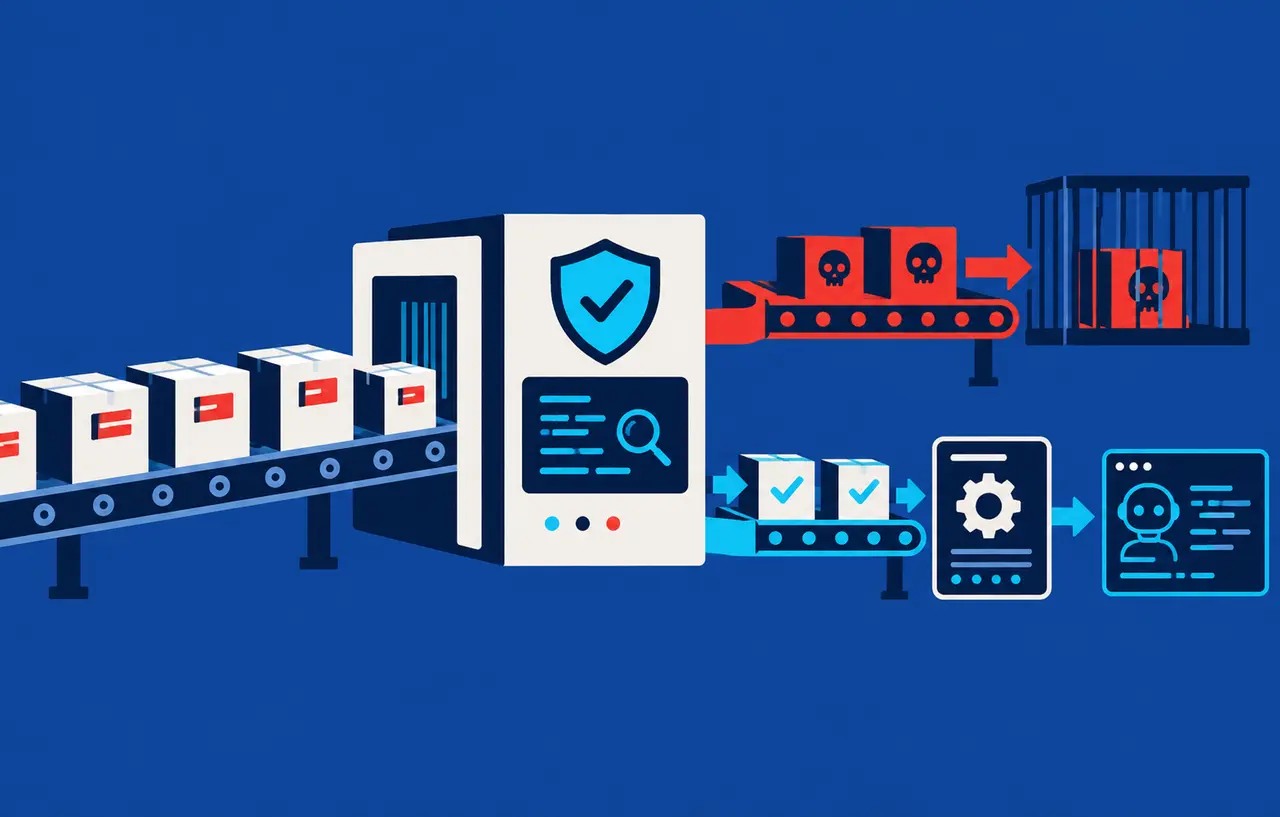
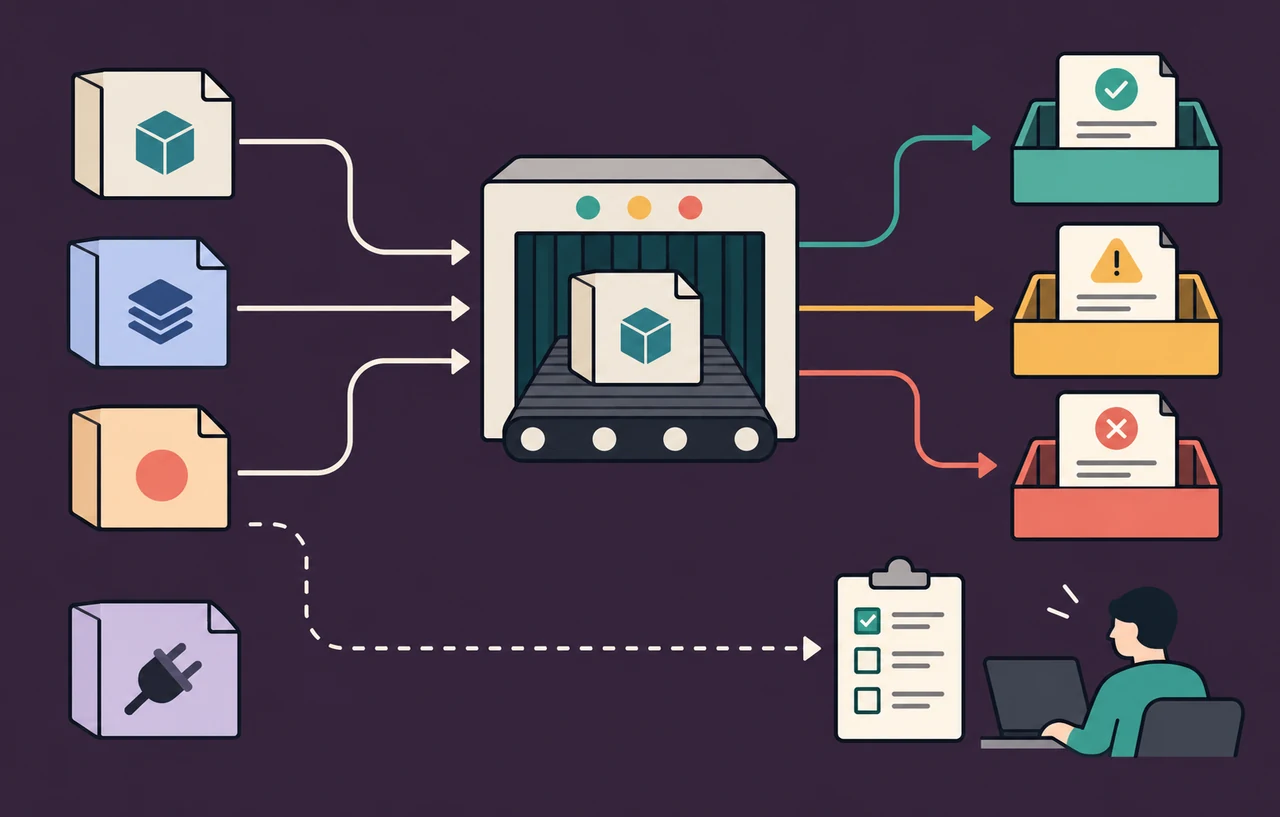
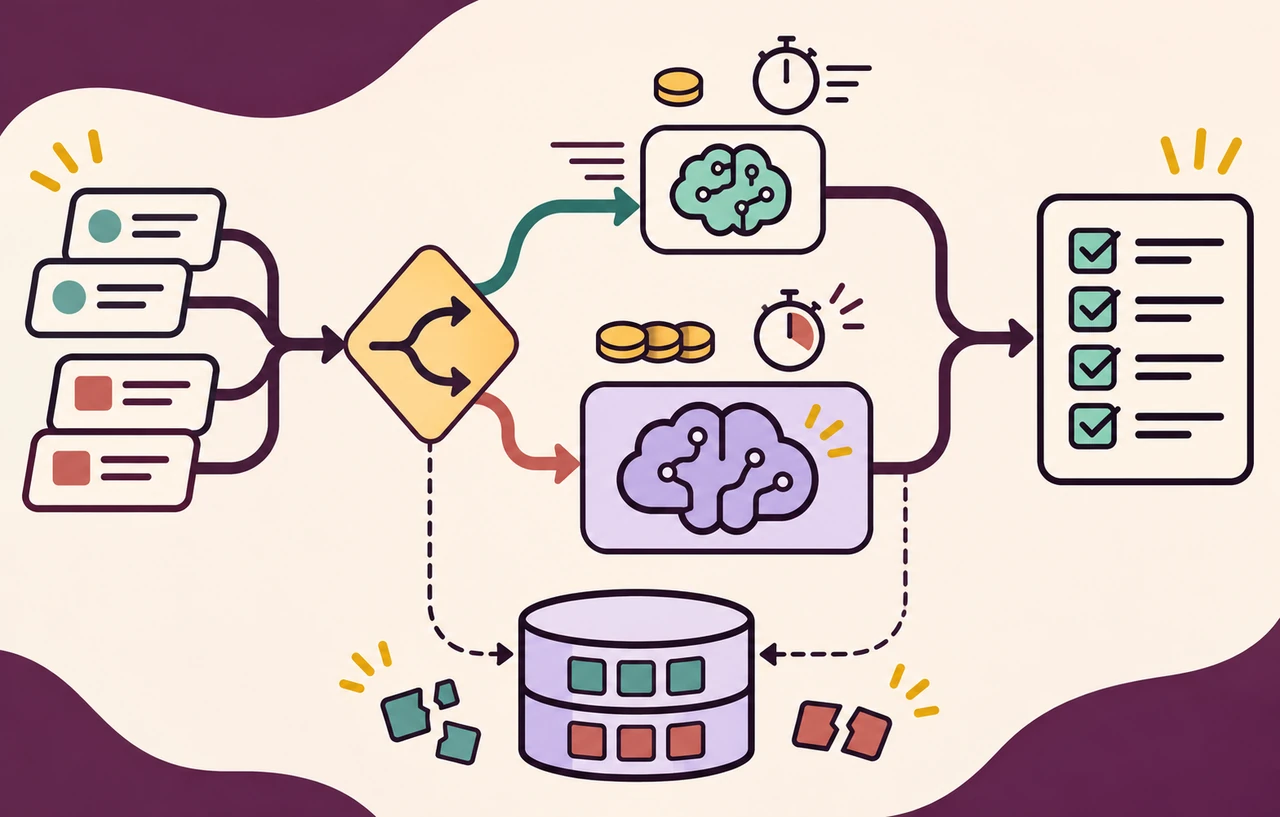
low thinkingでも短い定型処理が大量にある場合、次に検討するのが軽量分類器です。Googleの例は、単純な処理をGemini 3.5 Flash-Liteへ送り、複数段の計算や論理判断が必要な処理だけ3.8 Flash lowへ昇格させます。ただし「簡単か複雑か」と広く尋ねる分類は安定しません。実験では、複数要因を一度に判定させず、「回答に複数の連続した計算、シミュレーション、論理推論が必要か」のような原子的な二値質問へ分解すると分離が改善しました。
文字数とキーワードだけの規則も、開発時のサンプルには合わせやすい一方、未知の入力で崩れます。公式実験のヒューリスティックは作成に使った16問で15問、93.8%一致しましたが、固定後に追加した34問では70.6%へ低下しました。長いKubernetes YAMLからポートを抜くだけの処理を難しいと誤判定し、短いコードでも複数段の状態追跡が必要な問題を簡単と誤判定したためです。対してJevは未知の34問すべてで手動ラベルと一致し、全50問では48問、96%の一致でした。
async function runTask(task: Task) {
  const p = await classifyMultiStep(task); // 0〜1の確率を返す自前アダプター
  const route = p >= ROUTE_THRESHOLD ? "flash-low" : "flash-lite";

  const result = await generate(task, route);
  const verified = await verify(task, result);

  record({ route, p, verified, usage: result.usage, latencyMs: result.latencyMs });
  return { result, verified };
}この例のclassifyMultiStep、generate、verifyは製品固有APIではなく、アプリ側の責務を示すアダプターです。しきい値は0.5で固定せず、難しい処理を安い経路へ誤送信する損失と、簡単な処理を高い経路へ送る費用を評価データで比較して決めます。分類不能やタイムアウト時の既定経路、分類器の版、判定確率もログへ残します。
50問の結果をそのまま本番へ移さない
公式ベンチマークではFlash-Lite単体が簡単な25問をすべて約0.5秒で処理した一方、難しい25問のうち6問に失敗しました。Jevはその6問を高い確信度で複雑と判定してFlash lowへ昇格させ、50問すべてに正解しました。キーワード規則のルーターは難しい5問をFlash-Liteへ送り、2問に失敗して48問正解でした。安く見えたのは誤答を費用の分母から落としていたためです。
ただしこれは各構成1回、手動で難易度を付けた50問、簡単な自動採点による実験です。も短く独立しており、差額より待ち時間短縮の効果が目立つ条件でした。自社のタスクでは、実データから個人情報を除去した評価セットを作り、単純・複雑だけでなく、抽出、形式検証、コード確認、状態追跡、ツール利用などに分けます。日々の品質比較にはAQuAを使った本番エージェントの継続評価も参考になります。
スポンサーリンク
長いコンテキストではキャッシュを優先する
ルーティングとコンテキストキャッシュは常に相乗効果を持つわけではありません。の地図、ツール定義、長い手順を毎ターン送るエージェントでは、同じ接頭辞を同じモデルへ繰り返すことでキャッシュが効きます。Gemini 3.8 Flashの暗黙キャッシュは4,096入力トークン以上が目安で、応答のusage.total_cached_tokensからヒット量を確認できます。
モデルをFlash-LiteとFlashの間で頻繁に切り替えると、モデルごとにキャッシュを持つか、割引を失う可能性があります。短いログ解析、確認、単発の分類はルーターへ向きます。大きな共通コンテキストを伴う長い会話やコードベース作業は、一つのモデルと設定へ固定してキャッシュヒット率を保つ方がよい場合があります。ルーティング前後でcached_tokens / input_tokensを比較し、分類器の節約額よりキャッシュ損失が大きくないか確認します。
導入は4段階で止められるようにする
- 基準を固定する:現在のモデル、思考レベル、プロンプト、成功条件で費用・品質・待ち時間を記録します。
- low thinkingを比較する:同じモデルの設定だけ変え、成功率が許容範囲なら先に採用します。
- 影のルーティングを行う:分類結果だけを記録し、本番の回答経路は変えず、誤送信率と想定費用を測ります。
- 限定的に切り替える:短い独立タスクから開始し、失敗率、昇格率、キャッシュヒット、成功タスク単価に上限を設けます。
Google Cloudの推論メタデータログでは、モデル、入力・出力・キャッシュ・思考トークン、待ち時間、エラー、任意ラベルをCloud Loggingへ記録できます。タスク種別、ルーター版、選択経路をラベルにすれば、どの処理が費用を押し上げたか追跡できます。プロンプトや応答本文を保存しなくても集計できますが、バッチ推論や自己管理モデルなど未対応の経路があるため、アプリ側の実行IDと検証結果を結合できるようにします。
完了条件は「安いモデルへの送信率が上がった」ではありません。品質下限を満たしたうえで、成功タスク単価とp95待ち時間が改善し、キャッシュヒット率や再試行回数が悪化していない状態です。まずFlash lowだけで十分か確かめ、必要な区間だけ分類器を追加する順序なら、複雑なルーティング基盤そのものが新しい費用と障害原因になるのを避けられます。