目次
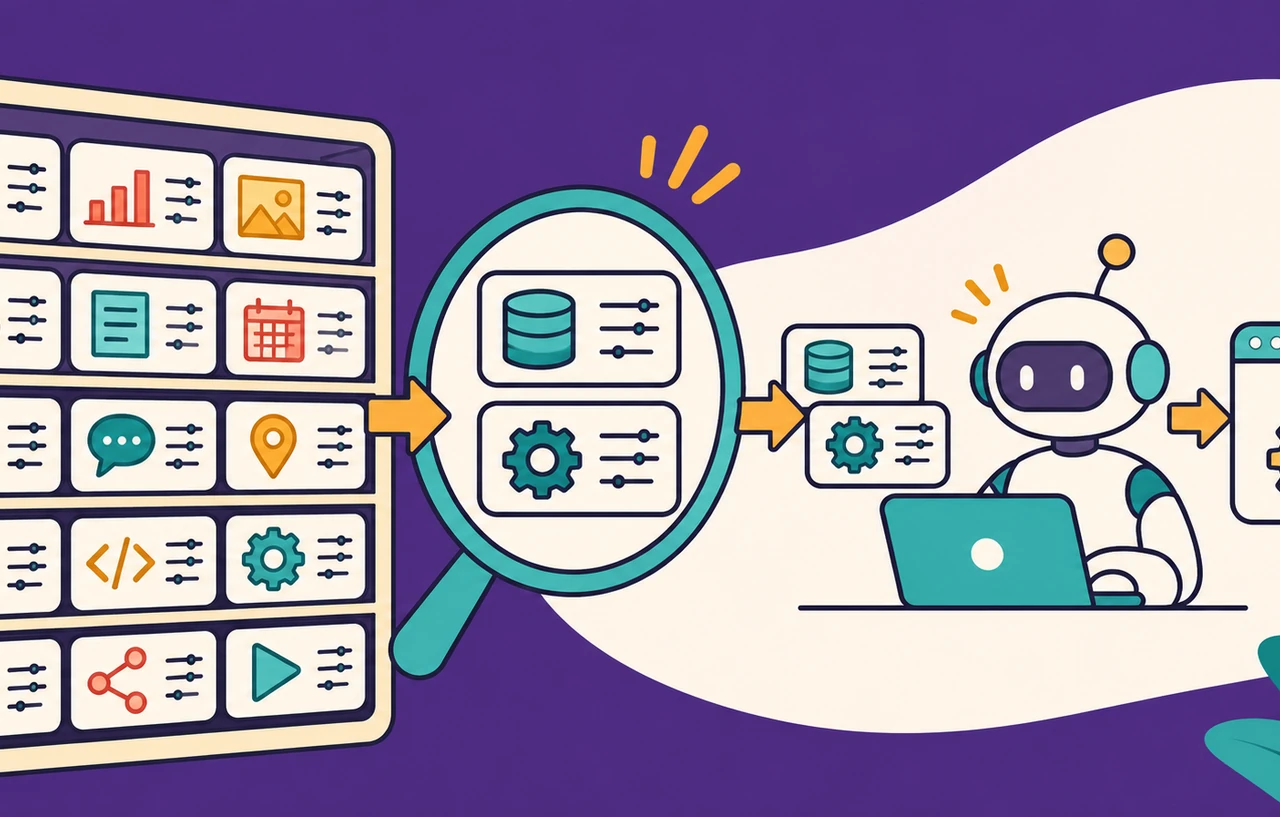
Googleは2026年11月19日、Gemini のInteractions APIに「Tool Retrieval」をプレビューとして追加しました。多数の関数やサーバーを接続するエージェントで、すべてのパラメーターを最初からコンテキストへ入れず、必要になったツールだけを検索して読み込む機能です。対象はGemini 3.6以降(Gemini 4を含む)で、現時点ではv1betaのInteractions APIを使います。generateContentでは利用できません。
ツールが数個なら、従来どおり全定義を渡す構成の方が単純です。Tool Retrievalが効くのは、数十から数百のツールがあり、問い合わせごとに実際に使うものが少ない場合です。入力トークンと候補数を抑える余地はありますが、設定するだけで費用や精度が必ず改善するわけではありません。本稿では、サーバー側とクライアント側の選び方、実装時の注意点、導入効果を評価する手順を整理します。
スポンサーリンク
Tool Retrievalが変えるのはスキーマの読み込み方
通常のでは、モデルへツール名、説明、引数の型、必須項目などを含む定義を渡します。定義が増えるほど、実行前に読む入力も増えます。Googleの公式ドキュメントは、数十の関数宣言だけで毎回数万トークンを消費し得ること、候補が増えるとツール選択の精度も下がり得ることを、Tool Retrievalを使う理由として挙げています。
Tool Retrievalでは、遅延対象のツールについて名前と説明だけを初期コンテキストへ残し、完全なパラメータースキーマを保留します。モデルが必要なツールを見つけると、tool_search_call、tool_search_result、実際のfunction_callという順に進みます。サーバー側検索では最初の二段階が一つのAPIリクエスト内で処理されます。アプリケーションは最終的な関数呼び出しを実行し、通常どおりfunction_resultを返します。
関数そのものの実行責任がGoogleへ移る機能ではありません。自前関数の、入力検証、再試行、結果の保存は引き続きアプリ側の仕事です。減らせる可能性があるのは、使わないスキーマを毎回モデルへ読ませる量と、候補過多による選択の迷いです。
サーバー側検索は大きく固定されたツール群に向く
サーバー側検索を有効にするには、tools配列へ{"type":"tool_search"}を追加し、保留したいfunctionまたはmcp_serverへdefer_loading: trueを設定します。モデルには各ツールの名前と説明が見えますが、引数スキーマは選ばれるまで読み込まれません。頻繁に使う少数のツールは遅延させず、利用頻度の低い長い尾だけを遅延させる構成も可能です。
const tools = [
  { type: "tool_search" },
  {
    type: "function",
    name: "get_order_status",
    description: "注文番号から配送状況を取得する",
    defer_loading: true,
    parameters: {
      type: "object",
      properties: { order_id: { type: "string" } },
      required: ["order_id"]
    }
  }
];

const interaction = await ai.interactions.create({
  model: "gemini-4-hydrogen",
  input: "注文A-1042の配送状況を確認して",
  tools
});この方式は、宣言するツール集合が比較的固定され、追加の検索基盤を運用したくない場合に合います。Googleは大きいが固定されたライブラリーを主な用途として示しています。リモートMCPサーバーにもdefer_loadingを付けられ、そのサーバーが公開するツールを必要時に読み込めます。複数のMCPサーバーを接続し、一つのサーバーが多数のツールを持つ構成では、初期スキーマ量を抑えやすくなります。
スポンサーリンク
クライアント側検索は権限や利用者ごとに候補が変わる場合に使う
クライアント側検索では、tool_searchにexecution: "client"を設定し、検索関数の名前、説明、引数スキーマを定義します。モデルが検索関数を呼んだら、アプリが独自のレジストリーや索引を検索し、候補となる完全なツール定義をfunction_resultで返します。ツールを最初から宣言しておく必要がないため、会話の途中で連携先が追加された場合にも対応できます。
一方、検索ごとにアプリとの往復が一回増えます。検索結果の品質も自分たちで管理します。製品別、組織別、利用者別にツール集合を変える、社内レジストリーの権限フィルターを通す、名前だけでは見つからない業務語をベクトル検索する、といった要件がある場合に向きます。固定ツール群へ単純に導入するなら、まずサーバー側検索を比較対象にする方が実装は少なくなります。
| 方式 | 適した構成 | 追加実装 | 待ち時間 |
|---|---|---|---|
| 全スキーマを静的に渡す | 20個未満を目安にした安定したツール群 | 検索処理なし | 検索往復なし |
| サーバー側Tool Retrieval | 大きいが固定されたツール群、リモートMCP | tool_searchとdefer_loading | 検索は同一API呼び出し内 |
| クライアント側Tool Retrieval | 独自レジストリー、利用者別・権限別の候補 | 検索、順位付け、絞り込み | 検索ごとに追加往復 |
プレビュー導入で見落としやすい仕様
- Tool Retrievalはプレビューで、
v1betaが必要です。一般提供前にAPI表面が変わる可能性を見込み、呼び出し部分を分離します。 - 一つのリクエストで宣言できる
tool_searchは一つです。サーバー側とクライアント側を同時に混在させません。 defer_loadingはサーバー側検索用です。サーバー側tool_searchなしで付けると400エラーになります。- 複数ターンでは
previous_interaction_idを使っても、毎回同じ完全なtools配列を送ります。APIはツール宣言自体を次のリクエストへ引き継ぎません。 store=falseで履歴を自分で管理する場合、tool_search_callとtool_search_resultを署名を含めて改変せず再送します。- レスポンスは
statusだけで判断せず、steps内のfunction_callを確認します。
ツール説明は検索精度へ直接影響します。説明が「データを取得する」のように曖昧だと、名前が違う似たツールを区別しにくくなります。長い説明を初期コンテキストへ置きたくない場合、遅延する関数にはshort_descriptionも指定できます。短い説明には、対象、行為、主要な適用条件を含め、詳細は通常のdescriptionへ残します。
スポンサーリンク
料金は機能単価ではなく実際のトークン差で測る
Googleの発表では、Tool Retrievalそのものに別料金はありません。使用モデルの通常の入出力トークン料金が適用されます。ただし、tool_searchには小さな固定の入力が加わり、検索で読み込んだスキーマは、その後の会話で入力として課金されます。使わないスキーマを除ける量が、検索機構と実際に読み込むスキーマの量を上回る場合に節約できます。
導入判断では、ツール数だけを数えず、同じ評価データで静的方式と比較します。最低限、初回入力トークン、会話全体の入力トークン、P50・P95待ち時間、正しいツールを選んだ割合、不要な検索回数、関数引数の検証失敗率、タスク完了あたりの費用を記録します。よく使うツールまで遅延すると検索段階が増えるため、利用頻度上位は静的に残す組み合わせも比較します。
段階導入は観測できる小さなツール群から始める
- 現在のツール定義について、件数、スキーマのトークン量、利用頻度を集計します。
- 問い合わせと期待するツール、期待する引数、最終結果を組にした評価データを用意します。
- 利用頻度の低いツールだけを
defer_loadingへ移し、静的方式と同じ入力で比較します。 interaction.stepsを保存し、どの候補を検索し、どの関数を呼んだかを確認します。- 品質、待ち時間、総入力トークンの基準を満たした範囲から段階的に対象を広げます。
検索に失敗した場合の経路も決めます。候補が見つからなければ、問い合わせを言い換えて無制限に検索させるのではなく、利用者へ不足情報を尋ねる、静的に残した案内ツールへ切り替える、処理を終了して記録する、といった上限を設けます。クライアント側検索では、検索結果が空、複数候補が同点、レジストリーが一時的に応答しない場合をそれぞれテストします。
既存のツール呼び出し設計との関係
Tool Retrievalは、ツール呼び出しの代替ではなく、その前段で候補スキーマを選ぶ仕組みです。構造化出力と外部処理の責任分担から確認したい場合は、関連記事「構造化出力とツール呼び出しはどう違う?」が設計の入口になります。複数APIの結果をコード側で集計してモデルへ戻す量を減らしたい場合は、「Programmatic Tool Callingの実装判断」と目的を分けて検討してください。
大規模なツール群で最初に確認すべきなのは、検索機能を入れられるかではなく、現状のボトルネックが本当にスキーマ量と候補過多にあるかです。静的方式で品質も費用も基準内なら、プレビュー機能を急いで採用する必要はありません。入力トークン、待ち時間、誤選択が増えている場合に、サーバー側検索を小さく試し、独自のレジストリーが必要になった段階でクライアント側へ進む順序が現実的です。