目次
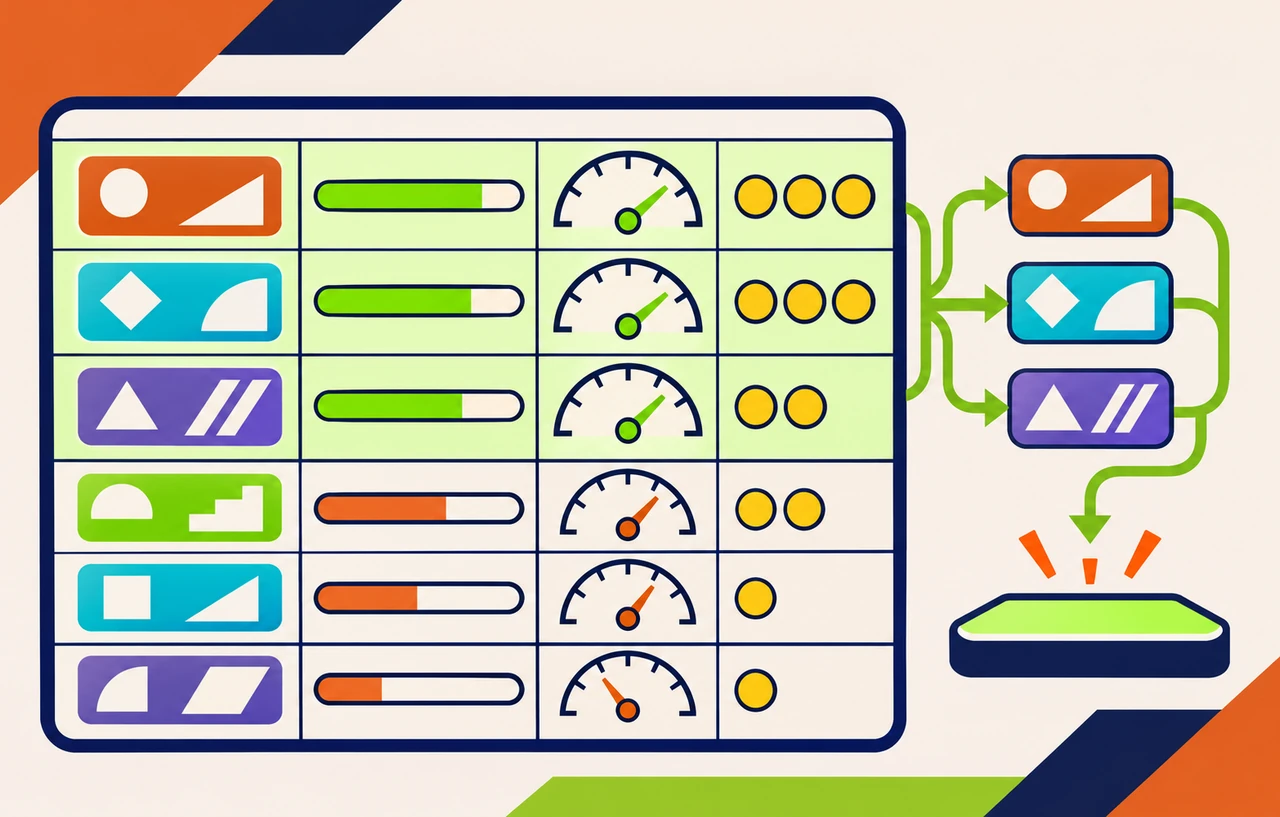
は2026年11月18日、Amazon SageMaker Studioに「JumpStart Model Leaderboard」を追加した。Amazon SageMaker JumpStartで利用できる70を超える基盤モデルを、品質・速度・コストの三つの軸で横並びにできる。モデル提供元が別々に公表したベンチマークを寄せ集めるのではなく、AWSが共通の評価設定と標準ワークロードで測定した値を確認できる点が新しい。モデル選定の初期調査を短くしたい開発チームは、候補を二、三個へ絞る入口として使える。
ただし、リーダーボードの首位をそのまま本番採用する機能ではない。一般ベンチマークは自社の入力、出力形式、、言語、待ち時間の上限を再現しないからだ。本稿では、新機能で比較できる値、その値を読む際の注意点、候補を実際のワークロードで検証して採否を決める手順を整理する。
スポンサーリンク
同じ測定方法で品質・速度・コストを比較する
AWSの発表によると、リーダーボードはSageMaker StudioのJumpStart base modelsページにある新しい表示で、Categories、All modelsと並んで利用できる。初期提供ではMeta、Google、Qwen、IBM、Arceeなどの70超のモデルを対象とし、今後さらに追加する予定だ。SageMaker Studioへのアクセスと、候補モデルをする権限が必要になる。
品質はBIG-Bench Hard、GPQA Diamond、MMLU-Proの三つの公開ベンチマークで示される。AWSがすべての対象モデルを同一の評価ハーネスと設定で測るため、提供元ごとにや採点条件が異なる公開値より比較しやすい。とはいえ三つは別の能力を測るため、異なるベンチマーク間の点数を直接比べるものではない。自社の用途に近い能力を示す列を選び、その列の中で候補を比較する。
速度とコストは、各JumpStartデプロイ構成へ標準化したテストワークロードを送ってAWSが測定する。ここで重要なのは、値がモデル名だけに結び付くのではなく、インスタンスや最適化目標を含むデプロイ構成に結び付くことだ。同じモデルでも、低コスト、低レイテンシ、高スループット、バランス重視の構成を変えれば、最初のトークンが届くまでの時間、生成速度、処理量、費用は変わる。
| 確認する軸 | リーダーボードで分かること | 本番前に追加で測ること |
|---|---|---|
| 品質 | 共通条件で測った一般的な推論・知識のスコア | 自社データでの正答率、形式遵守、業務上の失敗 |
| 速度 | 標準ワークロードと選択構成での応答性能 | 実際の入力長でのP50・P95、同時実行時の待ち時間 |
| コスト | 測定した構成を動かす場合の推定費用 | 再試行、長い出力、アイドル時間を含む成功タスク単価 |
| 適用条件 | 対応モデル、モダリティ、デプロイ構成 | 、クォータ、ライセンス、運用要件 |
最初に除外条件を決めてから順位を見る
比較を始める前に、入力と出力のモダリティ、ライセンス、利用可能なリージョン、必要なコンテキスト長、デプロイ可能なインスタンス、予算上限を要件として書き出す。利用できないモデルを高いスコアだけで候補に残すと、後の検証が無駄になる。JumpStartのモデルカードとJumpStartの公式ドキュメントで、モデルごとのデプロイ、カスタマイズ、評価への対応状況を確認する。
次に、業務で重視する品質を一つのベンチマークだけに置き換えない。たとえば、定型抽出では形式の遵守と必須項目の再現率、社内文書の回答では根拠との一致、コーディング支援ではテスト通過率と不要な変更の少なさが採否を左右する。一般スコアは大きく劣る候補を除く材料にし、順位が近い候補は同等として二、三個残す。AWSも小さなスコア差は実行ごとの変動に入る可能性があるため、明確な差を見るよう案内している。
推論モデルと非推論モデルの比較にも注意がいる。AWSの説明では両者に異なる生成パラメータを使い、推論モデルのGPQA Diamondは10回の結果を平均する。このため、両タイプをまたぐ順位は概算として読む。深い推論が不要な処理では、高スコアの推論モデルより、軽量モデルの方が待ち時間と成功タスク単価の条件を満たすことがある。
スポンサーリンク
候補を二、三個に絞って自社データで再評価する
候補を残したら、リーダーボードで比較したものと同じユースケースと最適化目標を選んでデプロイする。別の構成を使えば、表示された速度やコストを採用判断へ持ち込めない。比較条件はモデル名、モデル版、インスタンスタイプ、デプロイ構成、生成設定、測定日まで記録する。モデルの更新や構成変更後に再評価できる形にしておく。
- 実トラフィックから個人情報や機密を除いた代表例を、簡単・標準・難しいケースに分けて用意する。
- 全候補へ同じ入力、システム指示、生成設定、最大出力長を適用する。推論モデル固有の設定差がある場合は差分を記録する。
- 正答率だけでなく、形式遵守、根拠との一致、再試行回数、人手での修正量を採点する。
- 最初のトークンまでの時間、完了までの時間、スループットをP50とP95で記録する。
- 推論費用に再試行や失敗を加え、合格したタスク数で割った成功タスク単価を計算する。
- 品質の最低基準を満たした候補の中から、待ち時間と費用の上限を満たす最小構成を選ぶ。
標準ベンチマークをさらに実行したい場合は、JumpStartと統合されたSageMaker Clarify Foundation Model Evaluationsを使える。自動評価では正確性、意味的な頑健性、事実知識などを測り、人手評価も設定できる。ただし、評価ジョブには推論用と採点用のリソース、十分なクォータが必要だ。リーダーボードは候補発見、FMEvalや自社ハーネスは採用判定という役割に分けると整理しやすい。
費用はトークン単価ではなく成功タスク単価で判断する
表示された推定費用だけを比べると、安いが失敗の多いモデルを選ぶ恐れがある。モデル呼び出しの費用に、再試行、長い不要出力、タイムアウト、評価用の呼び出し、人手修正を加え、業務基準を満たした件数で割る。サイト内のGeminiエージェントの成功タスク単価を扱った解説でも、応答の成功ではなく業務完了を分母にする考え方を整理している。SageMakerでも同じ基準で比較すれば、リーダーボードのコスト列と実運用の差を説明しやすい。
オンラインならP95の待ち時間、夜間バッチなら時間当たりの処理量、常時稼働の小規模サービスならアイドル時間を含む月額が重要になる。目的が異なる構成を一つの順位へまとめず、用途ごとに品質の下限と性能・費用の上限を決める。複数用途を一つのモデルへ寄せる場合も、用途別の結果を合算する前に、失敗が集中するタスクを確認する。
スポンサーリンク
評価セットは本番の失敗パターンから作る
自社評価の件数を増やす前に、どの失敗を検出したいかを決める。代表的な正常系だけでは、モデル間の差が出にくい。曖昧な指示、長い参照文書、不要な情報を含む入力、回答不能な質問、厳密なJSON、複数回のツール利用など、現在の運用で人手修正や再試行が生じるケースを含める。難しい事例だけに偏ると通常業務の平均費用を誤るため、実トラフィックの構成比も記録する。
採点ルールは候補モデルの出力を見る前に固定する。完全一致で判定できる項目、許容範囲を持つ数値、レビュー担当者が判断する文章品質を分ける。文章を人が採点する場合はモデル名を隠し、正確性、完全性、簡潔さを別々に評価する。を採点役に使う場合も、少数の人手評価と突き合わせ、特定の文体や長い回答を過大評価していないか確認する。
入力長も本番分布に合わせる。短いプロンプトだけの比較では、長いコンテキストでの待ち時間や費用、重要情報の取りこぼしを見つけられない。短・中・長の区分ごとに品質とP95を集計し、モデル全体の平均値だけで判断しない。ストリーミングを使う画面では最初のトークンまでの時間と完了時間を分け、バックグラウンド処理では完了時間と時間当たり処理件数を重視する。
本番移行は同じ判定表で段階的に進める
採用候補が決まったら、まず再現可能なで既存モデルとの回帰比較を行う。次に、結果を利用者へ返さないシャドー実行が可能なら、実入力の分布で品質・待ち時間・費用を確認する。その後、対象を限定した小規模導入へ進める。各段階で品質の最低値、P95、失敗率、成功タスク単価の停止基準を同じ表に置き、いずれかを超えたら現行モデルへ戻せるようにする。
切り替え後も、リーダーボード上の順位ではなく自社指標を監視する。入力の種類や利用者が変われば、導入時の評価セットは古くなる。人手差し戻しが増えたケースを新しい回帰テストへ加え、モデル版やデプロイ構成を変えるたびに再実行する。これにより、新しい上位モデルの登場を移行理由にするのではなく、自社の品質・速度・費用が改善するかで更新を判断できる。
リーダーボードの限界と更新時の確認点
初期提供の品質スコアはLLMのテキスト生成が中心で、すべてのJumpStartモデルに値があるわけではない。スコアが空欄でも性能が低いとは限らず、まだ測定対象でない可能性がある。AWSは今後、テキスト埋め込み、画像理解、物体検出などのタスク別リーダーボードや、組織が承認モデルを集めるPrivate Hubへの対応を検討している。将来の予定は現時点の提供機能と分けて判断する。
モデルやデプロイ構成、料金、リージョンは更新される。採用時のスクリーンショットだけを残すのではなく、モデルIDと版、構成名、計測条件、評価データの版、合格基準を決定記録へ残す。新しいモデルが上位に現れたときも即座に置き換えず、現行モデルと同じ自社評価を通し、品質向上が移行・再検証の費用を上回るかを見る。
JumpStart Model Leaderboardの価値は、モデル選びを自動化することではなく、異なる提供元の候補を共通条件で絞り込めることにある。要件で除外し、同じデプロイ構成で比較し、自社データで品質・待ち時間・成功タスク単価を再計測する。この順序を守れば、一般ベンチマークの順位を過信せず、モデル選定の調査時間を短縮できる。