この記事のポイント
- 脆弱性
- CVE-2026-119208
CVE-2026-119209 - 深刻度
HIGH7.1
- 対象
- pypdf 6.21.3より前の版
- 悪用状況
- 不明
- 推奨対応
- 6.21.3以降へ更新し、追加修正を含む6.21.4も確認します。稼働ワーカーの版とロード先を確認し、PDFを開く段階から資源制限を適用し、復号後のページ数と異常終了を試験してください。
- 公表日
目次
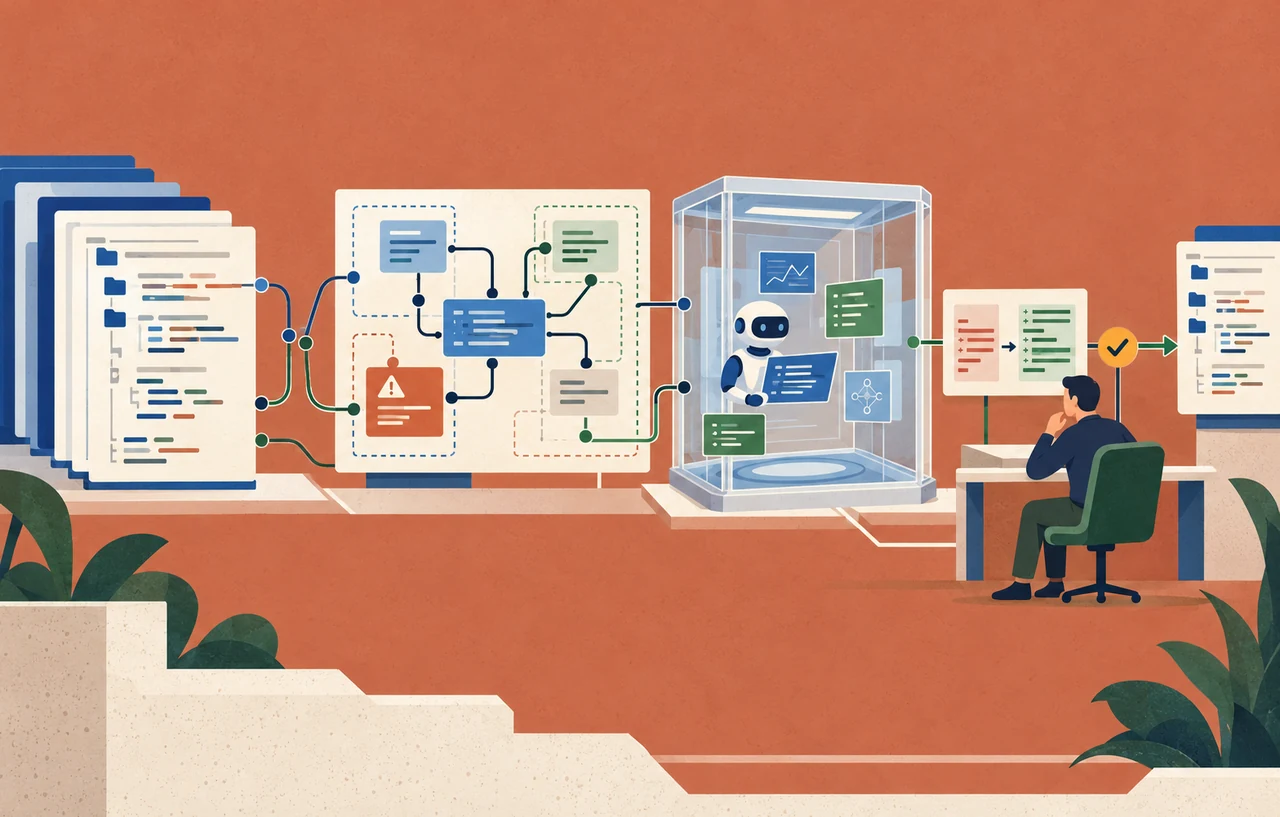
pypdfで利用者から受け取ったPDFのページ数を調べたり、本文を抽出したりしているサービスは、解析ワーカーの稼働版を確認してください。開発元は2026年10月27日に6.21.3を公開し、暗号化PDFの偽のページ数による長時間処理・大量メモリー使用と、相互参照ストリーム解析時の大量メモリー使用を修正しました。対象は6.21.3より前の版です。
割り当てられた番号は-2026-119208とCVE-2026-119209です。10月30日の確認時点では、さらに別のセキュリティ修正を含む6.21.4も公開されています。未更新なら6.21.3を最低ラインとし、互換性を確認したうえで6.21.4など修正を含む版へ進めます。アップロード容量やページ数の上限を設けていても、その判定自体で問題の処理が動く構成には注意が必要です。
スポンサーリンク
公表日と修正日を分けて捉える
pypdf公式:暗号化PDFのページ数に関する勧告とpypdf公式:相互参照ストリームに関する勧告はともに10月27日付で、pypdf 6.21.3リリースにも修正が掲載されています。一方、公式CVEレコードの公開日は10月29日です。CVEの新着日を、修正版が初めて出た日や攻撃開始日として扱わないでください。本稿は未掲載だった修正情報と、WebのPDF受付機能における点検手順を扱います。
開発元の勧告表示は2件ともModerateですが、公式CVEレコードのCNA評価は2件とも v4.0が7.1、Highです。本稿では主題のCVE-2026-119208のCNA値を代表値として示します。評価の違いを消して一律の開発元評価とせず、実際に外部PDFがどの処理へ届くかで対応優先度を決めます。確認した勧告に実環境での悪用報告はなく、悪用状況は不明です。
119208は復号後も宣言されたページ数を信用していた
PDFのページツリーにはページ数を表す/Countがあります。CVE-2026-119208では、暗号化されたPDFでページ数へアクセスする際、この値が偽装されていると、長い処理時間や大量のメモリー使用につながる可能性がありました。重要なのは、正しいパスワードで復号に成功しても、宣言値をそのまま使う経路が残っていたことです。
pypdf修正PR #4270は、get_num_pages()が/Encryptを持つ文書では復号後も生の/Countを返し、例えばpage_labelsの大きな割り当てにつながり得たと説明しています。修正後は復号済みの文書についてページツリーをたどって検証した数を使います。暗号化されていることと、現在も復号されていないことを同じ判定にしない修正です。
そのため、暗号化PDFを業務上受け付けるサービスでは、パスワード検証が成功した時点を安全確認の完了にできません。ページ数、ページラベル、サムネイル作成、抽出処理へ進む順序を追ってください。ページ上限をlen(reader.pages)などで判定する実装も、更新前はその呼び出しがどの内部処理を行うかを確認する必要があります。
スポンサーリンク
119209は開いた段階の相互参照解析が対象
CVE-2026-119209は、PDFを開いて相互参照ストリームを処理する際の大量メモリー使用です。相互参照情報は、文書内のオブジェクト位置などを解決するために使われます。高く圧縮されたストリームが非常に多くのエントリーを宣言し、/Prevによって複数のストリームが連なると、一つのストリームだけを制限しても文書全体の処理量が増えます。
pypdf修正PR #4269では、文書全体に対する相互参照ストリームのエントリー予算を加え、従来のストリーム単位の制限を回避できた負の/Index件数も扱い直す変更が説明されています。ここでは「ページが多いPDFだけを拒否する」という業務ルールより手前で、構造の解析に資源が使われます。暗号化PDFを受け付けない方針だけで、こちらの条件まで除外したとは判断できません。
2件を同じ原因とまとめないことが大切です。119208は文書のページ数取得、119209は相互参照ストリームを含む文書を開く処理が確認対象です。どちらも公表された影響は可用性であり、今回の資料からコード実行や情報流出まで発生すると拡張しません。
修正PRではPdfReaderにxref_stream_maximum_entriesを追加し、既定値を2,000,000としています。文書全体の累積値が上限を超えるとLimitReachedErrorを発生させます。負の/Index件数はstrictモードでは例外、それ以外では警告のうえ0として扱われます。この内部上限を業務上許すページ数と混同せず、制限到達を通常の完了として保存しないでください。
稼働ワーカーで版と呼び出し位置を確認する
依存ファイルの記述だけでなく、実際にPDFを処理する環境で版とロード先を記録します。Webアプリと非同期ワーカーが別の仮想環境・コンテナなら、それぞれ確認してください。次の例は版とモジュールの実体を表示する点検用で、PDFを開いたりを再現したりするものではありません。
python -c 'import pypdf; print(pypdf.__version__); print(pypdf.__file__)'
python -m pip show pypdfやとこの結果が異なるなら、起動するPython、作業ディレクトリー、イメージの時点を照合します。更新した成果物を配備しても、常駐ワーカーが古いモジュールをロード済みの場合は置き換えが必要です。再起動後に同じ確認を行い、Web受付、バッチ、再処理用のジョブ定義へが届いたことを残します。
ソースではPdfReaderの生成、decrypt、ページ数取得、page_labels、ページ反復、テキスト抽出の順に、外部ファイルが通る箇所を探します。特に「ページ数だけ確認する軽い前処理」を受付側で行い、重い解析だけを隔離している構成では、前処理が保護の外に残っていないかを確認します。
スポンサーリンク
ページ上限を調べる前から資源制限を適用する
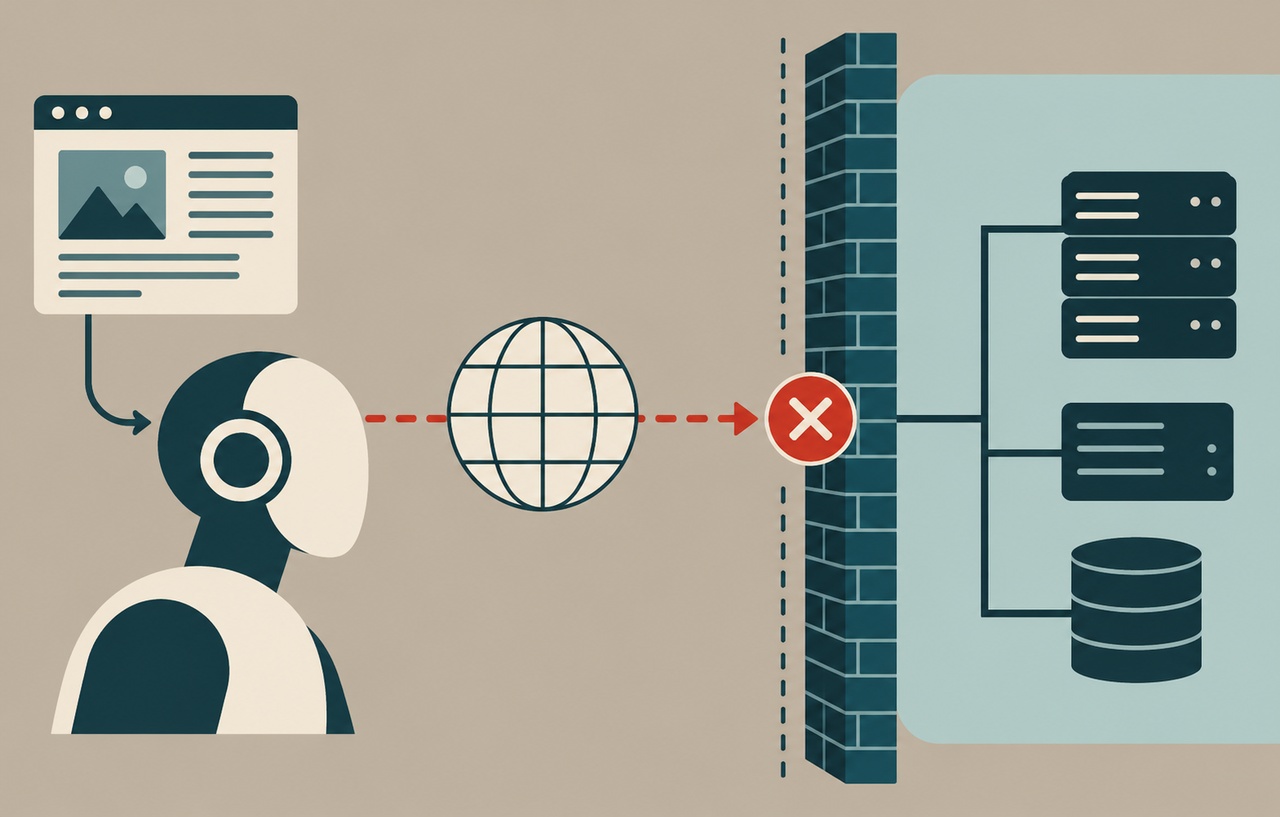
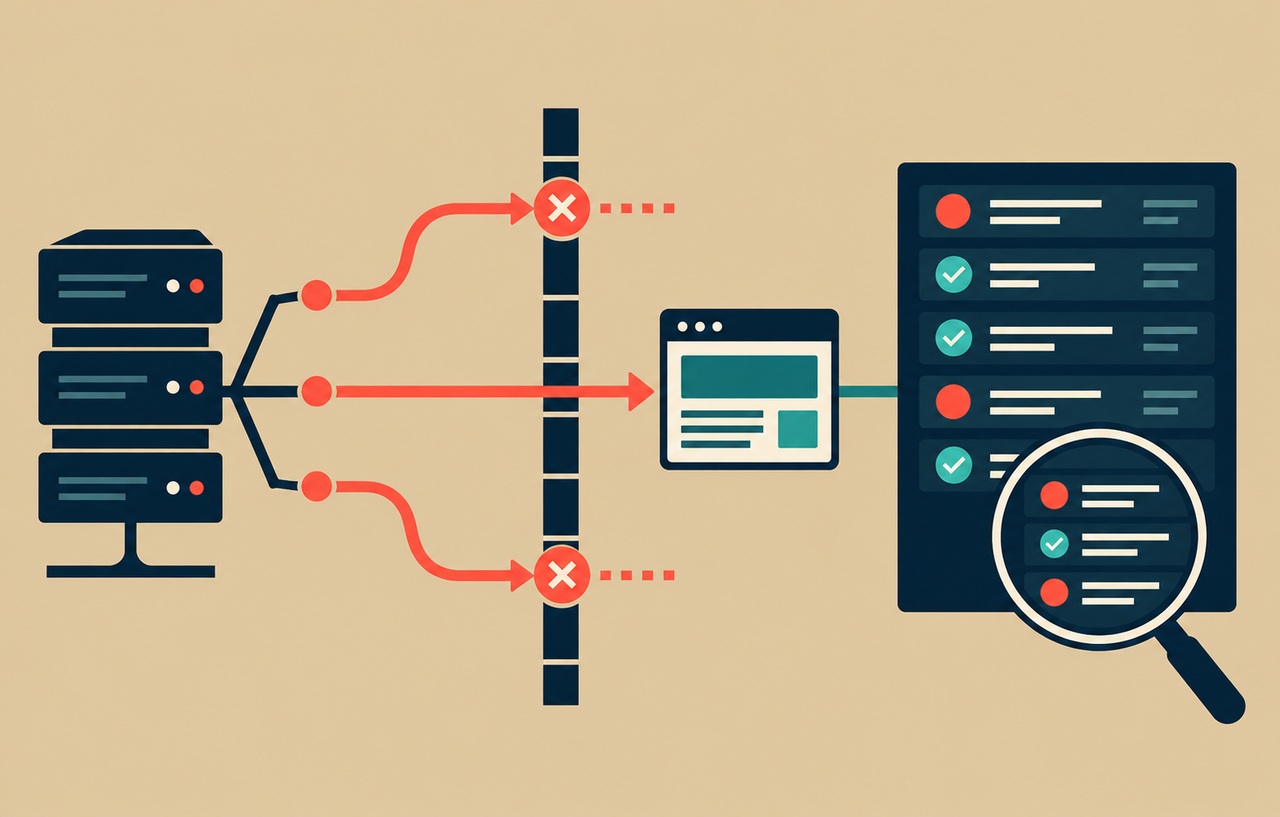
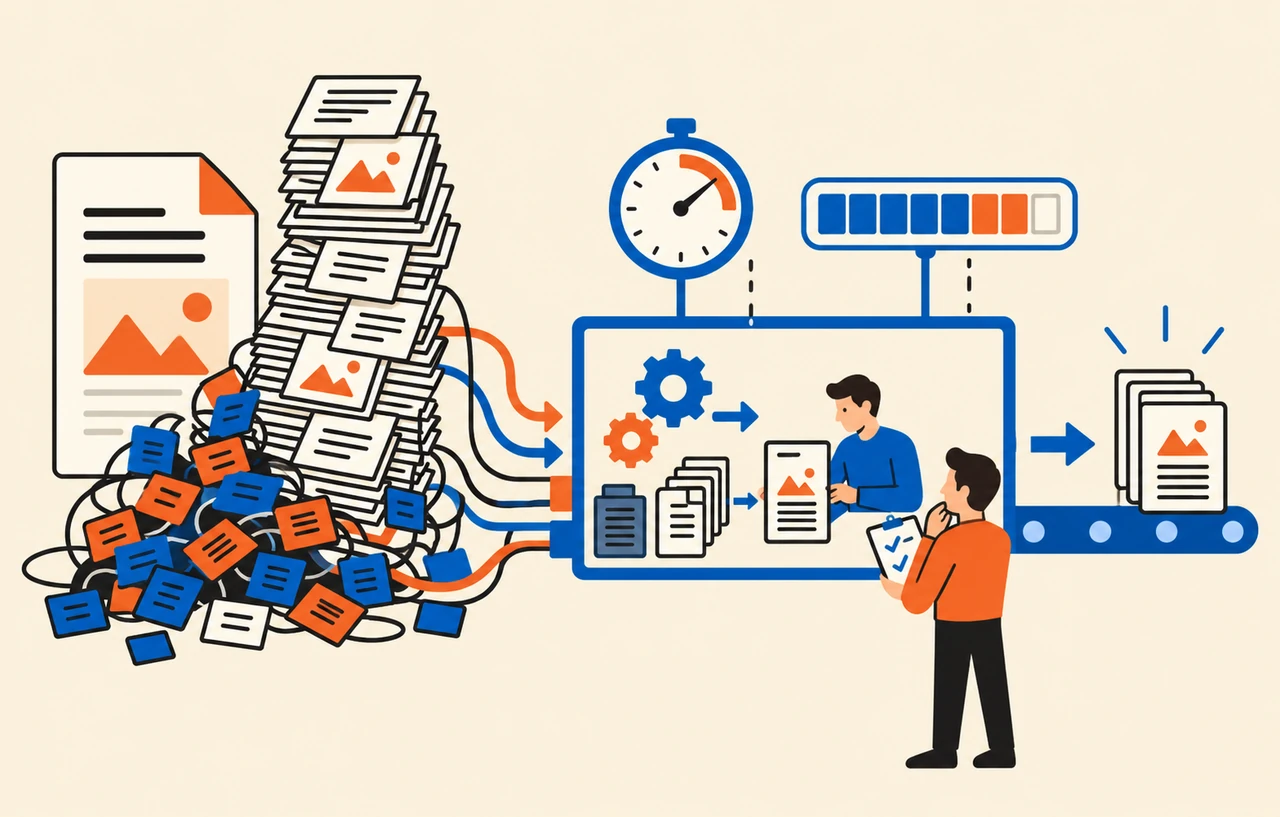
本サイトの提案は、PdfReaderで開く処理そのものを制限されたワーカーの内側へ入れることです。ページ数が判明してからメモリー制限をかけても、相互参照の解析で先に資源を使えば間に合いません。アップロードされたバイト数の制限と、展開・解析後の構造数や処理資源の制限を別々に設計します。
時間、メモリー、CPU、同時実行数の上限は、既知の正常な文書群を測って決めます。記事だけを根拠に一律の秒数やメモリー量を設定すると、業務で必要な図面や帳票まで落とす可能性があります。HTTPの応答タイムアウトとワーカー停止を連動させ、依頼元が切断した後も解析が残り続けないかを確認してください。
暗号化PDFが不要なら、受け付けない方針は入口を狭める選択肢になります。ただし、暗号化の検知自体にパーサーが必要な実装なら、その検知も制限内で実行します。また、この方針は相互参照ストリーム側の修正を代替しません。必要な形式を絞る判断と、ライブラリーの更新は別の作業です。
strict=Trueを今回の修正の代わりにしない
pypdf公式:strictの動作は、strict=Trueでは仕様に従わないPDFに例外を出し、strict=Falseでは警告を出しながら可能な範囲で処理を続けると説明しています。これは壊れた文書への寛容さを選ぶ設定です。開発元が今回の2件の代替策としてstrict=Trueを案内しているわけではなく、これを有効にしたから対象外とは判定できません。
更新を直ちに適用できない場合、各勧告は対応する修正PRの変更を取り込む案を挙げています。独自では両方の変更と関連テストを確認し、どの配布物へ適用したかを記録します。単に例外を握りつぶして処理を続けたり、失敗したファイルを別の無制限パーサーへ自動転送したりする方法は、更新の代わりになりません。
修正版で正常系と停止条件を確かめる
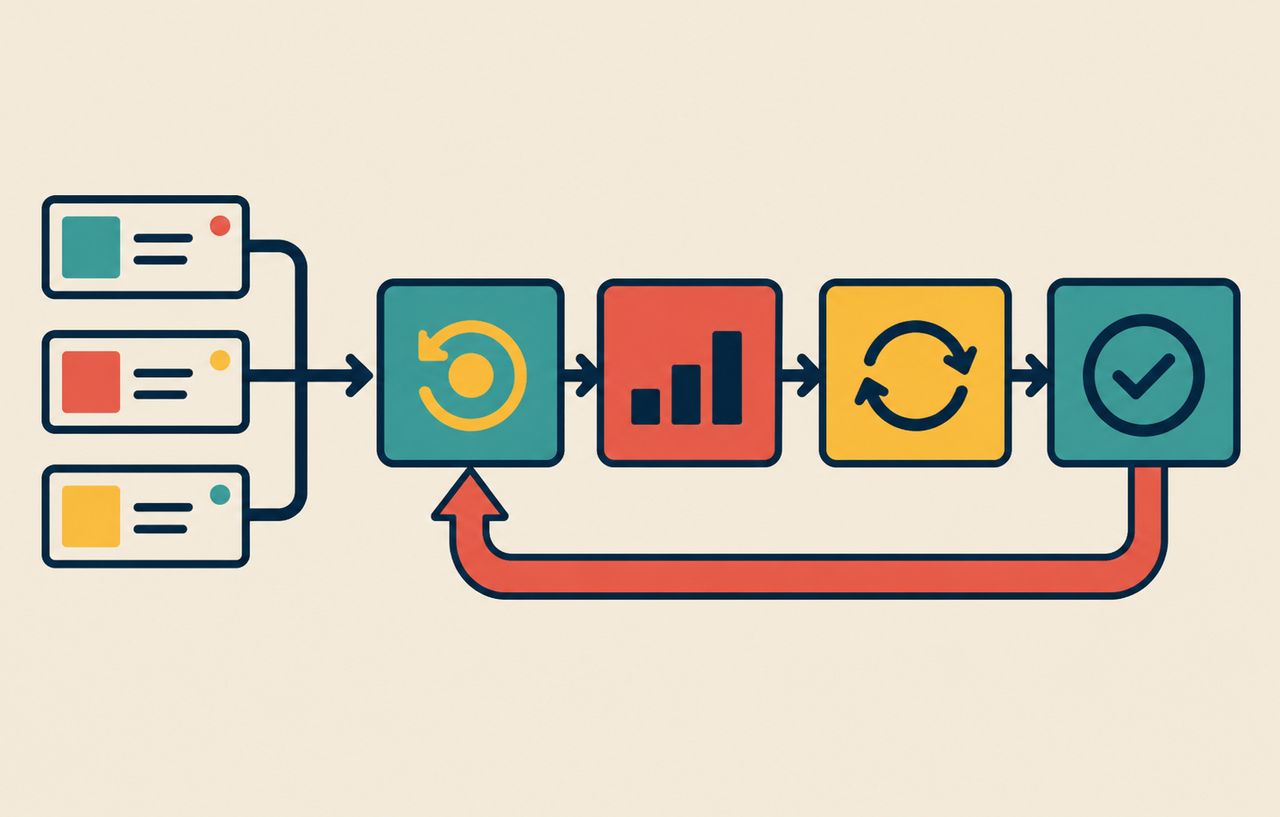
受け入れ試験には、通常のPDF、正しいパスワードで復号するPDF、パスワードが不正なPDF、相互参照ストリームを使う正常文書を含めます。復号後のページ数とページラベルが期待どおりか、抽出内容が欠けないか、エラー時に後続処理へ進まないかを確認します。開発元PRの回帰テストも修正意図の確認に使えますが、自社サービスの処理経路まで保証するものではありません。
資源上限や強制停止の試験は許可されたで行い、主プロセスが応答を返せること、子プロセスが終了すること、次の正常ジョブが進むことを見ます。同じ入力が失敗を繰り返す場合は、ファイル単位の識別子と試行回数で隔離し、自動再試行による負荷の反復を止めます。ここに示す試験は提案であり、筆者が攻撃ファイルを用いて独自実測した結果ではありません。
6.21.4の追加修正と対応完了の判断
pypdf 6.21.4リリースには、ページツリーのflatten処理でコピーする属性数の制限、標準xrefテーブルのtrailer読込み時のEOF検出、DictionaryObjectの複製時のループ検出修正が掲載されています。これらを本稿の2件のCVEと同一と決めつけず、6.21.3の修正を含む後続版として導入可否を判断してください。最新版表示だけで、自社のPDFがすべて制限時間内に処理できると保証されるわけでもありません。
対応票には、PDF受付経路、実際のpypdf版とロード先、配備したイメージ、復号後のページ数確認、開く前から有効な資源制限、異常終了時の停止・隔離結果を残します。対象がない場合も、未導入なのか、外部PDFを渡さないのかを区別します。文書変換全体の分離を点検する際は、既報のUnRTFの文書変換とワーカー隔離の記事も参照できますが、UnRTFの更新でpypdfが直るわけではありません。
今回の判断点は、ページ数を返す処理やPDFを開く処理も攻撃対象になり得ることです。6.21.3より前の稼働版を残さず、6.21.4など修正を含む版の動作を確認し、解析の最初から資源上限が働く構成へ見直してください。
出典・一次情報
本記事は以下の公開情報をもとに作成しています。最新の状況は各リンク先で確認してください。
-
公式アドバイザリ
-
公式アドバイザリ
-
公式アドバイザリ
-
公式アドバイザリ
-
公式アドバイザリ
-
公式アドバイザリ
-
CVE
-
CVE