目次
は2026年11月6日、Amazon ECSとAWS Fargateで動かすサーバーを介し、から企業のデータレイクへ接続する実装例を公開しました。要点は、データセットごとにツールコードを書くのではなく、表の意味や列の型、サンプル値、更新頻度をへ記述し、共通のMCPサーバーから検索・SQL生成・実行まで扱うことです。AthenaやRedshiftのデータを会話型AIへつなぎたい開発チームにとって、モデル選定より先に「データ追加をコード変更から切り離せるか」を判断する材料になります。
スポンサーリンク
今回公開された構成が解決する問題
AIエージェントを試作すると、最初は一つのと一つのアプリを直接つなぐ実装でも動きます。しかし、利用部門や表が増えると、各エージェントがSQL生成、説明、接続処理、権限判定を別々に持ち始めます。表定義の変更を複数のアプリへ反映し、同じ問い合わせに対する挙動を揃える作業が継続的に発生します。
AWSの事例では、AmazonのNorth America Sort Centerの計画担当者が運用データを会話で調べる用途を扱っています。公式記事によると、元のデータレイクには数千のデータセットがあり、従来は新しい表を追加するたびにツールコード、クエリ検証、再配備が必要でした。そこで、エージェントとデータ基盤の間に共通のMCPサーバーを置き、データセットの登録を設定ファイルの追加へ寄せています。
四つの層を分けて変更範囲を小さくする
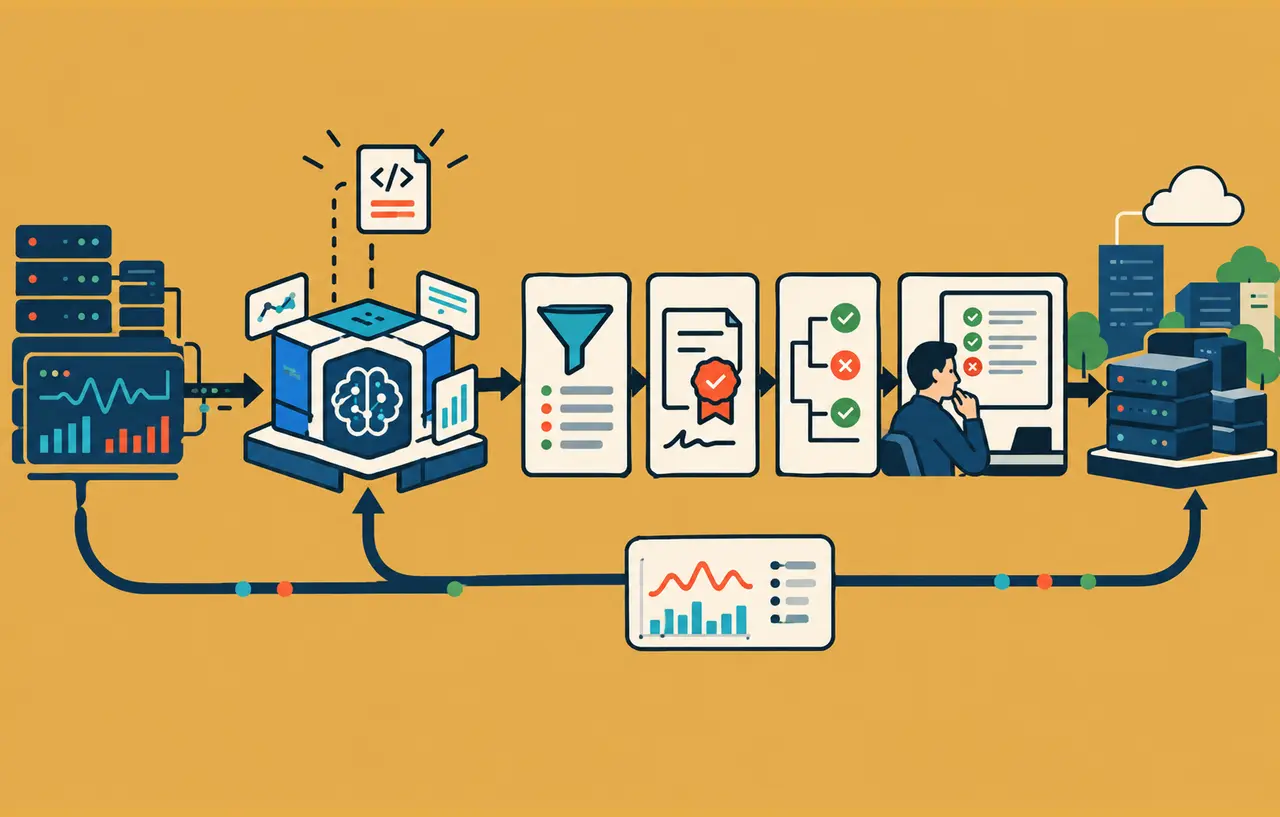
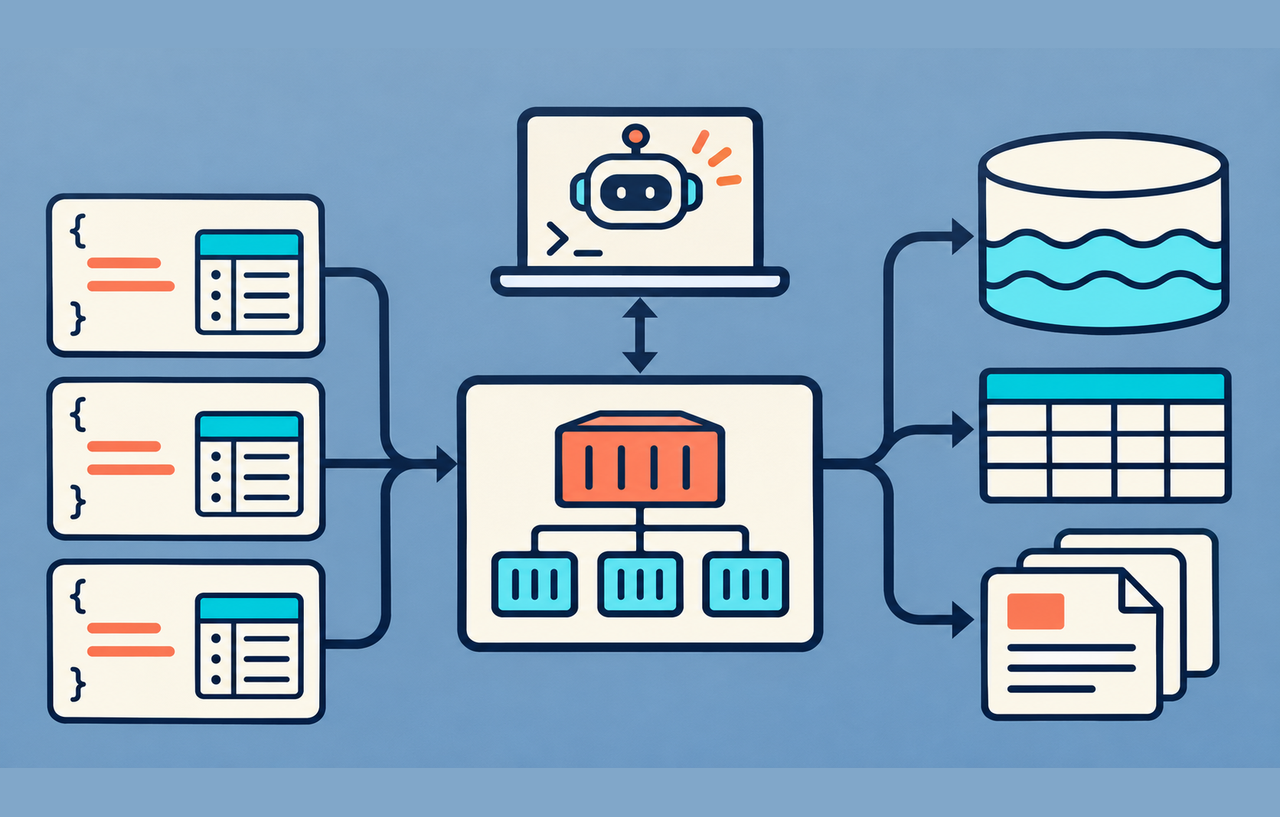
公開された構成は、クライアント、MCPサーバー、ツール、ナレッジベース更新の四層に分かれます。利用者の要求はRoute 53と公開Application Load Balancerを経てクライアント層へ届き、Amazon Cognitoでされます。クライアント層とMCPサーバー層は別のECS Fargateサービスとして動き、MCPサーバーはプライベートサブネット内の内部の背後に置かれます。
- クライアント層:認証済み利用者の要求を受け、DynamoDBに保存したと業務コンテキストを結び付ける
- MCPサーバー層:FastMCPのJSON-RPCでツールを公開し、Bedrockのモデルで選択と実行を統括する
- ツール層:Athena・RedshiftのSQL、文書との検索、業務ポリシー検索を共通ツールとして提供する
- 更新層:S3へ置いたメタデータを取り込み、埋め込みを生成してBedrock Knowledge Basesへ索引する
この分割の利点は、モデルやチャット画面を交換しても、データアクセスの実装を残しやすいことです。MCPはAIアプリケーションと外部データやツールを接続する公開仕様であり、クライアントは標準エンドポイントからツールを発見できます。公式事例ではAmazon Q Developerや拡張などの互換クライアントも接続先として挙げています。特定のエージェントに各データソースの処理を埋め込む構成より、変更の境界を明確にできます。
スポンサーリンク
JSONに何を保存するかが検索品質を左右する
メタデータJSONには、接続先サービス、データベース名、表名、表の業務説明、列名と型、列の説明、サンプル値、更新方式、更新頻度などを保存します。単にDDLをコピーするだけではありません。たとえば日時比較で文字列リテラルをdate()で包むといったエンジン固有のヒントを表の説明へ含め、倉庫IDには実際のコード形式をサンプル値として与えます。
列名だけでは、モデルは「東部倉庫」がFC-EAST-07のようなコードで保存されていると判断できません。サンプル値はWHERE句の形式を決める手掛かりになります。一方、サンプルへ顧客名や注文番号など実データをそのまま入れると、検索用索引に不要な情報を複製します。本番導入では、値の形式を伝える匿名化例を用意し、メタデータ自体の閲覧権限と保持期間を決める必要があります。
業務コンテキストの対応表も重要です。「配送指標」「人員計画」といった用途ごとに候補テーブルを限定すると、エージェントが全索引から似た列名を探す範囲を狭められます。AWSは、このスコープ指定がノイズを減らし、SQL生成の精度と待ち時間の改善につながると説明しています。公式事例で示された15〜20秒という応答時間は同社のテスト環境の結果であり、一般的な性能保証ではありません。自社では候補表数、クエリ実行時間、モデル待ち時間を分けて測るべきです。
問い合わせが回答になるまでの処理
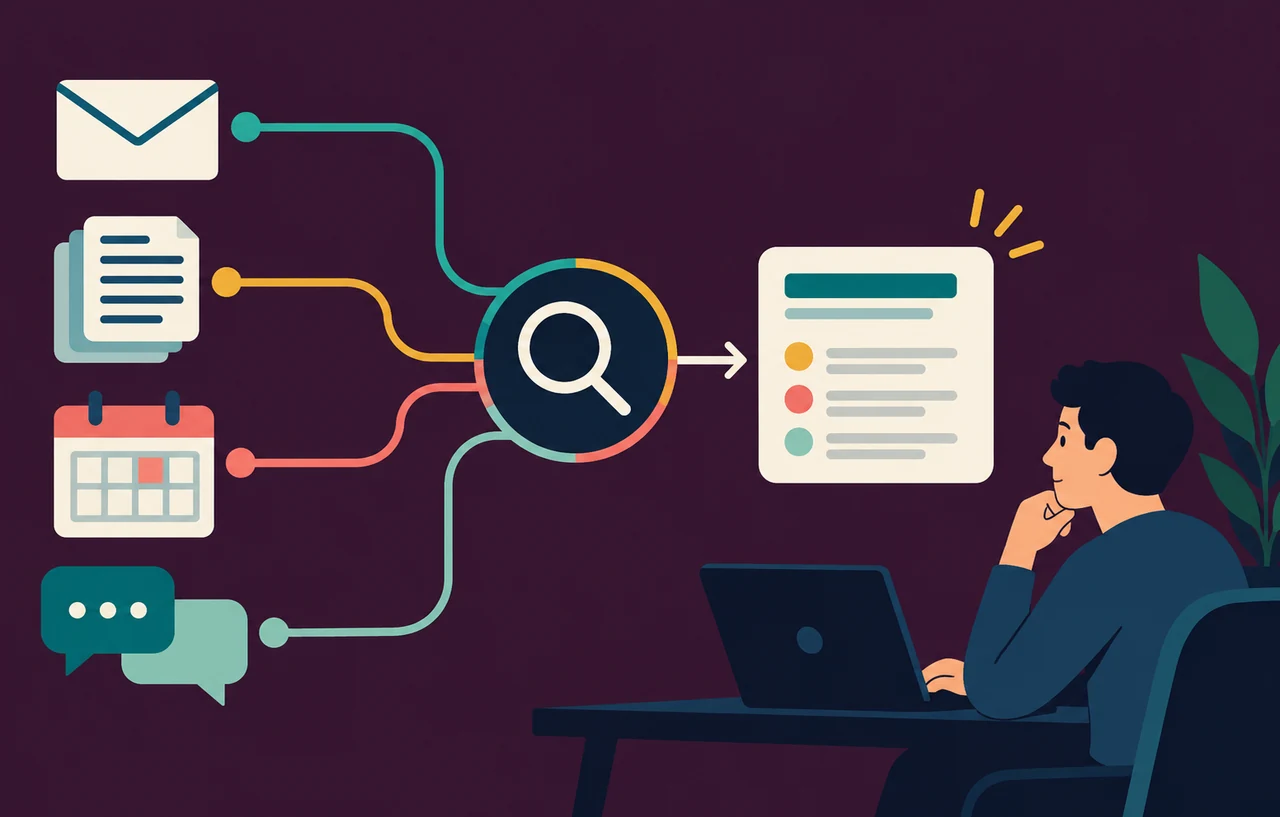
利用者が「先月の高額注文上位10件」を尋ねると、クライアント層が業務コンテキストを付与します。エージェントはメタデータカタログから関連する表を選び、列の説明とクエリヒントを参照してSQLを生成します。そのSQLをAthena向けに検証・補正し、実行結果を自然文へ整形して返します。文書検索も同じMCPサーバーのツールなので、数値はAthena、原因分析はKnowledge Basesから取得し、一つの応答にまとめる構成も可能です。
ここで、とSQLツールを同じものとして扱わないことが大切です。Knowledge Basesは文書やメタデータから関連情報を取り出す役割を持ち、Athenaは構造化データの集計を実行します。検索で見つけた説明をそのまま実績値として回答せず、数値が必要な要求はSQLの結果へ結び付けます。複合質問では、最終回答にどの部分がどのツールの結果かを記録できるよう、ID、生成SQL、参照文書、実行時刻を一つのトレースへまとめる設計が必要です。
スポンサーリンク
導入前に決める五つの境界
- 書き込みを許可するか:公式例のAthenaツールはSELECTだけを許可します。最初は読み取り専用に限定し、更新系は別ツールと承認フローへ分離します。
- 誰の権限で実行するか:ログイン済みというだけで全表を検索させず、利用者・所属・用途から参照可能なデータセットを決定します。
- セッションの責任範囲:Fargateタスクは交換されるため、会話状態をDynamoDBなど外部へ保存します。再送時に同じクエリを二重実行する条件も決めます。
- メタデータの所有者:表の説明や列の意味をデータ基盤チームだけで更新せず、業務部門のレビューと有効期限を設けます。
- 失敗の見せ方:SQL補正を無制限に繰り返さず、権限拒否、表未検出、構文エラー、実行上限を別の状態としてクライアントへ返します。
AWSの構成では、認証、プライベートネットワーク、AWS 、Bedrock Guardrails、SELECT限定、CloudWatchへの構造化ログを重ねています。ただしGuardrailsを適用すればデータ権限の設計が不要になるわけではありません。モデルへの入力制御と、Athena・Redshiftが実際に返せる行や列の制御は別の層です。特に複数部門で共有する場合は、コンテキストの絞り込みを権限判定の代わりにせず、実行基盤側でも許可を強制します。
小さく検証するための進め方
最初から数千表を登録せず、一つの業務領域と三〜五表に限定します。代表質問を、単純集計、期間比較、コード値の絞り込み、存在しない列への質問、権限外の質問に分けて用意します。各質問で、選択した表、生成SQL、補正回数、Athenaの走査量、回答までの時間、回答に含めた根拠を記録します。
次に、列説明を削った状態、サンプル値を追加した状態、業務コンテキストで候補表を限定した状態を比較します。正答率だけでなく、不要な表を選んだ割合、実行前に拒否できた危険なSQL、利用者が回答を採用できなかった理由を残します。メタデータ更新で改善できる失敗と、モデルやツール実装を直す必要がある失敗を分けると、運用担当者が毎回コードへ手を入れずに品質を上げられます。
配備手順にも確認点があります。新しいJSONを登録したら、取り込みジョブの成功だけで完了とせず、索引に反映された版と時刻を記録し、MCPクライアントから対象ツールを再発見します。旧スキーマのが残る状況を想定し、メタデータ版、クエリに使った版、回答のトレースを対応付けます。ではコンテナだけを戻しても索引が新しいままになるため、アプリとメタデータの戻し方を別々に用意します。
Fargateの採用判断では、EC2を管理しない利点だけで決めず、常時稼働タスク、ロードバランサー、DynamoDB、Knowledge Bases、埋め込み、Bedrock推論、Athena走査の費用を合算します。低頻度のでも、クライアント層とMCPサーバー層を常時維持すれば固定的な費用が生じます。Auto Scalingの指標もCPUだけでなく、同時セッション数、処理中ツール数、キュー待ち時間を観測し、自社のボトルネックに合わせます。
この構成が向くチーム、向かないチーム
複数のAIアプリから同じデータレイクを参照し、データセットの追加が継続するチームには、共通MCPサーバーとメタデータカタログの分離が有効です。モデルやクライアントを替えても、ツール定義と監査点を共有できます。一方、一つの小規模アプリが固定された一表だけを読む場合は、四層の構成が運用負担を増やす可能性があります。直接の方が障害点と費用を抑えられるケースもあります。
今回の実装例から持ち帰るべき点は、Fargateそのものより「データ接続をエージェントから分離し、データの意味を設定として管理する」という設計です。まずは読み取り専用の限定領域で、JSONを更新したときに対象表が正しく発見され、古い定義が残らず、権限外の要求が実行前に止まることを確かめます。その検証が通ってから、接続するエージェントやデータセットを増やすのが現実的です。
関連記事
スポンサーリンク